2026 年的大模型战场,KV 缓存(Key-Value Cache)已经从底层工程技术,变成决定上下文长度、推理成本、Agent 商业模式的核心资源。DeepSeek V4 把 KV 缓存体积压缩 90%、上下文拉到 1M 全系标配、命中价打到 1 折;Anthropic 用 cache_control 把缓存做成可预测的企业契约;OpenAI 把自动缓存藏在 API 后面默打 5 折;Google CachedContent API 给企业级长素材复用做了对象化抽象。 同样叫 KV 缓存,六家路径完全不同。本文从架构层(注意力机制怎么压缩 KV)到 API 层(命中怎么识别、怎么计费)逐项拆解 DeepSeek V4、Claude 4.7、GPT-5、Gemini 3、Llama 4、Grok 4 的实现差异,并给出不同场景的选型建议。 一、KV 缓存到底是什么?为什么 2026 年所有人都在聊
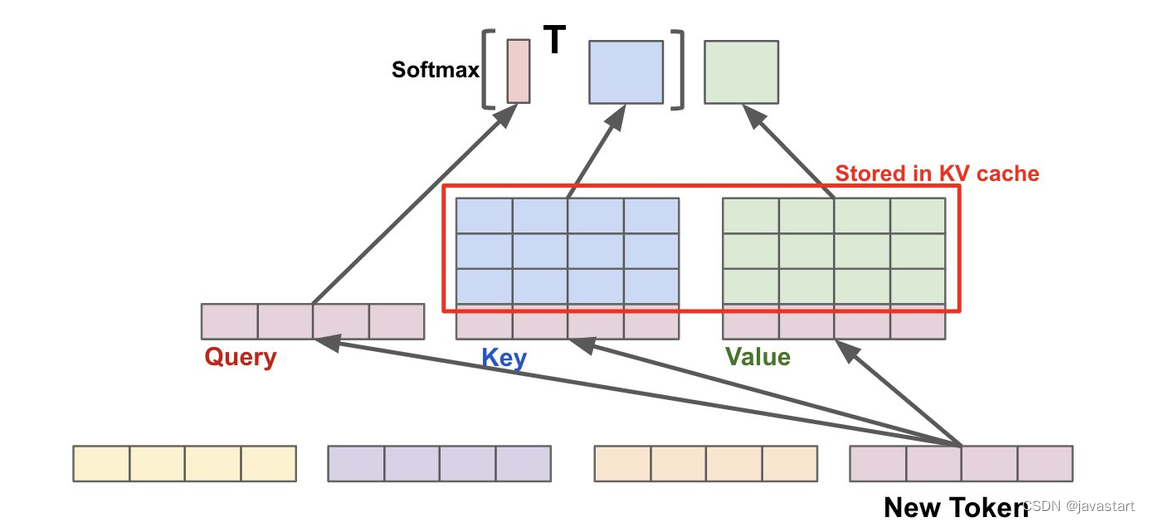
KV 缓存的机制本身不复杂。Transformer 自回归生成时,每生成一个 token 都需要对前面所有 token 做注意力计算。若不缓存,每一步都要重算整段历史的 K、V 张量,复杂度 O(n²)。开启 KV 缓存后,前面 token 的 K/V 直接从缓存读,新 token 只需算自己那一份,复杂度降到 O(n)。这个技术从 GPT-2 时代就存在,但在 2024-2026 年突然成为产业焦点,原因是它从"推理优化"升级为"商业瓶颈"。
第一是上下文长度的军备竞赛。 Gemini 2M、DeepSeek V4 的 1M、Llama 4 的 10M 标称——背后都是 KV 缓存的工程问题。一个 70B 模型在 128K 上下文下,未经压缩的 KV 缓存能占几十 GB 显存,比模型参数本身还重。没有架构层的压缩方案,"百万上下文"就只是 PPT 数字。
第二是 Agent 应用的结构性需求。 ReAct 循环、多轮工具调用、Computer Use、Claude Code 这类工作流都是"前缀长、追加短"的模式——同一段 system prompt + 历史对话被反复送进模型。Prompt Caching 由此成为可计价资源:四家头部厂商都把缓存命中部分单独定价,命中折扣从 1 折到 5 折不等,直接重写了 Agent 应用的单位经济模型。 第三是架构层突破密集出现。 DeepSeek V2 的 MLA、V3 的 DSA 稀疏注意力、V4 的 CSA/HCA 混合注意力,把 KV 缓存压到原来的 1/10 甚至更低;Llama 4 的混合稀疏 + iRoPE 撑出 10M 标称窗口;vLLM 的 PagedAttention 用操作系统分页思路管理 KV 内存;FP8/INT4 的 KV 量化让端侧部署成为可能。每一项都直接影响推理吞吐和上下文上限。
二、架构层方案对比:从 MHA 到 MLA 的演化路径
KV 缓存的体积公式是: 2 × 层数 × 头数 × head_dim × 序列长度。所有架构优化都是冲这个公式去的。
MHA(Multi-head Attention) 是基线方案。每个注意力头有独立的 K/V,缓存最大、表达能力最强。GPT-3、早期 Llama 是这条路线,现在主流模型已基本不用纯 MHA。
GQA(Grouped Query Attention) 是当前最主流方案。把 query head 分组,每组共享一份 K/V——比如 32 个 query head 分 8 组共享 KV,缓存直接减到 1/4。Llama 3/4、Qwen、Mistral、推测的 Claude 和 GPT 都在 GQA 这条路上。精度损失可忽略,工程实现简单,是稳健的工业标准。
MQA(Multi-Query Attention) 是 GQA 的极端版,所有 head 共享一组 KV。缓存最小但精度损失明显,PaLM 和早期 Falcon 用过,现已基本被 GQA 取代。
MLA(Multi-head Latent Attention) 是 DeepSeek V2 提出、V3/V4 持续打磨的核心创新。把 K 和 V 投影到低秩潜空间,缓存里只存潜向量,推理时再解压回完整 K/V。等价于一个隐式的低秩分解,缓存量级能压到 GQA 的 1/4 到 1/10。代价是训练侧工程复杂度更高。V4 的 KV 缓存比 V3.2 减少 90%,主要靠这条路线。
Sliding Window Attention 是 Mistral 的招牌方案,每个 token 只看前 N 个 token,KV 缓存与序列长度解耦。代价是丢失真正的长程依赖,所以更多作为混合架构里的一个组件出现。
稀疏注意力 是 2025-2026 年最活跃的方向。DeepSeek V3.2 的 DSA(DeepSeek Sparse Attention)按重要性动态选择历史 token;V4 在此基础上做 CSA/HCA 混合,把全局注意力和局部窗口分层处理;Llama 4 的混合稀疏 + chunked attention 是同类思路。本质都是承认"对所有历史 token 同等对待"在百万级上下文下不经济。
SSM(State Space Model) 是完全不用 KV 缓存的路线,Mamba 系列用固定大小的隐藏状态替代 KV,理论上序列长度无限。纯 SSM 在某些任务上不如 attention,所以现实里多以混合架构出现(Jamba、部分研究模型),目前未成主流。
三、顶尖模型 KV 缓存架构逐家拆解
DeepSeek V4(Pro / Flash)
V4 是当前架构压缩最激进的模型。MLA 路线从 V2 走到 V4 已经三代打磨,V4 进一步叠加 CSA/HCA 混合注意力——全局注意力捕捉长程依赖、局部窗口处理近邻信息、不同层用不同粒度的 KV 表示。结合 DeepSeekMoE、Muon 优化器、FP4 QAT 量化训练、上下文并行、异构 KV 缓存(部分热数据在显存、冷数据落盘)等组合优化,最终实现:相比 V3.2 推理 FLOPs 降低 73%、KV 缓存大小减少 90%、1M 上下文全系标配且关键信息检索准确率 ≥99.2%。Flash 版 284B 总参数 / 13B 激活;Pro 版总参数约 1.6T、激活 370B。
Claude 4.7 系列
Anthropic 没公开自家模型架构细节。从长上下文吞吐曲线、200K 窗口的显存占用量级、Sonnet/Opus/Haiku 的速度梯度推断,主体很可能是 GQA + 某种局部/稀疏注意力的混合方案,但具体分组数、是否有 sliding window、是否上 MLA 类压缩,外部都不知道。Anthropic 的强项不在公开架构,而在工程确定性。
GPT-5 / o 系列
OpenAI 从 GPT-4 之后基本完全封闭。可确认的事实有限:GPT-4 时代是 MoE(多方泄露佐证),GPT-5 推测延续并扩大 MoE 规模;o 系列推理模型在长 reasoning chain 下的吞吐表现,暗示有专门为长生成做的 KV 优化(推测包括 KV 量化、token 重要性筛选)。架构细节属于行业内最封闭的一档。
Gemini 3 系列
Gemini 是顶尖梯队里架构信息相对透明的。Gemini 1.5 的技术报告明确披露用了混合专家 + 多种长上下文优化的组合;从 1M 扩展到 2M 上下文的过程中,Google 公开过 ring attention、sequence parallelism 等分布式注意力技术——KV 缓存被切到多个 TPU 上协同计算。这条路线和 DeepSeek 不同:Google 用海量 TPU + 分布式系统硬扛,DeepSeek 用架构压缩省下算力。多模态方面,Gemini 把视频帧、图像、音频 token 都进同一套 KV 缓存,attention 架构必须对异构 token 都高效。
Llama 4 系列
Llama 是顶尖梯队里唯一开源的,架构完全透明。在 Llama 3 的 GQA 基础上,Llama 4 加入更激进的混合架构——部分层全注意力、部分层 chunked attention、部分用 sliding window,思路上和 DeepSeek 的 CSA/HCA 异曲同工。还引入了 iRoPE(interleaved RoPE,部分层去掉位置编码、部分层保留 RoPE)来支撑长上下文。10M 标称窗口靠这套机制撑出来,但实际可用区间仍要看具体任务。
Grok 4 系列
Grok 1 当年开源过权重,是标准 MoE + GQA。Grok 4 没开源,但从 API 行为和延迟特征推测仍以 GQA 为主,没有走 MLA 这条激进路线的迹象。Grok 在长上下文上的投入相对克制,主力上下文窗口比 Gemini 和 Claude 短,KV 缓存的工程压力相对较轻。
四、API 缓存计费层:四家命中机制全对比
架构层决定 KV 缓存能不能被便宜地存下来,API 层决定存下来能不能被便宜地复用。
Anthropic:显式控制 + 强契约
开发者在 messages 里给特定段落打 cache_control 标记,命中粒度在 Sonnet 上是 1024 tokens 起步、Opus 和 Haiku 是 2048 tokens 起步。TTL 默认 5 分钟、可选 1 小时(更贵)。计费上写入付原价的 1.25 倍,命中读取打 1 折。优势是行为完全可预测,企业级 Agent 能精确算账;劣势是开发者要自己设计缓存边界。和 Claude Code 这种深度依赖前缀复用的产品配合极好——缓存命中率是产品形态主动优化出来的。
OpenAI:自动缓存 + 温和折扣
请求进来后系统自动比对前缀,前 1024 tokens 完全一致开始命中,按 128 tokens 递增。命中折扣 GPT 系列约 5 折、推理模型 o 系列折扣更大。TTL 通常 5-10 分钟,闲时可能延长。不需要任何标记。优势是零接入成本,劣势是折扣力度比 Anthropic 和 DeepSeek 都小。注意 o 系列推理模型的 reasoning tokens 不计入缓存——OpenAI 的缓存基于明文前缀,对模型内部生成的中间 reasoning 没法跨请求复用。
Google Gemini:对象抽象 + 大颗粒
提供 CachedContent API,开发者主动创建缓存对象、设定 TTL、显式引用。最小缓存单元在 1.5 Pro 上是 32K tokens(门槛较高),命中后费用大幅减免,但要付每小时的存储费。这套设计明显是给"一次性上传一段长视频或一本书反复查询"的企业级场景做的——颗粒度大、确定性强、按时计费。
DeepSeek:自动缓存 + 硬盘介质 + 极致价格
Context Caching on Disk 是 DeepSeek 的招牌——和其他三家用 GPU 显存或高速存储不同,DeepSeek 把缓存做到分布式硬盘,介质成本低三四个数量级,所以敢把命中价压到 1 折。粒度 64 tokens(四家最细),完全自动匹配前缀,写入不加价。TTL 动态在几小时到几天之间。优势是单价极致,劣势是 TTL 不可控、首次命中有硬盘冷读延迟。返回结果会带 prompt_cache_hit_tokens 和 prompt_cache_miss_tokens 字段,能精确看到命中量。
五、价格、粒度、TTL 横向 Benchmark
把四家的核心指标放一起:
几个关键结论:单价最低是 DeepSeek,1 折 + 硬盘 + 64 tokens 细粒度把成本压到天花板;确定性最强是 Anthropic,显式标记 + 严格 TTL 适配企业 SLA;颗粒度最大是 Google,32K 起步意味着只有"长素材重复查询"场景适合;工程友好度最均衡是 OpenAI,零标记 + 温和折扣新接入门槛最低。
六、能力维度横向对比:除了缓存还看什么
KV 缓存只是大模型推理的一环。同等关注的还有上下文窗口、多模态、Agent 工具链、企业合规。
上下文窗口: Gemini 3(2M+) > Llama 4(10M 标称、实际看任务) > DeepSeek V4(1M) > Claude 4.7(200K,部分到 1M) > GPT-5(主力 200K) > Grok 4(标称 256K) > Mistral Large(128K)。DeepSeek V4 的 1M 已经追平第一梯队。
多模态: Gemini 第一档(视频/图像/音频原生);GPT-5、Claude 4.7、Grok 4 支持图像;Llama 4 多模态版本支持图像;DeepSeek V4 当前为纯文本,这是它与第一梯队最显著的结构性差距。
Agent 工具链: Anthropic 有 Claude Code、Computer Use、MCP 协议;OpenAI 有 Assistants API、Realtime API、Apps SDK;Google 有 Vertex AI 全栈;DeepSeek V4 原生 Function Calling 错误率从 V3 的 15% 降到 2% 以下,但缺自家 Agent 框架或 IDE 集成产品。
企业合规: Anthropic、OpenAI、Google 提供 SOC2、HIPAA、ZDR 等合规承诺和多区域部署;DeepSeek 在企业合规和全球部署上仍在追赶。
七、不同场景的选型建议
长 system prompt 的 Agent 应用(工具说明 + 角色设定 + 历史对话):首选 Anthropic + cache_control 显式控制,命中行为可预测,1 小时 TTL 适配中等热度场景;成本敏感选 DeepSeek,1 折命中 + 64 tokens 细粒度,代价是 TTL 不可控。
多轮对话产品(聊天机器人、客服):OpenAI 自动缓存最省事,无需任何改造;DeepSeek 价格更低但需保证消息拼接顺序稳定,否则缓存全废。
长文档 / 整库代码分析:Gemini CachedContent + 长上下文窗口是标准答案——上传一次、反复查询、按小时付存储费;DeepSeek V4 的 1M 上下文是性价比替代;Claude 200K 窗口下做长文档要做拆分。
多模态 / 视频处理:Gemini 几乎独家——视频帧进 KV 缓存、CachedContent 复用;GPT-5 和 Claude 处理图像但不是视频原生;DeepSeek V4 当前不能进入这个场景。
成本敏感的批量任务(数据处理、批量摘要、内容生产):DeepSeek V4 Flash + 缓存命中是当前最低 TCO;Llama 4 自部署是另一条路,配合 vLLM 的 prefix cache 能做到接近免费的前缀复用。
企业级生产环境(合规、SLA、多区域):Anthropic、OpenAI、Google 三选一,按现有云栈和合规要求决定;DeepSeek 当前不适合作为唯一供应商,可作为成本敏感场景的辅助。
端侧 / 私有部署:Llama 4 是事实标准,开源权重 + 完整社区生态;DeepSeek V4 权重也开源但部署门槛更高(MoE 架构对推理框架要求更挑剔)。
局限与下一步关注点
本文的架构层信息有相当一部分来自论文、第三方逆向、行为推测,闭源模型的真实细节只有厂商内部清楚,误差不可避免。API 计费机制以官方文档为准,但具体折扣、TTL、粒度可能随版本调整,接入前以最新文档为准。文中的 Benchmark 对比基于公开信息和合理推断,实际生产环境表现还需结合具体负载测试。
下一年最值得跟的方向有四个:跨请求、跨用户的全局缓存调度(vLLM prefix cache、SGLang RadixAttention 已在开源框架落地,闭源大厂应有更激进方案);稀疏 KV 的进一步演化(H2O、SnapKV 这一系按重要性丢弃 KV 的工作);分层量化(重要层 FP16、其他 INT4);以及 Mamba 类架构是否能真正绕开 KV 缓存的内存增长问题。
KV 缓存这个看似底层的工程话题,本质是大模型推理经济模型的支点。架构层决定 KV 能不能存得下,API 层决定存下来能不能复用得起,两层都做扎实的厂商,才能在 Agent 时代的成本竞争里建立真正的护城河。
 AI 速览