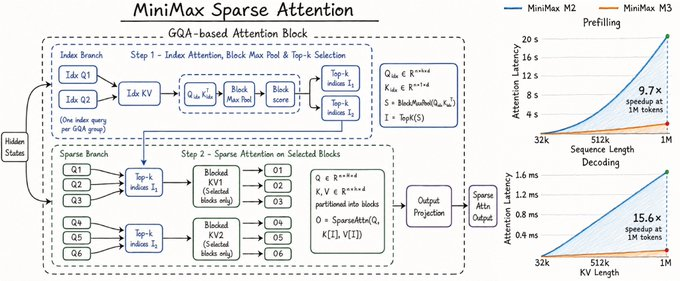
5月27日消息,MiniMax 正式预览 M3 模型并公布其稀疏注意力架构细节。在 100 万 token 上下文条件下,M3 相比上一代 M2 实现 9.7 倍预填充加速与 15.6 倍解码加速。这一数据意味着 MiniMax 在长上下文推理效率的工程化问题上完成关键突破,长上下文 Agent 与本地/边缘部署场景的算力门槛被显著降低。
从 Lightning 到回归 Full 再到 Sparse 的架构回路
M3 的发布需要放在 MiniMax 自身的注意力机制演化路径里读才能看清意义。MiniMax-Text-01 于去年 1 月首次引入 Lightning Attention,采用每 8 层中 7 层使用 Lightning Attention(一种线性注意力变种)配 1 层标准 softmax 的混合架构,在 456B 总参数、45.9B 激活的 MoE 配置下原生支持 100 万 token 上下文。M1 沿用同一架构,将该路线推到推理模型上。
但 M2 系列在去年底悄然回归全注意力——原因是 efficient attention 当时尚未达到 production-ready 标准,无法在真实流量下稳定跑通。代价是上下文窗口从 1M 缩到 205K,M2.1、M2.5、M2.7 一系列后续版本都维持在这一水平。M3 用稀疏注意力重新拿回 1M context,意味着 MiniMax 在「线性/稀疏注意力的工业级落地」上走完了从激进尝试、产品回撤、技术重做、再次推上生产线的完整闭环。这是一条很多实验室都试过但少有人完整走通的工程路径。
值得说明的是,稀疏注意力与 M1 时代的 Lightning Attention 并不是同一条技术路线。Lightning Attention 属于线性注意力家族,理论复杂度从平方降到线性;稀疏注意力则在保留 softmax 注意力数学性质的前提下,通过限制每个 token 的注意范围达到 subquadratic 复杂度。两者在长程精度、训练稳定性、KV cache 行为上有不同的工程取舍。
9.7× 与 15.6× 对长上下文 Agent 的真实意义
加速倍数需要拆开两段读。预填充阶段处理的是输入上下文的初次编码,对长上下文场景而言这是延迟主要来源——当用户把整个代码仓库、研究报告或多轮对话历史一次性塞给模型时,预填充耗时决定首 token 延迟。9.7 倍的预填充加速直接对应「百万 token 输入下首字响应时间从分钟级压回秒级」的体验差。
解码阶段则决定 token 生成速度。15.6 倍的解码加速对应的是长生成任务的吞吐——比如让 Agent 写一份基于 80 万 token 调研材料的深度报告、或者让 Coding Agent 跨多个文件做大规模重构。在长 context + 长 generation 同时存在的 Agentic 任务里,这两个数字相乘会让端到端时延出现量级跃迁。
更关键的是边缘与本地推理。1M context 下的常规 softmax 注意力 KV cache 占用极其昂贵,按 vLLM 在 M2 上的部署经验,96G×4 GPU 的 KV cache 总容量只够撑 400K token、144G×8 GPU 能到 3M token。稀疏注意力直接压缩了 KV cache 的实际占用,让中等规模显存配置承载 1M context 推理成为可能,这对自建推理、私有部署、Agent 框架在 VPS 上跑长上下文任务都有直接价值。
与稀疏注意力赛道其他玩家的位置
2025 年下半年到现在,国产模型集体把注意力机制创新作为长上下文方向的主战场。DeepSeek V3.2 引入 subquadratic 稀疏注意力机制,Qwen3-Next 与 Kimi Linear 走线性注意力路线,GLM-5 则将稀疏注意力与名为 Slime 的异步强化学习框架结合,在 28.5T token 上训练出 355B-744B 参数、40B 激活的模型,原生支持 1M 上下文,并在 SWE-bench Verified 拿到 77.8、Terminal Bench 2.0 拿到 56.2。 M3 preview 公布的数据只对比了自家 M2,没有给出与 DeepSeek V3.2、GLM-5、Kimi Linear 在 SWE-Bench、Terminal Bench、长上下文 RAG 等基准上的横向结果,也未披露 M3 的参数规模、激活参数量、训练 token 总量。在「同代际之间究竟谁的稀疏注意力做得更扎实」这个核心问题上,M3 暂时只交出了相对自身的加速比。社区评测、第三方榜单、生产环境部署反馈仍需要正式发布后才能展开。
Hailuo3将和M3 同步发布
另外,我们已经确认一条的消息:MiniMax 旗下视频生成模型 Hailuo3 会与 M3 同步发布,形成跨模态的产品组合发布节奏。如果属实,这将是 MiniMax 第一次把语言模型与视频模型的发布周期完全对齐,对正在推进 story-to-video pipeline 的开发者群体意义不小——长上下文语言模型负责剧本与分镜推理、视频模型负责画面落地,两端在同一时间窗口完成迭代有利于工程链路的整体校准。但 Hailuo3 的技术规格、发布时间、与 Sora、Veo 3、Kling 2.5 的对位关系都未见官方口径,目前仍属市场层面的预期。 局限与待验证项
M3 当前为 preview 状态,几项关键信息缺位。其一,benchmark 仅对比 M2 自身,加速比是「相对值」而非「行业绝对水位」。9.7× 与 15.6× 的基线是 M2 的 1M context 推理,但 M2 本身回归 full attention 后并非长上下文场景的优化目标,基线性能本就不高。其二,稀疏注意力天然在长程精度上有取舍空间,模型在「大海捞针」「跨百万 token 推理链」等深度长上下文任务上的实际表现,需要等正式版本与公开评测出来才能定论。其三,长上下文 Agent 的真实瓶颈往往不是 attention,而是 KV cache 管理、prefix caching 命中率、tool use 在长 context 下的稳定性——这些工程层问题 preview 公告未触及。
对开发者侧,M3 给出的信号是清晰的:MiniMax 在过去半年「M2 系列做编码与办公场景、维持中等 context」的产品节奏之后,正在用 M3 把战线推回长上下文与超长推理。正式版本与 GLM-5、DeepSeek V3.2、Kimi 系列在 SWE-Bench Verified、Terminal Bench、长上下文 Agentic 任务上的横向对比,将是接下来一两个月最值得追踪的看点。
 AI 速览