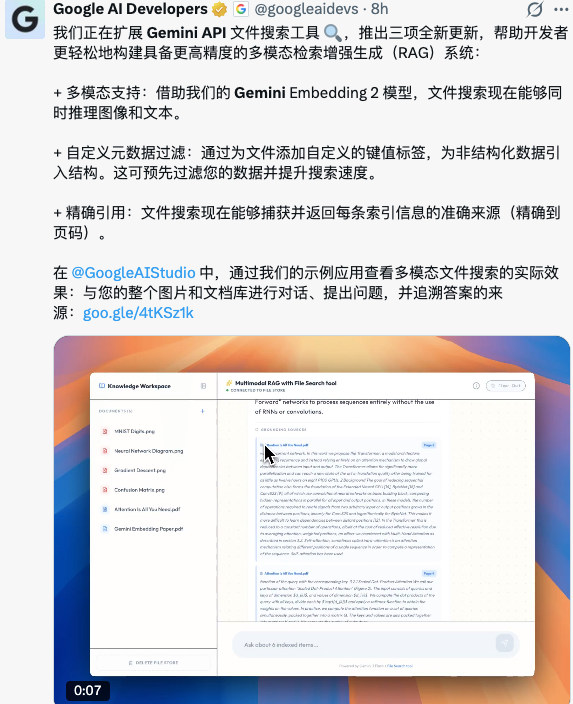
5月6日消息,Google 为 Gemini API 的文件搜索(File Search)工具推出三项核心更新,覆盖从检索能力到溯源精度的完整链路:基于 gemini-embedding-2 原生多模态模型实现的图文统一向量化、自定义元数据支持对文件池做细粒度过滤,以及 grounding metadata 中新增的页码回链与图片溯源能力。三项更新同步上线 Gemini API 及 Google AI Studio,已向所有 API 用户开放。 产品机制
多模态嵌入:图像不再需要 OCR
Gemini File Search 此前仅支持文本嵌入(gemini-embedding-001),用户若想对 PDF 中的图片做检索,需自行 OCR 转文本后再入库。这次更新的关键变化是 embedding_model 参数可切换至 models/gemini-embedding-2——这是 Google 首个原生多模态嵌入模型,能将文本与图像(PNG/JPEG)统一映射到同一向量空间。 具体流程为:创建 FileSearchStore 时指定 embedding_model: "models/gemini-embedding-2",随后通过 uploadToFileSearchStore 或 importFile API 上传文件。系统自动对文件分块、生成多模态嵌入并建立索引。查询时无需区分内容模态,File Search 工具在图文混合的文档库中同时检索文本片段和图像块,返回最相关的语义匹配结果。
图片文件要求:分辨率上限 4K×4K,每请求最多 6 张图片,支持格式为 PNG、JPEG。音频和视频目前仍不支持。
自定义元数据过滤:从全库搜索到桶内精筛
当 FileSearchStore 内积累大量文档后,全库搜索的精确度会下降。新引入的 custom_metadata 和 metadata_filter 参数解决了这一问题:上传文件时可附加键值对——字符串或数值——查询时通过 metadata_filter 参数做条件筛选,例如只搜索 category="footwear" AND season="spring-2026" 的文件子集。
Google 使用的过滤条件语法基于 google.aip.dev/160,支持等于、不等于、范围比较等操作符。该能力在内置 RAG 场景下意义明显:当企业将产品目录、技术文档、合规文件存储在同一个 FileSearchStore 时,可按维度精准限定搜索范围,而非对所有文档做批量语义检索。
精确引用回链:含页码与图片下载
Grounding metadata 中的 retrieved_context 对象新增两个属性:
- page_number:对 PDF 等多页文档,直接返回源信息所在的具体页码。通过 response.grounding_metadata.grounding_chunks[i].retrieved_context.page_number 获取。
- media_id:当模型引用的是图像块时,返回该图像的唯一标识,开发者可通过 file_search_stores.download_media() 直接下载被引用的图片块,实现视觉层面的可验证溯源。
此外,Gemini 3 系列模型支持将 File Search 与结构化输出(JSON Schema)配合使用,开发者可定义输出格式约束,让 RAG 应用的响应更可靠。
竞品观察
当前主流平台中,OpenAI 的 Retrieval Augmented Generation(RAG)工具同样支持多模态文件(文本+图片),但在 grounding 层面默认返回源文件路径而非精确页/图级引用;Anthropic 的 Tool Use + 自定义知识库方案在元数据过滤层面支持类似筛选,但其文件上传后的嵌入模型不可选(固定为内部的纯文本嵌入),且目前不支持多模态向量检索。
三家取向不同:OpenAI 在工具易用性和生态集成上占优,Anthropic 在安全护栏和可控性上更深入,Google 的差异化在于嵌入模型的可选性(gemini-embedding-001 vs gemini-embedding-2),以及 grounding 元数据的字段粒度(页码 + media_id)。企业级 RAG 选型时,按溯源精度、模态覆盖与成本结构三轴交叉组合更为常见。
局限性与需要关注的
音频和视频暂不支持:gemini-embedding-2 模型本身已具备多模态能力,但 File Search 工具在发布时仅覆盖文本与图像,音频和视频格式的文件搜索被列明为「目前不支持」,这在本土的多模态 RAG(如客服录音检索、视频片段定位)中是一个显著缺口。
批量嵌入成本需估算:虽然查询阶段的存储与嵌入免费,但首次索引嵌入仍按量收费。企业用户在将历史文档全量迁移至 FileSearchStore 前,建议先按文档总量与分块数估算一次嵌入费用,避免批量操作后意外超支。
文件 48 小时自动删除:通过 File API 上传后导入 FileSearchStore 的原始文件,在 48 小时后会被自动删除(嵌入数据保留)。开发者需要自行维护原始文件副本或迁移流程,否则在重新索引或嵌入模型更新时可能丢失原始文件。
Google Gemini API File Search 的相关文档、价格与示例代码已更新至 ai.google.dev/gemini-api/docs/file-search,可以通过 Google AI Studio 直接体验。所有功能细节以官方最新说明为准。
 AI 速览