8月8日消息,MiniMax H3 团队在 Reddit r/StableDiffusion 社区举行的 AMA 中确认,公司正在开发一款同时支持文生图(T2I)与通用图片编辑的专用图像模型,计划开放权重,目前处于后训练优化阶段。模型名称与发布时间目前均未披露。
专门的图像模型:文生图与图片编辑放进同一个模型
H3 是 MiniMax 于7月31日发布的全模态视频生成模型,可同时理解文本、图像、视频和音频组成的上下文,输出最高 2K 分辨率、最长 15 秒、带原生双声道的视频,权重以 Community License 形式开放。8月7日晚,H3 团队在 r/StableDiffusion 举行 AMA,研究负责人 dacongya、研究员 Luigi、Nero、Kiro、系统工程师 Reynor 与开发者关系负责人 Ryanlee 参与,帖子累计超过 300 条评论。
面对"是否会推出文生图或图生图模型"的提问,dacongya 回应:团队计划开源一个统一模型,同时支持文生图与通用图片编辑,它与 H3 共享同一基础,目前正在优化其后训练阶段。这是 H3 开放权重以来,团队首次公开确认专门的图像模型计划。
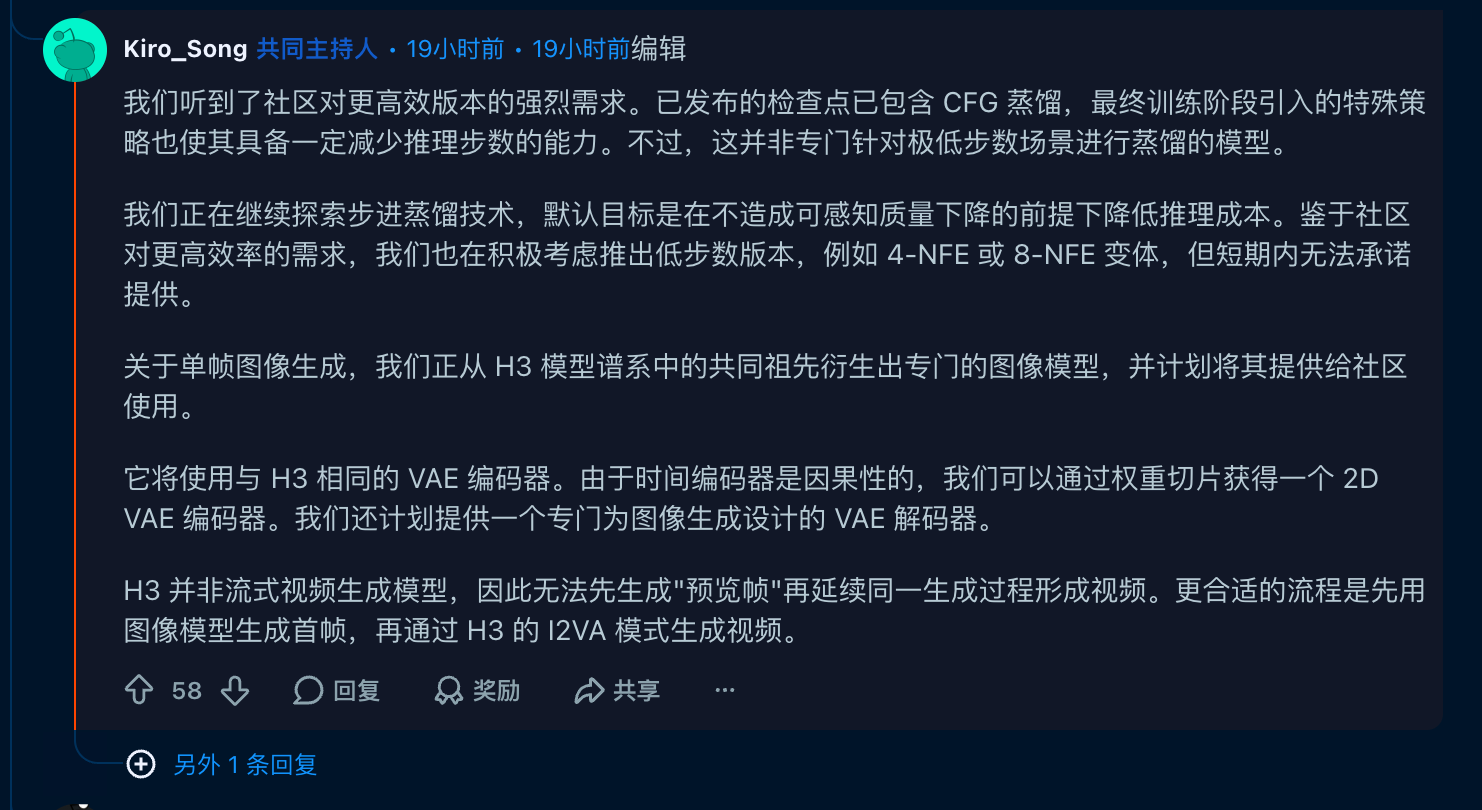
研究员 Kiro 补充了技术路线。图像模型从 H3 模型谱系中的共同祖先模型派生,沿用 H3 的 VAE 编码器。由于 H3 的时序编码器是因果的,团队可以通过权重切片获得二维 VAE 编码器,并为图像生成单独设计一个 VAE 解码器。
官方工作流:图像模型生成首帧,H3 续成视频
Kiro 同时澄清了一个能力边界:H3 不是流式视频生成模型,无法先生成"预览首帧",再在同一次生成过程中无缝续成视频。官方认为更合理的工作流是:先用即将到来的图像模型生成首帧,再把这张图交给 H3 的 I2VA 模式完成视频生成。图像模型与 H3 由此构成一条前后衔接的生成链路。
零样本实验:社区用法背后的依据
开发者此前发现,H3 已经隐约展现出图像生成与编辑能力。社区用"生成 5 帧视频、取第一帧"的办法,把它当作文生图或图生图模型使用,官方在 AMA 中正面回应了这一用法。
在回答"哪个实验最改变你们对视频模型学习的认识"时,研究员 Nero 提到一个零样本观察:团队曾训练模型只完成"由第一帧和文字描述预测最后一帧"这一简单任务,没有做任何专门的图片编辑后训练,模型却在多个图片编辑基准上表现出较强的零样本能力。Nero 表示,这让团队对"由自然语言指令驱动的原生上下文学习"跨任务泛化更有信心,也是继续把这套架构扩展到专门图像模型的重要依据。
2K 再生模块与稀疏注意力:开放路线与许可
H3 的 2K 输出依赖一个名为 In-context Regeneration 的方案:模型不是靠独立超分从低分辨率像素中猜测细节,而是结合原有上下文对低分辨率结果重新生成高分辨率版本。开放权重后,社区拿到的版本无法完整复现线上 2K 能力,因此有开发者直接询问:用于最终 2K 输出的模型会不会发布?开发者关系负责人 Ryanlee 给出肯定答复:会,而且不会太久。
研究员 Kiro 随后补充了技术细节:这个再生阶段不是简单地把已发布的 Base 检查点再运行一遍,也不是传统意义上的像素级超分模块,而是一个专门面向更高目标分辨率的潜空间 DiT 再生检查点。基础模型此前生成的内容会作为额外上下文输入,部分参考输入也会以更高分辨率提供给模型。团队仍在优化它在本地使用的效率与质量,尚未公布发布日期。
稀疏注意力是开发者眼中另一个重要的本地推理优化。H3 训练后期已经使用稀疏注意力,但开放版本仍以全注意力推理,随着分辨率和时长提升,注意力计算的显存开销会快速膨胀。Kiro 确认,H3 没有沿用 M3 的 MSA,方案更接近 MoBA 风格的块选择机制:相邻视觉令牌被分组为块,用均值池化表示评估哪些块更重要,从而减少不必要的注意力计算,且不需要额外训练一个索引器。当前这套三维稀疏化只作用于视频令牌,图像和文本令牌可能在未来版本中加入。团队计划近期提供一份保守的参考实现,第一目标是无可感知的质量损失,针对不同 GPU 的最大加速仍依赖社区在硬件和后端上的适配。
许可与开放策略同样被反复追问。H3 目前采用 Community License,许可范围排除欧盟、英国、韩国和美国,官方提供申请通道,Ryanlee 在 AMA 中回应欧洲开发者"申请即可免费使用"。被问及是否考虑 Apache-2.0 时,Ryanlee 表示,随着版权相关文件处理完成、法律环境进一步清晰,会考虑采用 Apache-2.0。至于未来模型是否继续开源,团队的答复是"Yep, Keep open until AGI arrived"(会一直开放到 AGI 到来)——这句话更像是 AMA 场合下的表态,而非正式路线图。
效率与更小变体:低步数版本在考虑,官方不单独做小模型
比稀疏注意力更直接的问题是能不能少跑几步。H3 开放后,第三方 Turbo LoRA 很快出现,社区直接询问官方是否会推出 4-step 或 8-step 版本。Kiro 解释,已发布的检查点本身包含 CFG 蒸馏,最终训练阶段也采用了特殊策略,因此模型已经具备一定的低步数推理能力,但它并不是针对极端低步数专门蒸馏出来的模型。团队正在探索进一步的步数蒸馏,并积极考虑 4-NFE 或 8-NFE 这样的低步数版本,但暂时无法承诺近期提供,默认目标是在降低推理成本的同时不产生用户可感知的质量下降。
更小模型的计划同样被问及。Kiro 表示,短期内没有单独训练更小文生视频或图生视频版本的计划,团队期望社区通过结构化块剪枝、恢复训练或蒸馏技术衍生出更小的变体。
官方已知短板:远景像素化与 Ref2Vid 画质
画质是这场 AMA 里最尖锐的问题之一。有用户反馈,无论文生视频、图生视频还是参考图生视频,人物或物体距离镜头较远时都会出现像素化和变形,即使提高到 2K、增加采样步数也无法彻底解决,并询问是否存在推荐的步数、采样器、调度器与分辨率组合。Kiro 证实团队内部观察到了同样的问题,尤其在主体较小或距离较远时。根据内部实验,这个问题不能简单归因于视觉 VAE 的压缩比率,也不单是某个训练阶段造成的,而是一个涉及模型与训练流程多个环节的系统性问题。团队将其列为下一阶段重点改进的问题之一,但这场 AMA 没有给出能可靠解决该问题的采样器、调度器或步数设置。
另一个被反复讨论的画质问题是 Ref2Vid。多名用户发现,Ref2Vid 的输出看起来比 I2V 更柔和、稳定性更差,使用驱动视频作为动作参考时尤其明显,同样的分辨率与步数下 Ref2VA 往往没有 FL2VA 清晰。Nero 确认团队已经意识到这一问题:FL2VA 和 Ref2VA 两个检查点目前存在不同的视觉质量倾向,原因之一来自二者采用的不同后训练策略,团队正在积极改善 Ref2VA 的视觉质量。官方给出的实用建议是尽可能提供最高质量的参考输入,因为 Ref2VA 对参考条件的质量相当敏感,压缩或低质量的参考可能让结果更糟。
提示词遵循:没有特殊技巧
H3 开放后,一个被大量用户提到的特点是它似乎比许多开放视频模型更"听话"。有开发者举例,即使要求生成老式卡车或复杂的打斗场面,H3 仍能准确理解要求且不需要反复抽卡,因此追问模型是否使用了某种特殊架构、训练数据到底有多大。dacongya 的回答没有指向任何单一架构特性:最重要的因素在于构建广泛且多样的数据集与任务、使用通用型架构训练,以及避免采用无法有效扩展的设计选择。MiniMax 没有透露训练数据集的大小。按团队的说法,H3 的指令遵循能力来自数据构建、任务设计、架构与训练策略的综合作用,而不是某个神奇模块。
Context-IR:本地用户可参照官方指南近似复现
H3 完整产品链路里还有一个关键组件 Context-IR,负责先理解用户提供的复杂文本、图片、视频和音频条件,再整理成模型更容易理解的结构化上下文。本地部署的用户拿到的是基础权重,不会自动获得在线服务中的完整提示词处理流程。团队的回答是,完整、原生的 Context-IR 体验仍通过 MiniMax API 提供,但本地用户有官方指南可用。Luigi 引导用户查阅两套独立官方指南,分别对应基础工作流与参考工作流,其中包含提示词扩展说明与结构化输入示例,MiniMax 还把两份指南整合为 H3 提示词编写技巧,并表示会持续更新。
这套方案没有完全复现在线版 Context-IR 的流程,但为本地用户提供了更清晰的方式来组织复杂提示词与多模态参考内容。
长视频:可以续写,但无缝衔接仍是实验性的
更长视频是社区的另一个高频问题。Nero 在 AMA 中说明,Ref2VA 可以利用前一段视频的结尾部分及其音频作为下一段的参考,之后由用户描述新段落应如何延续。但这种方法无法保证无缝过渡,身份漂移、动作不连贯及其他变化仍可能出现。
团队还谈到一种从预训练阶段继承下来的非官方 RoPE 扩展工作流。在某些情况下它能产生更好的续写效果,但需要更严格的提示词,且无法可靠兼容多个参考输入。MiniMax 最初训练过一个专门的音视频续写任务,使用扩展的 RoPE 位置编码,作为独立任务时效果良好,但与其他任务结合时泛化能力不够强。因此,发布的模型主要依赖标准参考条件,并没有原生支持长循环序列训练。团队认为,未来结合稀疏注意力的长轨迹训练有望改善这一问题。
对开发者:开放的边界正在被逐条划定
MiniMax 这次的动作有一个清晰指向:图像模型不是 H3 的附属品,而是同一套架构向静态图像延伸的正式一步。对开发者,一条可以完全本地跑通的链路成为可能:图像模型生成首帧,H3 负责续成视频,两个环节都计划开放权重。对开源社区,团队在 AMA 中正面回应了"5 帧取首帧"的用法,并把零样本编辑能力写进继续扩展架构的理由,等于承认社区先于官方定义了这个模型的一种用法。
这场 AMA 真正划定的边界,不是开源与闭源的分野,而是开放的位置:模型权重、生成模块与推理优化会交给社区,负责理解复杂多模态条件的 Context-IR 仍留在 API。官方把每一项"下一步"都放在没有日期的状态里,而社区已经在用第三方 Turbo LoRA 和"5 帧取首帧"填补官方尚未承诺的部分。对开发者来说,H3 生态的下一步,可能更多取决于社区在参考实现和衍生模型上能跑多远,而不是官方公布的时间表。
 AI 速览