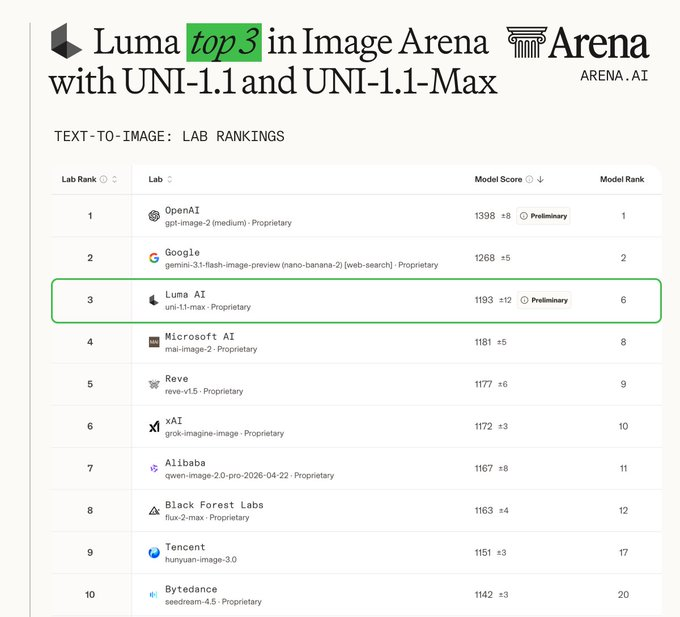
5月6日消息,Luma Labs 旗下 Unified Intelligence 图像模型 Uni-1.1-Max 在公开图像竞技场 Image Arena 上位列 Text-to-Image 第 6 名,Elo 1193 分,较此前 MAI-Image-2 高出 12 分;Uni-1.1 标准版同步上榜,以未使用 agentic search 增强的形态拿到当前成绩。
Luma 团队据此宣布公司"成为 OpenAI 与 Google 之外最好的图像实验室"。Uni-1 系列发布以来,在 Human Preference Elo 上已取下 Overall、Style & Editing、Reference-Based Generation 三项第一,Text-to-Image 第二(仅次于 Google Nano Banana),并在 RISEBench 推理性图像编辑评测上排名第一。本次 Uni-1.1 API 同步进入正式商用阶段。
把推理与图像生成压进同一个 autoregressive transformer 里
Uni-1 的核心架构选择把它与传统扩散模型路线拉开了明显距离。Stable Diffusion、Flux 等当前主流图像模型采用 denoising diffusion probabilistic model 流水线,把图像生成视为从噪声逐步去噪的概率过程;Uni-1 走的是 decoder-only autoregressive transformer,与 GPT 类语言模型同构,把文字 token 与图像 token 编进同一条序列内部交错处理,推理与图像生成在同一模型里完成,而非由两套独立系统在推理时拼接。
这一架构的实际收益体现在三处。第一是多约束 prompt 的执行精度——Uni-1 在生成像素之前先做一轮内部推理,梳理空间关系、对象优先级、风格约束、参考图绑定,生成质量对长 prompt 与多图参考的依赖度显著下降,用户不再需要为复杂 brief 做大量 prompt engineering。第二是参考图驱动的一致性——Uni-1.1 Pro 版本支持单次最多 14 张参考图,可同时维持最多 5 个人物的形象一致性,品牌资产生成、漫画分镜、广告系列等场景的实用度大幅上升。第三是迭代式编辑——支持多轮对话内修改图像而不丢失上下文,把"生成 → 局部调整 → 再生成"的链路从重启 prompt 改成连续对话。
API 层面 Uni-1.1 与 Uni-1.1 Max 同步开放,提供 Build 与 Scale 两档计费,前者按用量计费用于集成与试验,后者提供更高速率限制与专属支持适配生产负载。生成时间约 31 秒/张,价格不到同类模型一半,SDK 覆盖 Python 与 JavaScript/TypeScript,输出支持 1:1、9:16、16:9 等标准比例与 PNG/JPEG 格式。Envato、Comfy、Runware、Flora、Krea、Magnific(原 Freepik)、Fal、LovArt 等创意工具平台已陆续把 Uni-1.1 集成进自家产品线,意味着在最终用户层面 Uni-1 已经开始通过这些第三方平台间接接触到大量创意工作者。
Image Arena 格局:闭源大厂仍在第一梯队,Luma 切出独立实验室身位
横向看图像生成赛道当前格局,Text-to-Image Arena 顶部仍由 Google Nano Banana 系列与 OpenAI GPT Image 2 主导。Nano Banana 在文字渲染、世界知识、品牌素材一致性上给出了过去半年最强的版本节奏——2025 年 8 月 Nano Banana 首发,11 月升级到 Pro,2026 年 2 月再升级到 Nano Banana 2,迭代密度让其他玩家很难持续对位。OpenAI GPT Image 2 在 Image Arena 上的 Elo 近期下降 110 分,具体原因尚不明确,但客观上为后续玩家挤出排名空间。
Luma 在第二梯队的卡位思路与其他开源/独立厂商显著不同。Black Forest Labs 的 Flux Max 走的是高质量开源路线,在创作者社区与本地部署生态里有强势位置;Midjourney 在风格美学上仍是行业标杆,但 v8 版本在多约束 prompt 上表现弱于 Uni-1;Stability AI 系列在产品迭代上节奏放缓;Adobe Firefly 主打商用安全与版权保护,深度绑定 Creative Cloud。Luma 的差异化建立在 Unified Intelligence 这一架构哲学上——不是单纯优化生成质量或风格库,而是把推理能力作为核心卖点,瞄准 enterprise 与 creator-pro 市场对"模型能听懂复杂创意意图"的真实需求。
值得注意的是 Luma 同期还在视频生成赛道(Dream Machine、Ray 2)持续推进,Unified Intelligence 架构被官方明确描述为可扩展到视频生成、语音 agent、交互式世界模拟器,这意味着 Uni-1 不是一个孤立的图像产品,而是 Luma 整套多模态战略的视觉基底。如果架构假设成立,Luma 接下来会围绕同一套核心模型向外扩展能力,而非各模态独立训练,工程效率与生态一致性都会形成跨模态的复合优势。
局限:尚未冲入榜首、31 秒延迟偏长、中文场景未充分验证
Uni-1.1 系列当前阶段的几个明确局限需要保留判断。第一是排名虽然进步,但 Text-to-Image 第 6 仍未冲入第一梯队。Image Arena 顶部 5 名仍由 Google、OpenAI 与少数前沿实验室占据,要真正挤入头部,Luma 仍需在 6-12 个月内拿出比 Uni-1.1 Max 更显著的版本跃升。Human Preference Elo 上的 Overall 第一与 Image Arena Text-to-Image 第 6 之间的差异,某种程度上反映出不同评测维度的侧重——Overall Elo 包含 editing、reference 等多场景,Text-to-Image 单项才是纯生成质量的对位,Luma 在后者仍处于追赶位置。
第二是生成延迟。31 秒/张的生成时间在 batch 创意工作流里属于可接受,但在交互式 chat-to-image、实时迭代、agent 调用等高频场景下偏长。Nano Banana 系列在 Gemini 应用内已经实现接近实时的图像编辑响应,Luma 若希望切入 agent-native 工作流,延迟优化仍是一个明确的工程方向。 第三是非英文场景的真实表现仍待第三方验证。Uni-1 官方披露在多语言文化适配上下了功夫,训练数据包含了从 internet meme 到日本漫画等多种视觉格式,但中文场景下的文字渲染、东亚审美适配、本地文化要素的准确性尚未在公开 benchmark 上得到独立测评。对国内 ChooseAI 受众而言,Uni-1.1 在创意 SaaS 与企业品牌资产生成场景里值得关注——尤其通过 Envato、Magnific 等平台间接接触时,实际表现可能比直接 API 调用更稳定。中文图像生成的最终选择仍可能在通义万相、即梦、可灵图像等本土玩家与 Uni-1.1 之间分场景比较,而非简单替代。  AI 速览