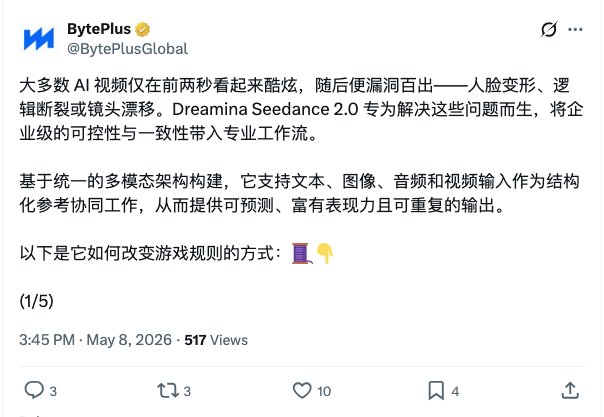
5月8日消息,字节跳动把发布 Dreamina Seedance 2.0定位为企业级专业 AI 视频生成工具。 与市面上多数"前两秒惊艳、随后崩盘"的 AI 视频产品不同,Seedance 2.0 的核心卖点是可控性、一致性与物理真实感——基于统一的多模态架构,支持文本、图像、音频和视频作为结构化参考协同输入,输出可预测、可重复的生产级结果。
当前 AI 视频的痛点:为什么"酷"不等于"能用"
BytePlus 在发布帖中直指行业通病:大多数 AI 生成视频在前两帧视觉效果惊艳,但随后便出现人脸变形、逻辑断裂、镜头漂移等问题。这些缺陷对社交媒体短视频或许可接受,但对需要品牌一致性、物理合理性和叙事连贯性的企业级工作流而言,是致命障碍。
观察:这一定位与当前市场对 AI 视频的需求演变一致——从"炫技 demo"转向"生产工具"。Seedance 2.0 的发布时机,恰逢 Runway、Pika、Kling 等竞品也在强调"consistency"和"camera control",但多数仍停留在单点优化层面。
判断:BytePlus 选择以"统一多模态架构 + 物理引擎级一致性"作为差异化切口,而非追逐更长时长或更复杂特效,这是一条更贴近 B 端真实需求的路径。
技术架构:统一多模态输入,结构化参考协同
Seedance 2.0 的核心技术特征是统一多模态架构——用户可同时输入文本提示、参考图像、音频轨道和视频片段作为结构化参考,模型在多模态信息融合的基础上生成输出。这意味着:
核心能力:多模态融合控制、结构化参考输入、跨模态一致性保持
场景演示:三个企业级用例
BytePlus 在发布线程中附带了三个具体场景的视频演示,展示了 Seedance 2.0 在不同垂直领域的应用方式:
1. 逼真场景:物理完整性 + 自动字幕
场景:角色互动遵循真实世界物理规律,无视觉穿模或失真。脚步的沉重感、符合情绪预期的自然表情、重力与碰撞的物理响应——这些在 Seedance 2.0 中保持一致。系统同时自动生成与画面精准同步的字幕,直接节省后期制作时间。
核心能力:物理一致性、表情自然度、自动字幕生成
2. 电商产品展示:360° 环绕 + 材质保真
场景:从单张产品照片出发,生成 360° 环绕拍摄和复杂多镜头序列。在动态条件下,产品的形状、颜色、几何结构保持一致;超高保真材质渲染确保纹理和光照稳定,并呈现自然的物理响应。输出可直接用于风格统一的品牌级营销活动。
核心能力:产品形态锁定、材质光照保真、多镜头序列一致性
3. 动态漫画 / 故事片:角色身份全程稳定 + 动作参考复现
场景:参考多个角色图像,在整个故事中保持视觉细节和身份一致性。用户可直接将分镜脚本转化为连贯视频,获得稳定的转场和对话定位。借助"动作参考"功能,上传动作片段即可精准复现角色的特定姿势和动作。
核心能力:多角色身份保持、分镜到视频直转、动作参考复现
产品定位:从"酷炫"到"可投产"
Seedance 2.0 的结语明确传递了产品哲学:"多模态控制。物理真实感。全程一致性。专为创作者和团队打造,他们需要的不仅仅是'酷炫',而是能够直接投入生产的专业成果。"
这一表述将 Seedance 2.0 与当前市场上以"创意探索"和"视觉奇观"为主打的 AI 视频工具区隔开来。BytePlus 通过 ModelArk 平台提供 Seedance 2.0 的 API 接入,文档页面已上线资源包购买指南(Resource packs for Dreamina Seedance 2.0 series models),支持企业级按需调用。
推理:BytePlus 选择通过 X 平台(而非国内渠道)首发,配合英文文档和英文界面,表明 Seedance 2.0 的首要目标是国际市场——尤其是有视频生产需求但缺乏高端制作团队的中小企业和创意机构。
行业背景与竞争格局
AI 视频生成赛道在 2025-2026 年快速分化:
Seedance 2.0 的差异化在于将"一致性"从单一维度(如角色或镜头)扩展到全链路——从输入参考到物理响应到输出稳定性,形成闭环。这与字节跳动在推荐算法和内容理解领域的技术积累一脉相承。
 AI 速览