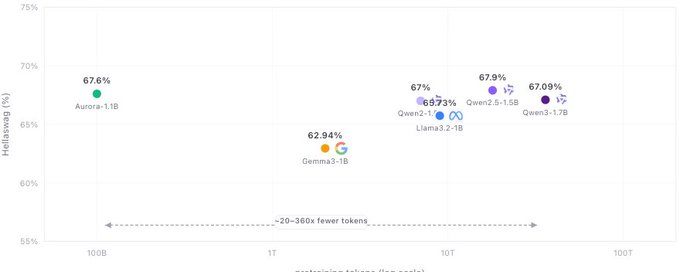
5月11日消息,Tilde Research 近日公开论文指出,被 DeepSeek V4、Kimi K2.5、GLM-5 等头部模型采用的 Muon 优化器存在结构性缺陷,在训练早期会导致 MLP 层超过 25% 的神经元接收到持续偏小的梯度更新并最终永久失活,团队据此推出修复版 Aurora 优化器并已开源 1.1B 预训练模型与代码,在 modded-nanoGPT 优化赛道上刷新 SoTA,只增加 6% 计算开销且无需调参。 这是 2024 年 12 月 Muon 走红以来,首次有研究团队从底层数学结构上系统拆解其失效路径,直接关系到当前主流大模型的训练效率天花板。
Muon 行归一化的隐藏代价
Muon 的核心做法是通过迭代算法计算梯度矩阵的极分解因子 polar(G),把更新方向限制在正交矩阵流形上,从而让 2D 隐藏层参数的每一次更新都尽量"等价地"覆盖所有方向。这套设计在方形矩阵上工作良好,但 MLP 上投影与门控投影矩阵是显著的"高瘦矩阵"——行远多于列。Tilde 团队的发现是,Muon 更新中每一行的范数分布并不均匀:那些在训练最初几步因初始化或数据偶然性获得较大更新的行,会持续吸纳后续更新的能量,而初始更新偏小的行则陷入越来越小的更新循环,最终对应的神经元彻底失去学习信号。
研究团队把这一现象量化为"行 leverage score":极分解结果中某一行的范数平方与列空间的对齐程度成正比,而正交化操作几乎完整保留了这一行 leverage 分布。换句话说,Muon 优化器本身就以数学方式锁定了神经元之间的不平等。NorMuon 此前通过对每行做 RMS 归一化部分缓解了问题,目前是 modded-nanoGPT speedrun 的 SoTA 持有者,但行归一化又会显著破坏 polar 因子的精度,造成新的训练不稳定。Aurora 的思路是把更新投影到行斜流形与 Stiefel 流形的交集上,既保证正交性又强制行范数均匀,在方形矩阵上自动退化为标准 Muon 更新,完全向后兼容。
Aurora 在 1B 规模碾压 NorMuon
按论文公开的实验结果,Aurora 在 1B 参数规模上同时大幅领先 Muon 与 NorMuon,且性能增益随 MLP 宽度扩大而非衰减——这意味着在 DeepSeek V4 这类 MLP 扩张系数普遍 4 倍以上的 MoE 架构上,Aurora 的边际收益会进一步放大。团队同时开源了一个用 Aurora 训练的 1.1B 模型权重和完整代码,默认 hyperparameter 沿用 Muon 的 mu=0.95、nesterov 动量与 0.025 权重衰减,polar 因子用 12 次 simple-quintic Newton-Schulz 迭代计算。开发者按官方说法可以直接在现有 Muon 训练脚本中替换优化器,无需重新搜索超参,这种"零调参替换"的工程友好度是 NorMuon 此前未做到的。
横向对比来看,Muon 自 2024 年底由 Keller Jordan 发布以来,已经把 1.5B Transformer 训到 GPT-2 XL 水平所需的 8xH100 小时数压到 10 小时级别,并被字节、Moonshot、智谱、DeepSeek 先后纳入训练栈。Tilde 此次披露的神经元死亡问题,实际上是过去一年这些团队为何普遍报告"训练后期需要重新激活某些层"的潜在解释。Aurora 若在更大规模上复现这一优势,可能直接影响下一代 DeepSeek V4.5、Kimi K3、GLM-6 等模型的优化器选型路线。
等待大规模复现的关键节点
需要保持冷静的是,Aurora 当前公开的最大实验规模仍停留在 1B,而 Muon、NorMuon 在 7B 至百亿参数级别的训练动态本就和 1B 存在显著差异——比如门控投影矩阵的 leverage 分布在 MoE 路由约束下可能呈现完全不同形态,神经元死亡比例究竟是放大还是被路由机制缓冲,目前没有公开证据。
Aurora 引入的 leverage-uniform 投影也意味着每一步都要额外计算行范数并做迭代修正,论文给出的 6% 计算开销是 1B 规模数据,扩到 70B 以上时是否仍能维持这一比例,取决于 Newton-Schulz 迭代在 FSDP2 行分片下的通信效率。开发者社区当前最关注的是头部模型团队何时给出 Aurora 在 7B 至 30B 规模的对照实验,以及现有 Muon-trained 模型是否能通过继续训练部分恢复死亡神经元——这两个问题的答案将决定 Aurora 究竟是优化器圈的一次重要修正,还是一次更彻底的范式更替。
 AI 速览