2026 年 5 月 10 日,有开发者对GLM-5.1、MiMo-V2.5 Pro、Kimi K2.5、MiniMax M2.7、DeepSeek V4 Pro5 款国产主流模型进行实测,基于真实开发、Skill 触发、写作辅助三类场景,给出完整适配结论。 一、测试标准:贴近真实场景,拒绝纸面跑分
本次测试摒弃传统 benchmark 题库,以日常高频使用场景为核心,更具实用参考价值:
- 真实开发需求:为现有项目新增功能,要求模型读懂代码结构、不破坏原有逻辑。
- Skill 触发:检验模型读取 CLAUDE.md 与技能描述的能力,能否精准调用服务器管理、生图等自定义技能。
- 写作辅助:接续半完成文章,保持风格统一,评估文本生成质量。
测试聚焦稳定性、响应速度、上下文理解、Skill 精准度、约束执行五大核心维度。
二、5 款模型实测表现:适配能力差距显著
1. GLM-5.1:综合全能,首选推荐
- 开发:上下文理解稳定,复杂需求会先确认关键节点,减少返工。
- Skill:触发准确率最高,无需重复提示,响应及时。
- 定位:Skill 重度用户、复杂开发任务首选,综合表现无短板。
2. MiMo-V2.5 Pro:速度优先,高效流畅
- 开发:执行速度快,代码逻辑清晰,简单任务可一次完成。
3. Kimi K2.5:意图理解强,模糊需求适配佳
- 不足:Skill 触发需额外提示,写作风格稳定性一般。
- 定位:需求表述不清晰、需要模型辅助梳理意图的场景。
4. MiniMax M2.7:轻量够用,复杂场景乏力
- 不足:复杂开发易出错,跨文件理解薄弱,Skill 触发易遗漏。
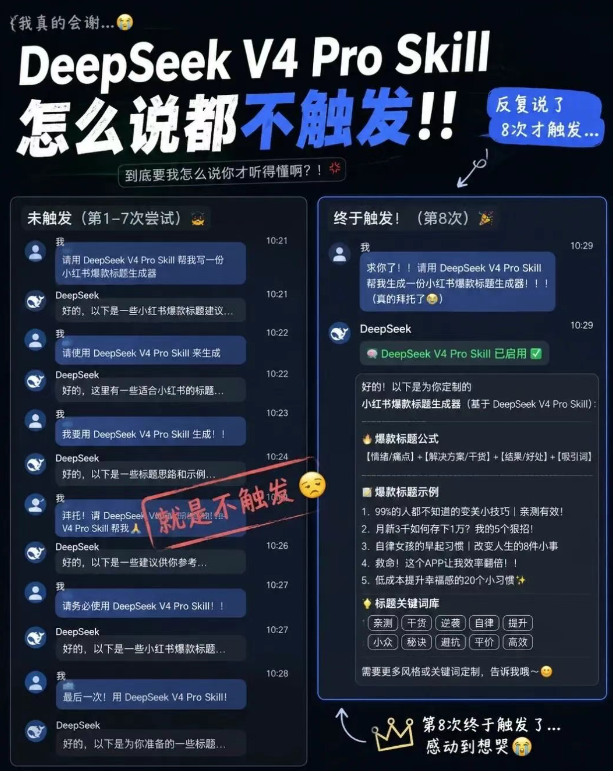
5. DeepSeek V4 Pro:写作优秀,开发适配不足
- 亮点:长文写作稳定,风格衔接自然,内容创作表现突出。
- 不足:Skill 触发困难,约束执行不到位,易跳过规则自行操作。
- 定位:纯内容创作场景可选,不推荐用于开发与 Skill 依赖场景。
三、适配结论与使用建议
根据不同使用需求,可直接对应选择:
- 快速开发 / 中小型项目:MiMo-V2.5 Pro
接入方式简单,通过CC Switch 图形化工具配置 API Key 即可快速切换模型,降低使用门槛。
四、总结
国产模型已能较好适配 Claude Code 框架,完全可替代原版 Claude 满足日常使用。
不同模型在开发、技能调用、写作场景各有优劣,用户可根据核心需求精准选择,既能避开账号风险,又能获得流畅高效的使用体验。
 AI 速览