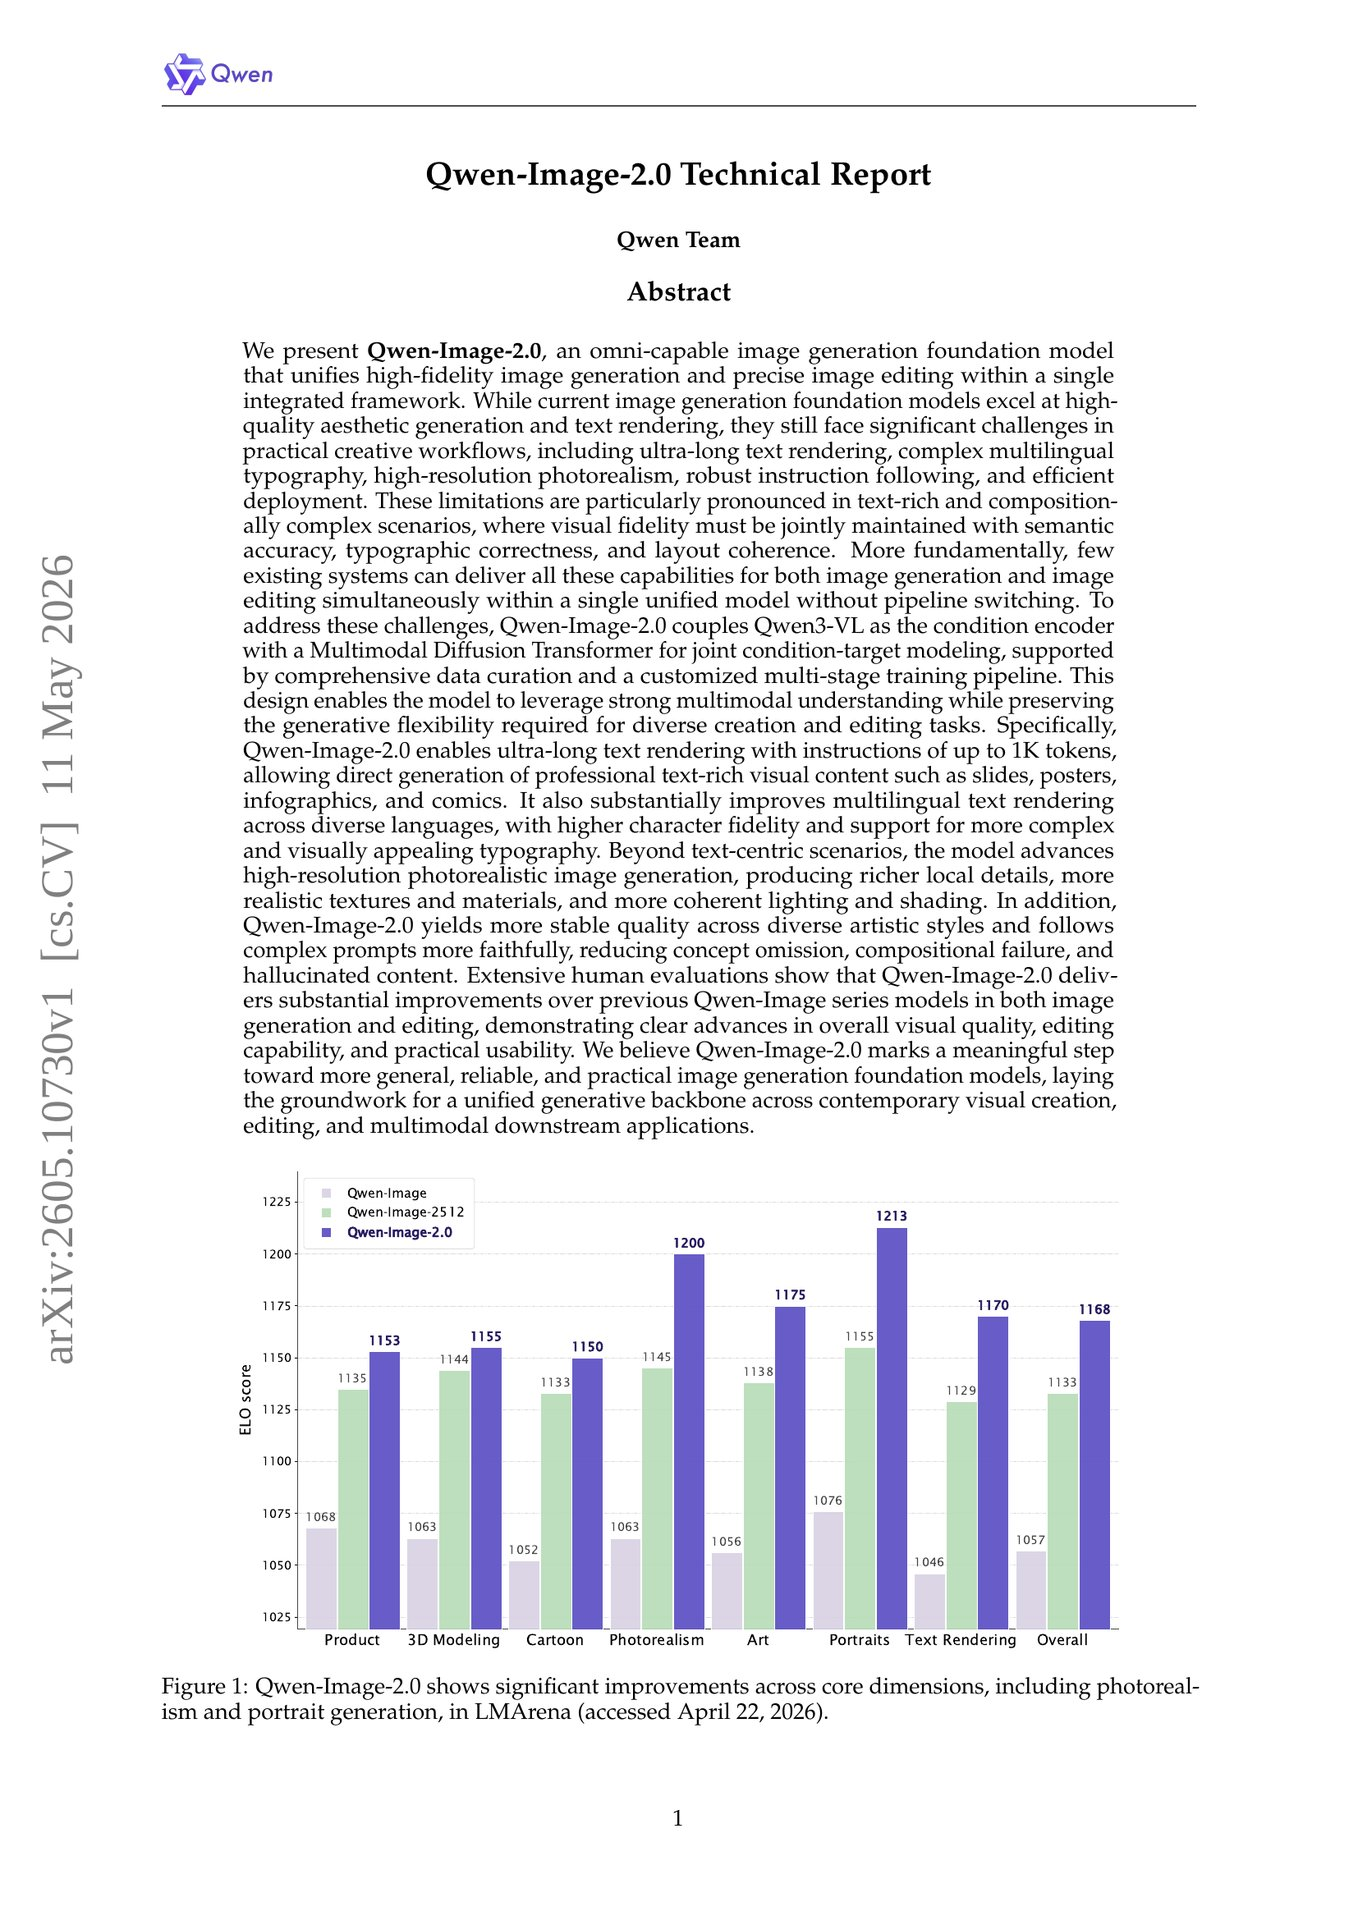
5月11日,阿里巴巴 Qwen 团队在 arXiv 公开 Qwen-Image-2.0 技术报告(arXiv:2605.10730),首次披露这款今年 2 月上线模型的完整架构与训练管线。报告显示,Qwen-Image-2.0 采用 8B 参数 Qwen3-VL 作为条件编码器、7B 参数多模态扩散 Transformer(MMDiT)作为生成解码器,总参数较上一代 Qwen-Image 的 20B 缩小近 3 倍,但在 DPG-Bench 得分 88.32,反超 FLUX.1 的 83.84;在 AI Arena 盲评平台同时拿下文本生成与图像编辑双榜第一。模型支持长达 1K token 的指令、原生 2K 分辨率输出,目前通过阿里云百炼(BaiLian)平台开放 API 访问。 Qwen-Image-2.0 是什么:统一生成与编辑的全能型图像基础模型
Qwen-Image-2.0 的核心定位与 Qwen-Image(2025 年 8 月发布)一脉相承:在一个统一框架内同时完成高保真图像生成与精确图像编辑。这是相对此前 FLUX.1 + FLUX.1 Kontext、Seedream + SeedEdit 等"生成 + 编辑双模型"路线的关键差异——同一套权重既能从文本生成图像,也能根据"文本 + 输入图"完成编辑指令。
技术报告将这次升级定位在五个具体痛点上:超长文本渲染、多语种排版、高分辨率写实、复杂指令遵循、高效部署。这些问题在文本密集型与构图复杂场景(海报、信息图、PPT、漫画、电影海报)尤为突出,也是过往一代图像模型与 FLUX.1、Midjourney 等通用模型对垒时最薄弱的环节。
模型本体早在 2 月 10 日就上线 BaiLian,本次公开的技术报告补充了完整训练管线、消融实验与 Benchmark 数据,等于把"已可用的产品"配上了"可被学术界引用的论文",这是阿里 Qwen 系列一贯的发布节奏。
架构拆解:8B Qwen3-VL 编码器 + 7B MMDiT 双流设计
Qwen-Image-2.0 的架构核心是"编解码分离":一个 8B 参数的 Qwen3-VL 视觉-语言模型作为条件编码器,负责理解文本 prompt 与输入图像(如果有);一个 7B 参数的 MMDiT 作为扩散解码器,负责生成或编辑输出图像。两个模块通过共享潜空间联合训练。
这个设计相对上一代 Qwen-Image(使用 Qwen2.5-VL + VAE 编码器双重表征 + MMDiT)有两点关键演进。一是编码器升级到 Qwen3-VL,该模型本身支持 256K token 交错上下文、原生处理图像与视频,使条件输入的语义理解能力大幅提升;二是引入了"联合条件-目标建模"机制,把编辑任务(text-image-to-image)与生成任务(text-to-image)放进同一损失函数训练,共享同一组生成参数。
参数缩减是另一个重要信号。从 20B 降到 8B + 7B = 15B,推理成本下降约 25-30%。这意味着 Qwen-Image-2.0 在相同硬件上的吞吐量明显高于 Qwen-Image,这对 API 服务和本地部署都是关键考量。模型权重目前未在 Hugging Face 公开,与 Qwen-Image 的 Apache 2.0 全开源策略相比偏向闭源 API。
训练管线方面,报告披露采用了"多阶段渐进式训练"——从基础文本渲染任务起步,逐步引入段落级与版式敏感任务,再加入多任务联合训练。数据策划采取大规模收集 + 过滤 + 标注 + 合成 + 平衡的标准流程,但具体数据量未公开。
Benchmark 逐项拆解:DPG-Bench、AI Arena 与文本渲染
Qwen-Image-2.0 公开的 Benchmark 数据集中在三类指标。
DPG-Bench(Dense Prompt Generation,密集 prompt 生成):Qwen-Image-2.0 得分 88.32,FLUX.1 为 83.84,差距 4.48 分。DPG-Bench 重点考察模型对长 prompt、多对象、复杂关系的遵循能力,该项胜出意味着在"需要精确遵循复杂指令"的场景下,Qwen-Image-2.0 优势明显。
AI Arena ELO 盲评:这是更接近真实使用感受的人类盲评平台,评测者不知道图像出自哪个模型,纯凭质量打分。Qwen-Image-2.0 在文本生成(text-to-image)与图像编辑(image editing)两个独立榜单都排名第一。这是相对量化 Benchmark 更难刷分的指标,通常被视为图像模型的"金标准"。
文本渲染(LongText-Bench、ChineseWord、CVTG-2K):这是 Qwen-Image 系列最具差异化的能力。Qwen-Image-2.0 可在单次生成中输出包含 PPT 幻灯片、信息图、海报、电影标题的完整版式,文本可自然融入场景表面(玻璃、布料、纸张)并保持正确透视与材质属性。对比 FLUX.1 只能渲染短文本字符串、Midjourney 在长段落与非拉丁字符上明显挣扎,Qwen-Image-2.0 在该项目上的优势是数量级的。
5 大主流模型对比:Qwen-Image-2.0 vs FLUX.1 / Nano Banana Pro / Seedream 5.0 / GPT Image 1.5 / Flux Klein
把 Qwen-Image-2.0 放在 2026 年 5 月的图像模型格局中横向对比,能更清楚看到它的真实位置。
FLUX.1(Black Forest Labs):强项在艺术风格与创意构图,Dev 版本提供高质量生成,Schnell 版本牺牲质量换速度。短文本可处理,长文本与非拉丁字符明显落后。开源生态成熟,LoRA 与 ControlNet 资源丰富。
Nano Banana Pro(Google,Gemini 2.5 Flash Image):基于 Gemini 3 推理后端,支持最多 14 张参考图、5 个角色或 14 个对象的跨场景一致性。文本渲染表现优秀,4K 原生输出。强项在速度与多模态推理。 Seedream 5.0-Preview(字节跳动):差异化在"知识驱动生成"——可实时联网搜索 + 逻辑推理,这是其他图像模型都没有的能力。适合需要事实准确性的场景(产品参数图、地图标注等)。
GPT Image 1.5(OpenAI):分级定价策略,质量可配置,适合预算敏感与质量敏感场景混合的工作流。
Flux Klein:开源轻量级,$0.01/image 是当前同等质量段最便宜方案,适合高吞吐场景。
横向比较,Qwen-Image-2.0 的差异化护城河集中在三点:中英双语文本渲染、超长 prompt 遵循、原生 2K 分辨率。这三点合在一起,使其在海报、广告物料、信息图、漫画、教育内容、电商详情页等文本密集场景下几乎没有竞争对手。
适用场景与选型建议
基于上述对比,Qwen-Image-2.0 最适合的场景包括:中文内容创作(海报、公众号配图、电商详情页)、多语种排版(国际化营销物料)、复杂版式生成(信息图、PPT 模板、漫画分镜)、需要 1K token 长指令精确控制的场景。不适合的场景则包括:纯艺术化创作(FLUX 与 Midjourney 仍更强)、需要 4K 以上原生分辨率(Nano Banana Pro 更合适)、需要联网搜索事实校验(Seedream 5.0 更合适)、需要本地完全离线运行(Flux Klein 或 Qwen-Image 一代开源版更合适)。
API 调用方面,Qwen-Image-2.0 通过阿里云百炼平台开放,与 Qwen-Image 一代不同,目前没有公开开源权重的明确时间表。需要本地部署的用户仍可使用 Qwen-Image 一代(Apache 2.0 开源),或考虑 Flux Klein、Seedream 5.0 等替代方案。
局限与待观察的问题
Qwen-Image-2.0 仍有几项明确局限。一是开源策略转变带来的可控性下降——模型权重未发布,所有调用必须经阿里云,这对数据敏感行业(法律、医疗、金融)的本地化部署不友好。二是技术报告未披露训练数据规模与版权来源,商用合规存在不确定性。三是与 Qwen-Image 一代相比,2.0 缩减了参数(20B → 15B),在极端复杂场景(超过 5 个角色、超过 1K token 指令)的表现是否真的优于一代版本,需要更多第三方实测验证。四是 AI Arena ELO 评分容易随评测者偏好与新模型加入而变化,5 月报告中第一的位置在 6-8 月新模型(如 Seedream 6.0、Flux 2 Pro)发布后仍能否维持有待观察。
整体来看,Qwen-Image-2.0 不是一款颠覆格局的模型,而是把"文本渲染 + 长 prompt + 多语种"这条垂直能力线推到了当前公开模型的最高水平,与 Nano Banana Pro 的"多对象一致性"、Seedream 的"知识驱动生成"形成各自的差异化方向。对于内容生产链路明确包含中英文文本与复杂版式的团队,Qwen-Image-2.0 是 2026 年中目前最值得纳入选型清单的图像模型之一。
 AI 速览