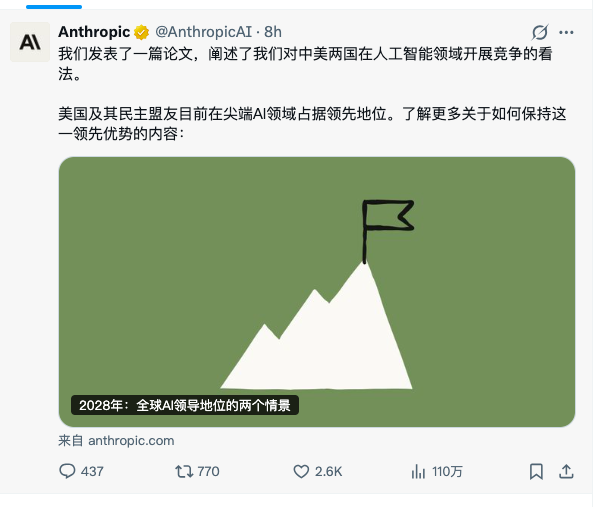
5月15日消息,Anthropic在官网研究板块发布政策论文《2028:全球AI领导力的两种情景》,系统阐述其对中美AI竞争的判断与政策诉求。论文以"算力(compute)是AI竞争核心要素"为前提,构建了"智能/国内采用/全球分发/韧性"四条战线的分析框架,提出三项具体政策建议:堵住芯片走私和海外数据中心访问漏洞、立法明确"蒸馏攻击"违法、推动美国AI技术栈在全球的分发。论文一经发布即引发分化反应——美国政策圈视其为对《AI Action Plan》的具体路线图补充,中文科技评论圈则普遍以"贼喊捉贼"概括其论证逻辑。考虑到该论文本身是政策文档而非中立研究,本文以"论文主张 vs 业界质疑"的并置结构呈现各方核心分歧,便于读者自行判断。
算力中心论:决定性变量还是简化叙事
论文最核心的前提是"算力差距将复利为算法差距,再复利为AI领导力差距"。Anthropic引用CFR的分析称,Huawei在2026年总算力将仅为NVIDIA aggregate compute的约4%,2027年降至约2%;引用IFP估算称,若管制收紧,2028年美国可用算力将达到中国的约11倍。论文据此推出"美国应该可以锁定12-24个月领先窗口"的判断。
业界对这套叙事的质疑集中在两个层面。技术侧,DeepSeek V3的训练披露文档显示其完整训练成本约$558万,远低于美国头部实验室同代模型的支出,核心创新(MoE架构优化、MLA注意力机制、FP8混合精度训练)属于算法效率突破而非算力堆叠;Moonshot Kimi K2.6在SWE-Bench Pro上以58.6%超过GPT-5.4(57.7%)和Claude Opus 4.6(53.4%),同样发生在算力受限条件下。这些案例直接挑战论文的核心假设——算力优势是否真的会"线性复利"为算法优势?产业侧,国产HBM(长鑫存储、长江存储)的爬坡、华为Ascend 910C/950的实际部署规模、中芯国际N+2工艺的良率改善等变量在论文中均未被纳入算力差距的预测模型,论文引用的4%/2%数据更接近静态预测而非动态推演。 蒸馏攻击违法化:合理诉求还是双重标准
论文第二项核心政策诉求是把"蒸馏攻击"立法定性为违法行为。Anthropic在论文中将其定义为"中国实验室创建数千个欺诈账户绕过美国AI模型访问控制、系统性收集其输出以复制前沿能力",引用OpenAI、Google、Anthropic自身和Frontier Model Forum的公开谴责作为业内共识。
围绕这一主张的争议直指美国大型实验室自身的训练数据合法性问题。《纽约时报》、Authors Guild、Getty Images、多家新闻媒体集团对OpenAI、Anthropic、Microsoft、Stability AI等公司的诉讼仍在进行中,核心指控是未授权抓取受版权保护内容用于模型训练。今年3月Anthropic指控DeepSeek、Moonshot、MiniMax存在工业级蒸馏后,观察者网"关心"专栏、36氪等中文媒体以"贼喊捉贼"概括其论证模式——若大规模抓取互联网内容训练模型构成"合理使用",那么通过API调用购买访问权后用于蒸馏,为什么构成"非法工业间谍"?这一伦理框架的双重性是论文回避的核心问题。
另一项相关质疑来自开源派:Anthropic在论文中明确提到"可通过API元数据识别中国实验室具体研究员、追踪查询模式到具体雇主",这一披露被解读为闭源中心化模型本身就具备的监控能力。对于关心AI主权和数据隐私的开发者群体而言,这反而成为开源权重模型路线最有力的反向论证。
关键数据的双向解读:三个案例的局限
论文中的具体数据引用同样存在可核实性争议。第一是Mozilla Firefox案例,Anthropic称Firefox利用Mythos Preview模型在一个月内修复的安全漏洞数量超过Firefox整个2025年的修复总量,约为2025年月均的近20倍。这一数据在论文中作为"AI for AI R&D加速度"的核心论据出现,但Mozilla官方博客对这批修复的具体性质(高危/低危占比、是否包含自动化Linter发现的低优先级问题、人工复核工作量)未给出完整披露,单纯数量比较可能放大了实际能力跃迁的程度。
第二是CAISI(AI标准与创新中心)对DeepSeek R1-0528的评估,论文引用其"在某种常见越狱技术下满足94%恶意请求,美国参考模型仅8%"的数据作为"中国开源模型缺乏安全机制"的支撑。需要补充的语境是,CAISI是NIST下属机构,受美国政府AI政策直接指导,其评估方法、jailbreaking技术细节、测试样本量均未在论文中完整披露,DeepSeek官方也未对该数据作出回应。第三是Supermicro联创涉嫌将$25亿美元含先进芯片服务器转运中国的起诉案,论文将其作为"系统性走私"的代表案例,但单一刑事案件能否论证"系统性"、与同期合法销售总量的占比如何,论文未提供量化对照。
需要强调的是,提出这些质疑并不意味着Anthropic引用的数据全部存在问题——Mythos Preview在软件工程任务上确有显著进展,中国开源模型的安全对齐工作整体落后于美国头部实验室也是行业普遍认知。但当数据被打包进政策叙事时,呈现方式本身就具有立场——同样的事实可以服务于"中国威胁论",也可以服务于"开源模型亟需建立安全标准协作机制"的反向结论。
多方反应:政策圈认同、Anthropic自身困境与开源派批评
论文发布后的反应呈现明显光谱。美国政策圈反应整体正面,论文与Trump政府《AI Action Plan》和国会两党出口管制立场高度一致,被视为对现有政策的具体化补充。但Anthropic自身在Washington的处境并不简单——今年早些时候Trump曾公开称其为"radical left, woke company",国防部一度威胁将其列为"国家安全供应链风险"标签(该标签历史上仅用于华为等海外对手)。本次论文也被部分观察者解读为Anthropic向政策制定者重新确立"立场可靠"的姿态,背后存在明确的商业利益——出口管制收紧将提升Anthropic等美国闭源实验室的相对竞争位势,论文回避了这一利益声明。
中国侧的解读则截然不同。除"贼喊捉贼"框架外,《36氪》进一步指出该论文时间点与Anthropic和五角大楼谈判节奏重合,被定性为"借中国威胁论赢取国防合同"的游说文档;台湾AI产业评论圈出现了"AI产业的成人礼"(成年禮)的提法,关注重点不是中美对抗本身,而是政府是否有权将科技公司单方面定性为国安威胁。开源派的批评则更技术——Anthropic声称的算力垄断长期叙事,与DeepSeek、Qwen、Kimi等开源/半开源模型在SWE-Bench、MMLU、CBRN等基准上的实际表现形成直接反差,开源路线被论文有意淡化甚至贴上"安全风险"标签,被开源社区视为对开放AI生态的整体性敌意。 对开发者的实际信号:避开立场、聚焦产品
抛开政策立场分歧,对独立开发者和AI产品从业者而言,这份论文有几个值得关注的产品层面信号。其一,Mythos Preview的能力披露暗示Anthropic下一代模型(可能命名为Claude 5 / Opus 5系列)在软件工程、漏洞发现、AI for AI R&D等方向已有显著进展,与Mozilla等合作伙伴的早期接入意味着实际产品可能在未来1-2个季度内见到——这是直接影响开发工具选型的产品信号。其二,论文反复强调的政策方向若落地,"接Claude/GPT API在国内做产品"的中长期合规风险会上升,自主部署开源模型(Kimi、Qwen、DeepSeek、GLM、Hunyuan等)与构建跨厂商兼容架构(MCP、ACP等标准协议)的战略价值将继续增加。
其三是更深层的趋势——美方闭源前沿+中方开源近前沿的"双轨格局"已经在加速成型。Anthropic、OpenAI、xAI在政策上推动收紧、在产品上加强企业合规护城河(如同周Codex的HIPAA合规、Hooks审计),与Moonshot、DeepSeek、Alibaba在开源生态、跨Agent兼容(如Kimi Web Bridge)上的开放策略,形成两种截然不同的商业逻辑。对独立开发者而言,"选边"未必是必要选项——MCP、ACP等标准协议的逐步成熟,意味着技术栈可以在闭源前沿能力和开源生态自主之间灵活切换,关键是判断自身业务对"能力天花板"和"长期可控性"哪一项更敏感。论文本身是否能转化为美国实际立法仍取决于国会动作,但全球AI生态正在沿合规边界、开源态度、Agent互操作协议等多个维度加速分化——这才是开发者真正需要纳入战略判断的趋势。
 AI 速览