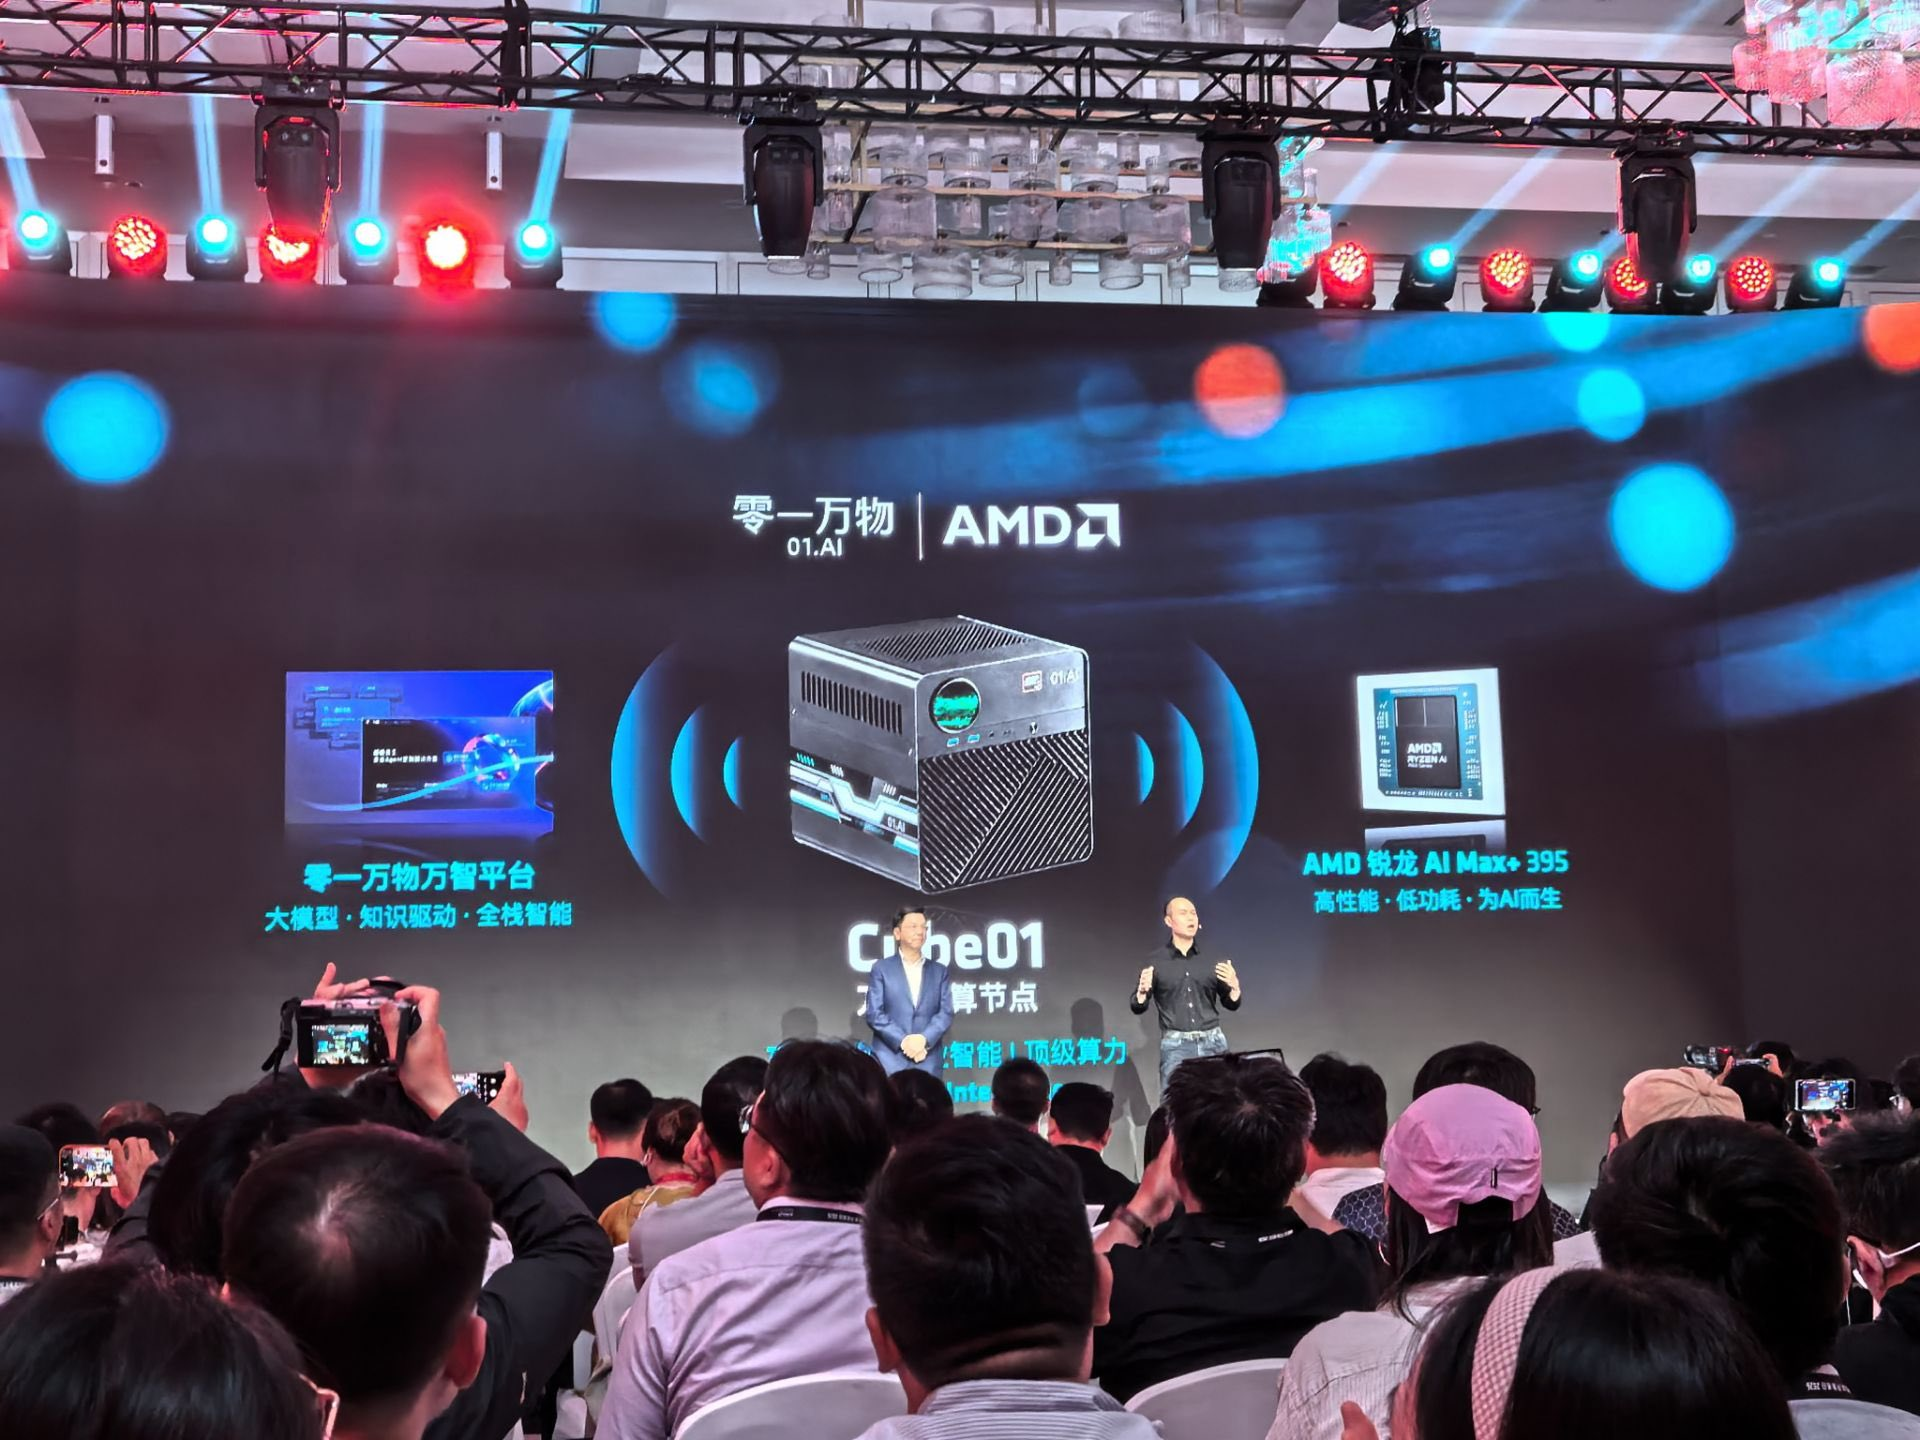
5月19日消息,AMD 在上海举办 AMD AI 开发者日 2026,这是 AMD 在北美之外唯一一场 AI 开发者日。董事会主席兼 CEO 苏姿丰发表主题演讲并与零一万物 CEO 李开复进行炉边对话,AMD 高级副总裁 Jack Huynh 分别与李开复、阶跃星辰 CTO 朱亦博、清华大学教授/无问芯穹发起人汪玉、AMD AI 事业部高级总监 Nick Ni 进行多场对话。
发布会主线由四块构成:硬件三段论、ROCm 软件栈 + 中国模型 Day0、Cube01 企业一体机、AI 开发者云。AMD 在演讲中披露,其在中国已有 30 多年历史、超 4000 名工程师,在多地设立 AI 卓越中心。
一、硬件三段论:从笔记本到工作站再到本地集群
Jack Huynh 在主题演讲中给出了 AMD 对 AI 部署路径的三阶段拆解——开发、规模化测试、部署——分别对应三款产品:
Ryzen AI Max+ 395(开发阶段)。128GB 统一内存是核心卖点,Jack Huynh 主张这块芯片能在本地运行 200B 级前沿模型,整个模型在同一内存池中无需分片、无需卸载。市面上已有 35+ 款搭载 Ryzen AI Max 的系统,涵盖笔记本、一体机、紧凑型工作站,其中多款在中国上市。
Radeon AI Pro R9700 GPU(规模化测试)。专为"需要超越笔记本性能但还不需要生产基础设施"的开发者打造,用于原型开发、微调与推理。
Threadripper Pro 9000(部署阶段主机 CPU)。AMD 称其为"世界最快的工作站 CPU",提供 128 条 PCIe 5.0 通道,可从单一主机支撑多块 Radeon AI Pro GPU 协同运行,用于在本地构建多 Agent 同时运行的环境。
需要注意,"世界最快的工作站 CPU"是 AMD 自家表述,未给出与 Intel Xeon W、Apple M3 Ultra 等竞品的横向 benchmark 数据。
二、ROCm + 6 家中国模型 Day0 + 免费开发者云
软件栈是这次发布会信息量最密集的一块,Nick Ni 主讲。三个支柱:
开源 + 中国模型 Day0 支持。ROCm 现通过 Hugging Face 与魔搭社区支持超过 300 万模型,对以下国产前沿开源模型做到 Day0 支持:DeepSeek、阿里 Qwen、MiniMax、Kimi、阶跃星辰、小米 MiMo。 这条对中国 AI 开发者的实际价值:在 AMD 硬件上跑国产开源模型,理论上不需要等社区迁移——发布即可用。但 Day0 支持的实际质量(精度损失、性能损失、bug 数量)需要社区独立验证,Nick Ni 未给出量化数据。
抽象层。ROCm 原生支持 OpenAI Triton(这是 NVIDIA CUDA 生态外最关键的 GPU 编程抽象),并新增 Gluon、TileLang、FlyDSL 等项目,让 GPU 编程体验更接近写 Python。
AI 助手:AMD 用 Agent 开发 ROCm 自己。这是发布会上最有元意义的一个细节——AMD 内部有数千个 Agent 持续监控开源项目,识别 AMD 支持中的缺口,自动生成完整 PR(Pull Request),工程师起床前自动测试已完成。Nick Ni 给出数据:工程师 PR 提交频率从每周几个提升到每天几个。
免费开发者云(本次发布会公开宣布的核心增量之一)。AMD 推出首个面向中国 AI 开发者的公共 AI 开发者云,搭载 Radeon GPU,免费。同时通过与魔搭、阿里云合作,AMD GPU 现已直接在魔搭创空间中可用——这意味着开发者无需购买硬件就能跑通 AMD 全栈。
AMD AI Playbooks 网站同步推出,提供本地推理、强化学习、视频生成、微调等分步指南,Windows 与 Linux 双平台支持。AMD AI 开发者计划提供免费云端算力券、100+ 小时教学内容、专属社群、积分系统。
三、Cube01 与零一万物:本地企业 Agent 一体机
AMD 与零一万物联合发布的企业智能体一体机基于 Ryzen AI Max+ 395,采用统一内存架构,主打"本地同时运行数百个 Agent",实现安全私密的本地化部署。该产品在被标识为 Cube01。
李开复在炉边对话中给出了零一万物 2026 年的核心命题判断:
"2024 年的问题是 AI 能完成一项任务吗,2025 年是 AI 能完成一个完整的工作流吗,2026 年的问题就是 AI 能运营一个企业职能部门吗。"
他主张多智能体架构——规划智能体、批判智能体、执行智能体、风险控制智能体协同工作、相互辩论、彼此补充——这是 Cube01 + 万智平台试图打包成产品交付的对象。零一万物正专注于构建这样的平台。
李开复还提出两个不可妥协的企业核心命题:数据主权与可见的投资回报。前者直接对应 Cube01 主打的"本地化部署、数据不出本机"。
文章另一句值得划的观点:中国开源社区比喻——"硅谷的 AI 巨头像是渴望获得诺贝尔奖的天才,中国的 AI 生态则更像一个充满活力的去中心化学习小组,共同面对考试,相互学习,共同构建"。
四、阶跃星辰 Step 3.5 Flash:1960 亿参数跑出 100 token/s
发布会上最硬的一组数据点来自阶跃星辰 CTO 朱亦博的对谈:
- 阶跃星辰 Step 3.5 Flash(2026 年 2 月发布),从设计之初就以智能体任务为核心目标
- 模型约 1960 亿参数,4 位量化后能在 AMD 平台流畅运行
- 需要约 100GB 内存,而 Ryzen AI Max+ 395 恰好有 128GB 统一内存
- 通过与 AMD 工程师合作优化,Step 3.5 在 AMD 笔记本上解码速度接近每秒 100 个 Token
朱亦博的判断:未来 AI 模型一定是端云协同,本地能跑足够强的模型时,Token 成本将趋近于零。他透露很快阶跃星辰将发布智能体能力更强的新模型,仍可在 AMD 平台上流畅运行。
这组数据有几个值得 ChooseAI 读者额外关注的细节:
- 100 token/s 是解码速度,不是 prompt 处理速度,后者通常显著慢于前者
- 4 位量化对精度的影响、对工具调用准确率的影响,朱亦博未给出量化对比数据
- "比很多云端 API 还要快"——这里"很多"具体指哪些 API、什么并发条件、什么 prompt 长度,没有说明
但即便如此,"近 200B 模型在笔记本上 100 token/s"是当前消费级硬件运行大模型公开数据中相对靠前的水平,对独立开发者评估"本地 Agent 是否可行"有直接参考价值。
五、无问芯穹 × AMD:物理 AI 推理框架 RLinf 数据披露
清华大学教授、无问芯穹发起人汪玉披露了无问芯穹与 AMD 联合开发的物理 AI 大规模开源推理服务框架 RLinf:
- 4 个月内获得超过 3300 GitHub Star
汪玉给出了"AI 生产力"公式:智能规模 × Token 生产效率 × Token 价值转化。其中智能规模的瓶颈在算力限制,无问芯穹开发的跨区域分布式训练技术能将不同数据中心的算力汇聚成大规模集群,突破单一地点的算力约束——这是无问芯穹差异化的核心。
无问芯穹平台已集成百川、智谱 GLM、Kimi 等顶尖模型。汪玉判断未来十年属于物理 AI——把智能从数字屏幕中带出来,通过具身系统融入物理现实。
汪玉给下一代教育的三点建议值得划:做 AI 原住民、培养品味(在 AI 能提供所有答案时,最重要的是提出有价值的问题)、解决真实问题。
六、局限与待观察
读完这场发布会的完整报道,有几个AMD 没明说但实操前应该想清楚的边界:
第一,Cube01 关键商业信息仍未公开。发布会演讲均未给出 Cube01 的定价、量产时间、销售渠道、首批签约客户名单——上一稿提到的局限到这次发布会结束仍未消除。
第二,Day0 支持的实际质量未量化。ROCm 对 DeepSeek、Qwen、MiniMax、Kimi、阶跃星辰、小米 MiMo 的 Day0 支持是一个承诺,但精度损失、性能差距(vs NVIDIA H100/A100/RTX 4090)、bug 数量未给出对比数据。社区需要独立 benchmark 验证。
第三,免费开发者云的可持续性。AMD 推出免费的中国 AI 开发者云,但配额、上限、长期可持续性政策未公开。这是经典的获客补贴期产品,长期价格策略需要观察。
第四,阶跃星辰 100 token/s 的复现门槛。这是单一公司、单一模型、单一硬件、与 AMD 工程师深度合作优化后的数据。其他中国大模型在 Ryzen AI Max+ 395 上能否达到相近水平,完全依赖各家自己的工程投入。Day0 支持不等于 100 token/s。
第五,"世界最快工作站 CPU"等表述未给横向 benchmark。Threadripper Pro 9000 的"世界最快"说法是 AMD 自家表述,未给出与 Intel Xeon W、Apple M3 Ultra 的对比数据——这类表述读者需要自行验证。
七、给 ChooseAI 读者的 几个判断
把这场发布会压缩成几个对独立开发者的判断:
- 如果你在评估"本地能不能跑大模型":阶跃星辰 Step 3.5 Flash 的 1960 亿参数 + Ryzen AI Max+ 395 + 100 token/s 是目前消费级硬件公开数据中较靠前的参考点——但要看到这是深度合作优化的结果,不是开箱即用
- 如果你在 ROCm 上跑国产开源模型:Day0 承诺已经覆盖 6 家头部,前期可行性比一年前明显改善——但建议先跑 benchmark 再决定是否迁移
- 如果你想试 AMD 全栈但不想买硬件:免费的中国 AI 开发者云 + 魔搭创空间集成是新增的低成本入口,值得占坑
- 如果你做 Agent 工具/平台:RLinf 等开源框架 + AMD 内部"用 Agent 开发 ROCm"的元方法,对 OpenClaw、Hermes 等本地 Agent 框架的设计有直接借鉴
 AI 速览