5月29日消息,阶跃星辰发布并开源 Step 3.7 Flash,权重以 Apache 2.0 协议放出。这款模型延续上一代 Step 3.5 Flash 的"为 Agent 而生"思路,定位明确——主打 Agent 效率,面向智能体、编码、搜索与多模态工作流,在速度、成本与可靠执行之间找平衡。GitHub、HuggingFace、ModelScope 同步上线,并提供 GGUF 量化格式与官方 API。
架构与速度:稀疏 MoE,198B 总参仅激活约 11B
Step 3.7 Flash 采用稀疏 MoE 架构,总参数 198B,每 token 仅激活约 11B,沿用了 3.5 Flash 的"高智能密度"路线:保留大模型的推理深度,同时以小模型的速度执行。相比上一代 196B/11B、峰值 350 TPS,3.7 Flash 把吞吐推到 400 TPS,支持 256K 上下文,并提供三档推理级别,让开发者按任务在响应速度与推理深度之间做取舍。
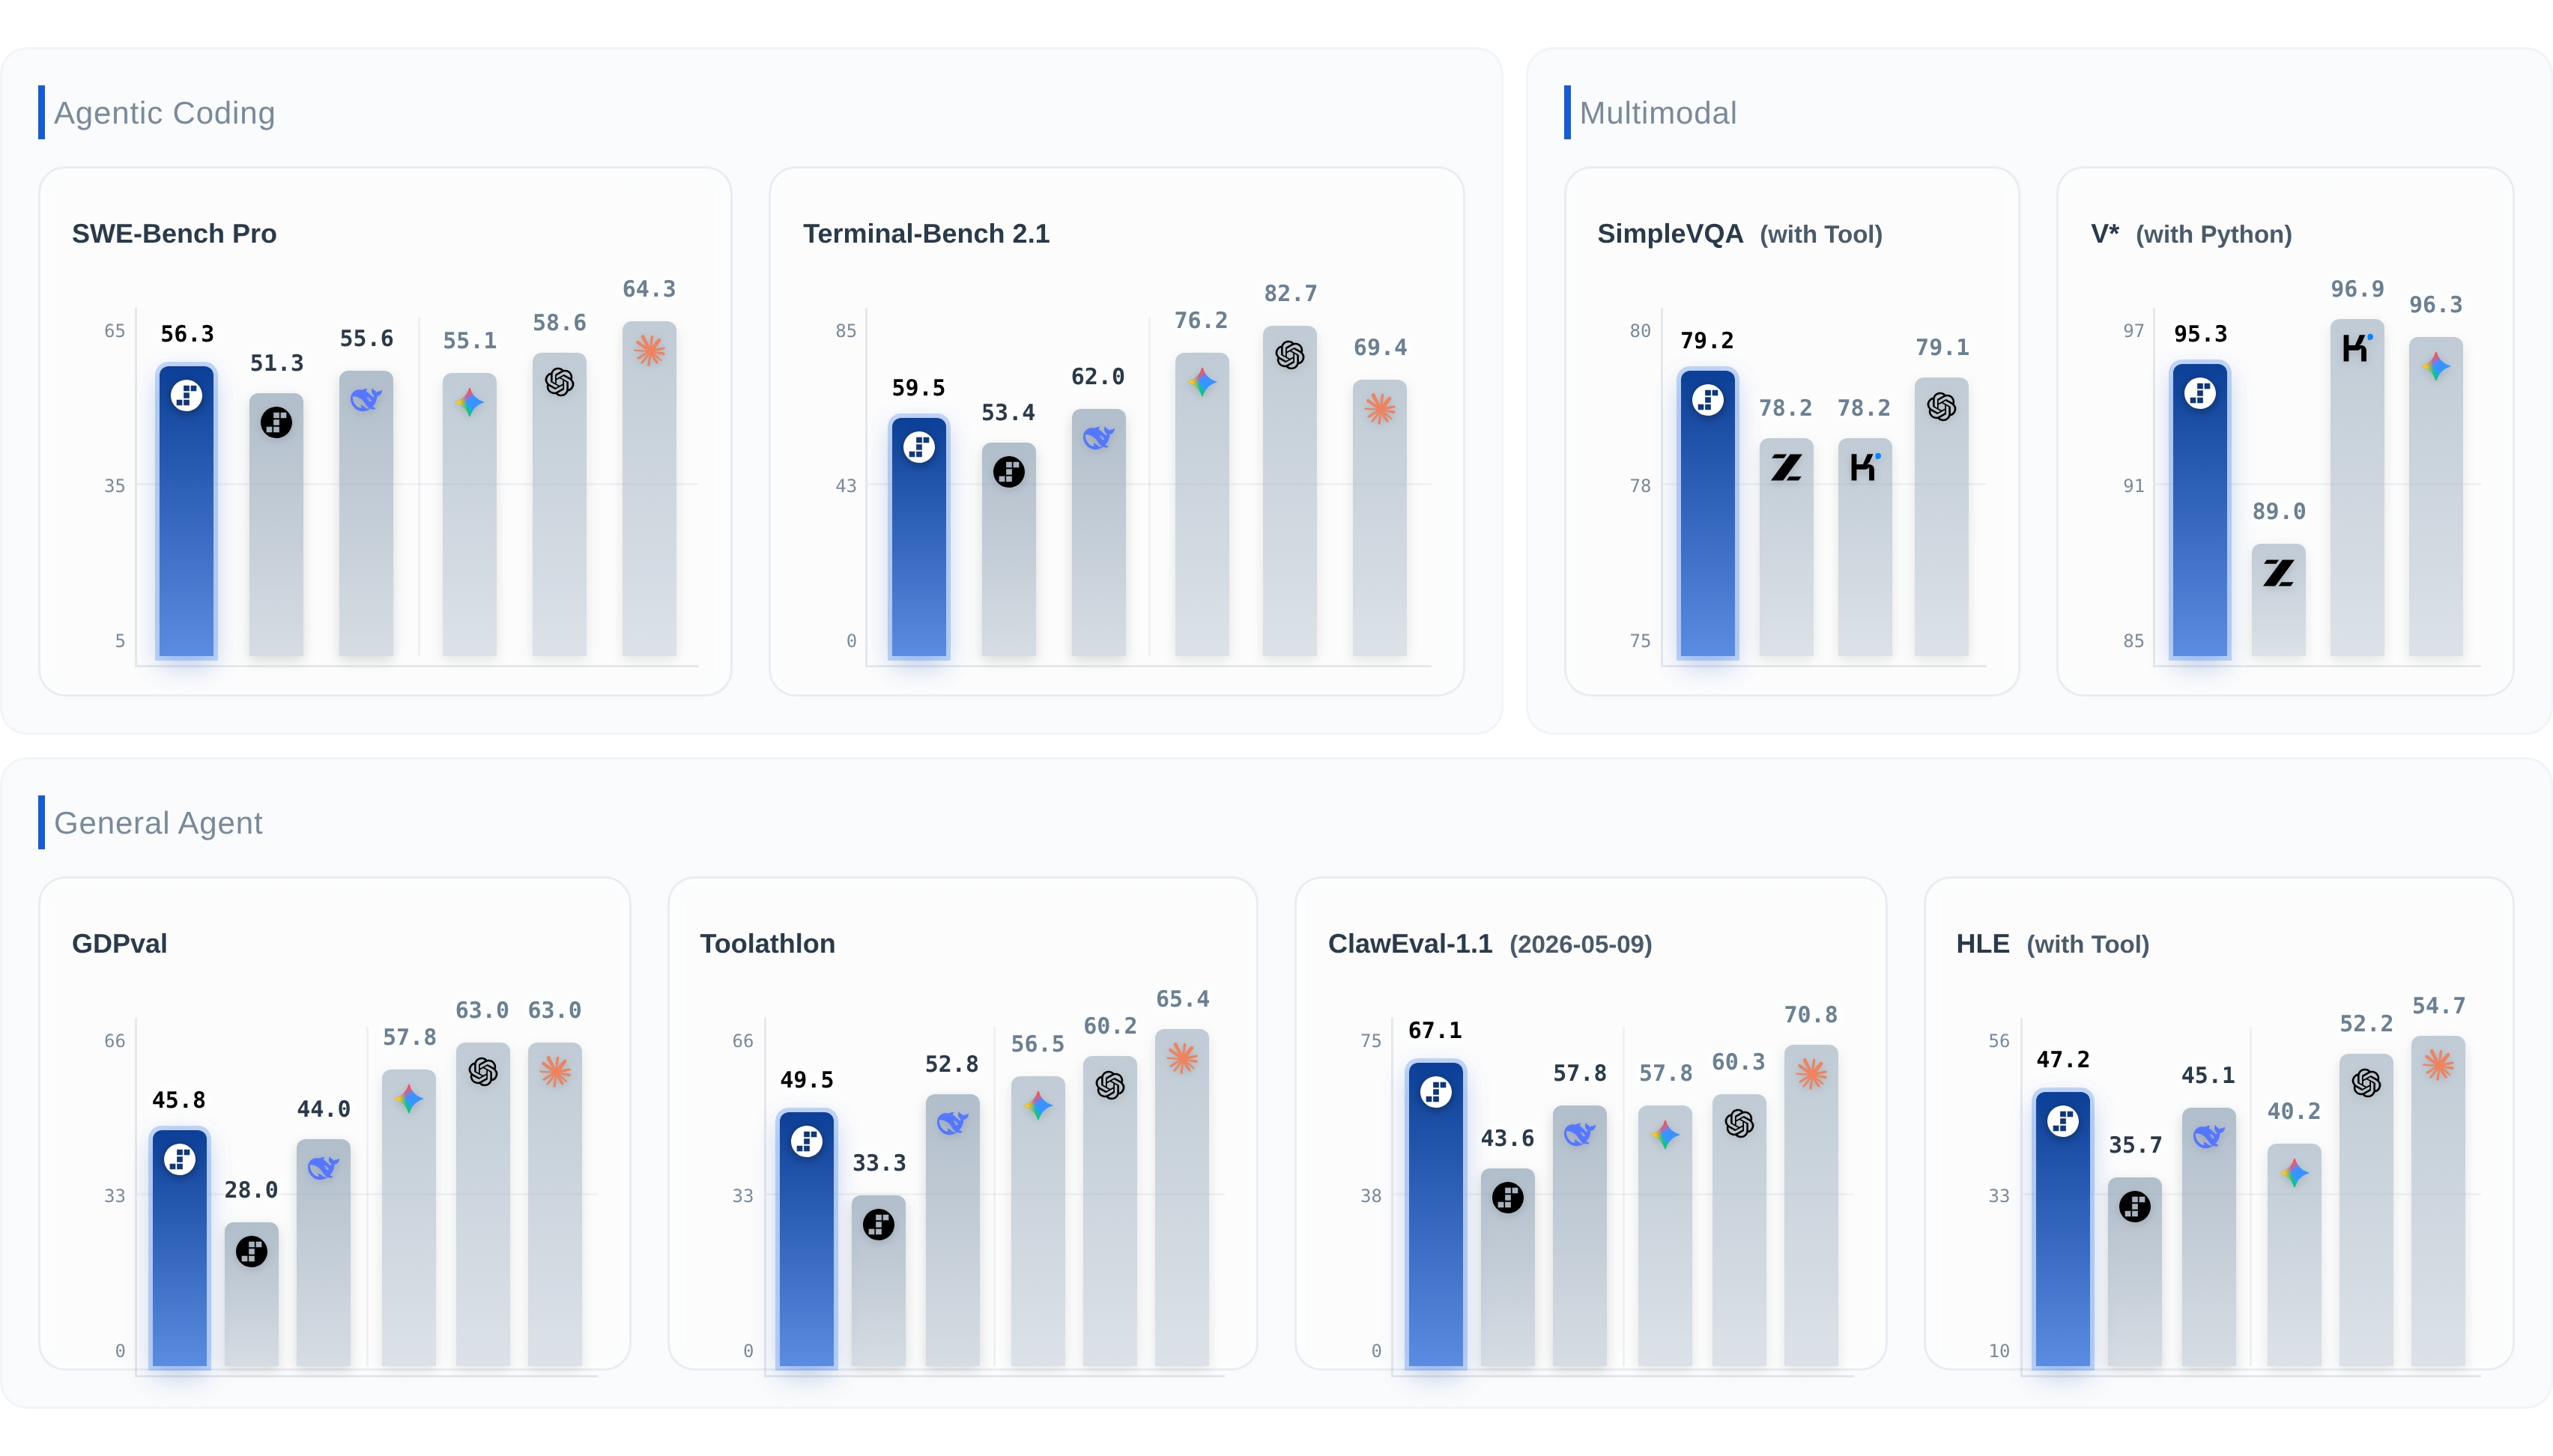
按官方公布的成绩,Step 3.7 Flash 在 ClawEval-1.1 上以 67.1 登顶、SimpleVQA Search 以 79.2 登顶,SWE-PRO 56.3 位列第二,V* Python 一项达 95.3。
多模态加工具调用:看懂界面再动手
与纯文本模型不同,Step 3.7 Flash 把多模态理解与执行能力绑在一起。它能读懂界面、图表、文档与图像,再据此写代码或调用工具,对所见内容采取行动——这正是 Agent 在真实环境里所需的"感知—决策—执行"闭环。搜索能力上,它结合网页与视觉搜索,官方称可触达更多来源、支持更深入的追问。
工具调用的可靠性是这次强调的重点。官方称模型在工具使用上漂移更少、失败的工具调用更少,在 τ²-bench 各难度级别上均达到 98% 以上。对长链路 Agent 任务而言,工具调用一旦中途出错,整条任务就可能崩掉,因此稳定性往往比单点能力更关键——这也是阶跃星辰把"可靠执行"与速度、成本并列为三大目标的原因。
框架兼容与本地部署
落地层面,Step 3.7 Flash 兼容 Claude Code、KiloCode、Hermes Agent、OpenClaw 等主流 Agent 工具,并支持 MCP 等协议,可直接接入现有的智能体工作流而非另起一套。部署上它能在 Mac Studio M4 Max、DGX Spark、AMD AI Max+ 395 等设备本地运行,配合 GGUF 量化与 256K 上下文,把"云端级别的长文本与 Agent 能力"带到了本地硬件。对依赖开源框架自建 Agent 系统的开发者,本地可跑加开放权重,意味着更低的调用成本与更强的数据可控性。 放进开源模型竞争里看
把 Step 3.7 Flash 放进国产开源模型的格局中,它要面对的是一条相当拥挤的赛道。DeepSeek、阿里 Qwen、月之暗面 Kimi、智谱 GLM、MiniMax 乃至美团 LongCat 都在稀疏 MoE 与 Agent 方向上持续投入,各家在激活参数、上下文长度、工具调用能力上分头优化。阶跃星辰的差异化,在于把发布叙事的重心明确放在"Agent 效率"上——不是单纯比拼某项 benchmark 的绝对分数,而是强调速度、成本与执行可靠性的组合,以及多模态感知与工具调用的一体化。 与闭源阵营相比,这条路线也在直接对位 Gemini Flash 这类"快而省"的轻量模型,只是以开放权重和本地可部署作为筹码。当前需要观察的有两点:一是官方公布的多项登顶数据能否经受第三方榜单与真实任务的验证,二是 198B 总参在本地设备上的实际显存占用与长上下文表现——这决定了它究竟是榜单上的强者,还是开发者日常 Agent 流程里真正用得顺手的那一个。  AI 速览