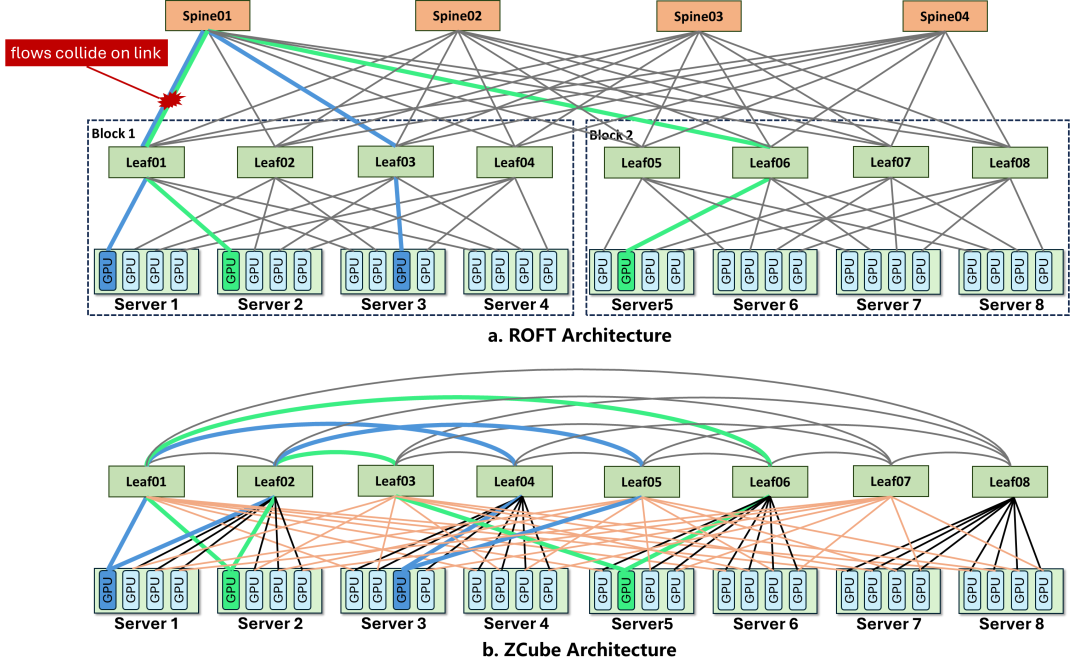
智谱联合驭驯网络、清华大学发布的新一代大模型推理网络架构ZCube,已在运行GLM-5.1 coding服务的千卡推理集群完成生产部署,在保持GPU与软件栈不变的前提下,GPU平均推理吞吐提升15%、首Token时延P99下降40.6%、交换机与光模块资本支出减少约33%。这是ZCube架构首次在大规模生产推理集群落地,原论文已发表于网络领域顶会ACM SIGCOMM 2025。
问题源头:PD分离让推理流量变得"不对称"
大模型推理的部署重心正在向PD分离倾斜。Prefill与Decode分离带来明显好处——两类计算的资源利用率可独立调优——但代价是KV Cache需要在节点间持续传输,集群内部通信压力显著上升。
智谱在32卡推理服务上做过控制变量实验:保持GPU算力和软件栈不变,仅将网卡可用带宽从100Gbps提升到200Gbps,整体推理吞吐提升约19%、TTFT下降约22%。这组数据说明,在当前主流推理负载下,网络带宽已经成为吞吐和延迟的关键约束之一。
更棘手的是流量模式本身。PD分离场景下KV Cache传输具有明显的源-目的不对称性,不同GPU、不同网卡承担的通信负载差异很大。传统Clos架构(Fat-Tree)通过多层交换机堆叠扩展规模,业界进一步衍生出ROFT(Rail Optimized Fat-Tree)按rail编号分组接入,在训练场景的对称流量下表现良好。但ROFT的rail映射本质上是静态的,遇到推理这类高度不对称的流量时,反而会把通信压力集中到少数Leaf交换机和链路上。
实测中可以观察到三个典型现象:部分Leaf交换机成为负载热点,KV Cache传输实际速率明显低于网卡带宽上限;部分出口队列深度持续高位,频繁触发PFC反压;链路拥塞放大尾时延,进一步影响TTFT和整体吞吐。
ZCube团队把拥塞分成两类:一类是物理上"不可避免的拥塞",比如多个GPU同时向同一目的地发送数据,最后一跳必然竞争;另一类是"可避免的拥塞",本质上源自拓扑结构和路由映射不匹配流量模式。ZCube要解决的是后者。
ZCube核心设计:扁平拓扑+单多轨混合接入
ZCube的思路是把"分层堆叠+静态映射"换成"扁平+离散化"。架构上有三个关键设计:
第一,取消Spine层交换机,整个网络做成两层扁平结构,网络直径从传统Fat-Tree的3跳压缩到2跳。
第二,Leaf交换机按序号奇偶分成两组,两组之间做完全二部图互联——每台奇数交换机与所有偶数交换机直连。
第三,网卡双端口分别走"单轨"和"多轨"两种接入方式——一个端口连接相同标号GPU所在的交换机(多轨),另一个连接连续标号GPU所在的交换机(单轨)。
这套组合产生了一个关键性质:任意一对GPU之间只有一条最优路径,从源头消除了多路径选路时可能出现的负载不均问题。同时,单/多轨混合接入让ZCube能同时适配训练场景的对称流量模式(AllReduce、All2All)和推理场景的非对称流量模式,在全网交换机间实现更接近理想的负载均衡。
扩展性方面,按业界主流配置——单台51.2T容量交换机(128个400Gbps端口)——ZCube可支持16384张400G卡的单平面互联。若使用更高容量交换机或划分多平面,理论上可扩展到数万乃至数十万卡级别。
千卡集群实测:成本与性能同步优化
智谱在一个运行GLM-5.1 coding推理服务的千卡集群中完成了ROFT→ZCube的实际改造。由于ZCube取消了Spine层,原有的布线模式、IP编址、路由策略和交换机配置都需要重新设计,驭驯网络团队为此开发了ZCube控制器、机房布局设计工具和连线正确性检测程序等配套工具链,支持机房部署规划、布线校验和配置自动下发。
改造完成后的实测结果,相比改造前的ROFT架构:
按万卡集群规模折算,ZCube相比ROFT/Clos的网络硬件投资节省约2.1亿到6.4亿元。集群在改造完成后已稳定运行两周多。
值得注意的是,这套成本下降并非以性能为代价换取——网络硬件减少的同时吞吐反而提升,这在传统网络架构改造中并不常见。这背后的原因被归结为"架构层的负载均衡天然优势":当全网流量更均匀地分布在更少的交换机上,单位硬件的有效带宽利用率自然上升。
横向对比:与协议层方案的路线分化
ZCube解决"可避免的拥塞"走的是拓扑重构路线,而业界另一条主流路径是保留Clos架构、通过协议层改进缓解负载不均:
- UEC(Ultra Ethernet Consortium)v1.0.1:通过packet spraying将流量在多路径间打散
- NVIDIA Spectrum-X:基于adaptive routing做动态路径选择
- 微软MRC+SRv6:从弹性容错角度优化AI超算网络
两条路线各有取舍。协议层方案不需要改动物理拓扑,软件升级即可应用于存量集群,迁移门槛较低;拓扑层方案则在硬件成本和负载均衡上限上有更大优化空间,但需要重新设计组网。对于自建大规模推理集群、且具备配套网络工程能力的玩家,拓扑层创新可以一次性吃下成本与性能两端的收益;对于使用标准化Clos机房的中小推理服务商,协议层方案的迁移门槛更友好。
未来一段时间内,两条路线大概率并行发展,而非彼此替代——具体选型取决于集群规模、新建/存量场景,以及对网络工程团队的依赖度。
落地考量:扩展性、容错与工具链生态
任何架构创新都需要回到生产环境的多维考量。从已公开信息看,ZCube在大规模推广过程中还有几个方向值得后续关注。
扩展性方面,ZCube单平面在主流交换机容量下可支持约16K张400G卡。要进一步扩展到数万乃至数十万卡规模,需要划分多平面,平面间通信路径与负载均衡机制是值得关注的工程细节。
故障容错方面,"任意一对GPU之间唯一最优路径"是ZCube实现完美负载均衡的关键,反过来也意味着冗余度低于传统多路径Clos架构。生产推理集群7×24运行场景下,单链路或单交换机故障的快速切换机制、降级路径的性能特征,是评估稳定性的核心指标。
布线复杂度方面,奇偶两组交换机的完全二部图互联使机房物理布线的复杂度高于传统Fat-Tree,万卡规模下光纤数量呈平方级增长。智谱与驭驯网络专门开发了机房布局设计工具和连线检测程序来应对,这本身也说明部署门槛较高、对部署方的网络工程能力要求高于沿用Clos的传统方案。
评测覆盖范围方面,公开数据基于GLM-5.1 coding单一应用的千卡集群,运行周期两周多。MoE模型在All2All负载下的表现、超长上下文场景、不同batch size下的稳定性、训练场景的实测数据等维度,目前尚未完整公开。后续在更多模型与负载下的实测,会进一步明确ZCube的适用边界。
存量集群迁移方面,由于ZCube与Clos在布线、IP编址、路由策略上不兼容,存量Clos集群迁移属于"重建"而非"升级",迁移期间业务需停机。这一特性让ZCube更适合新建集群,而非对存量集群做改造。
推理基础设施的下一步:从通用互联到流量协同
ZCube这次落地传递的更大信号,是大模型推理基础设施的优化重心正在从GPU、推理引擎下沉到网络层。
过去几年AI集群的网络设计很大程度上沿用了HPC时代的Clos思路,假定流量模式相对对称、可预测。但PD分离、长上下文推理、MoE专家路由、训推一体等新趋势正在改变集群内部通信的基本模式——KV Cache跨节点传输、专家间All2All、训练推理共享集群的流量混合,让"通用互联"的假设越来越难站住脚。
对推理服务商和模型公司而言,从ZCube这次落地能提炼出几条实践层面的判断:
网络已经成为MaaS综合成本的核心变量之一,GPU、推理引擎、网络三者协同优化的边际收益开始超过单点优化;架构层创新与协议层创新需要并行评估,新建大规模集群时拓扑选型应当与流量模型共同设计;网络团队的角色正在前置,从底层支撑性基础设施变成影响推理系统吞吐与时延的关键变量。
ZCube之外,UEC packet spraying、NVIDIA Spectrum-X、MRC+SRv6等协议层方案也都在持续演进。未来一到两年,推理网络很可能进入"拓扑层+协议层"双线创新并存的阶段,不同规模、不同业务结构的玩家会逐渐分化出不同的最优路线。对于规模化推理服务来说,网络已经不再只是"连接GPU的电缆",而是直接影响Token生产效率、系统稳定性与单位成本的核心能力。
 AI 速览