5月22日消息,智谱面向部分企业客户开放GLM-5.1高速版API"GLM-5.1-highspeed",模型输出速度达到400 tokens/s。智谱方面表示这一数字刷新了当前全球大模型API的速度上限,关键意义不在于"快",而在于这是一款旗舰级模型——过去高速API几乎等同于轻量级模型,GLM-5.1高速版是国产模型中首次把旗舰能力与极致低延迟同时带进生产环境的样本。
不是小模型快,而是旗舰模型快
行业内"高速模型"长期是一个有妥协色彩的概念。Groq、SambaNova等专用推理硬件路线早期主打的高速API,往往跑的是Llama 8B、Mixtral等中小模型;国内类似的高速通道也多数对应蒸馏版或精简版。GLM-5.1高速版的差异点在于完整保留了GLM-5.1的能力,只在工程侧把吞吐拉到400 tokens/s。
智谱给出的体感差异是:一位写作者数天的文字产出量,模型在1分钟内交付;一个工程师约3天的开发任务,可在数分钟内跑完。这个比喻偏宣传向,但折算到Coding Agent场景里逻辑成立——Agent任务通常需要数十轮模型调用,单轮慢几秒,整体就被拉长十几分钟;面对大型重构这类长程任务,每步多1秒都会以分钟为单位累加。
在两个具体演示中,GLM-5.1高速版在30秒内完成了一个复杂网页的生成,并在Agent Swarm调度中同时驱动50个不同人格的并行回答。智谱将这一速度变化的产品意义概括为"模型从异步工具变成实时协作伙伴",并展示了三类典型场景:边理解工程上下文边生成代码与修改方案、玩家在3D地图中输入文字即时改变场景建模、用户提需求的同时生成匹配的工具与交互界面——最后一种被智谱称作"新型操作系统的雏形"。
TileRT:把推理图编进一个常驻GPU的Kernel
400 tokens/s的工程实现由智谱GLM团队与TileRT团队联合完成,分别在推理引擎、调度系统、基础设施三层做了重写。
推理引擎层针对GLM-5.1的架构重写了核心推理路径,提升单卡吞吐;调度系统层引入动态批处理、请求合并与KV缓存调度优化,降低高并发下的尾延迟;基础设施层围绕推理集群部署、网络链路与负载均衡协同优化,目标是让400 TPS是稳定数值而不是峰值。
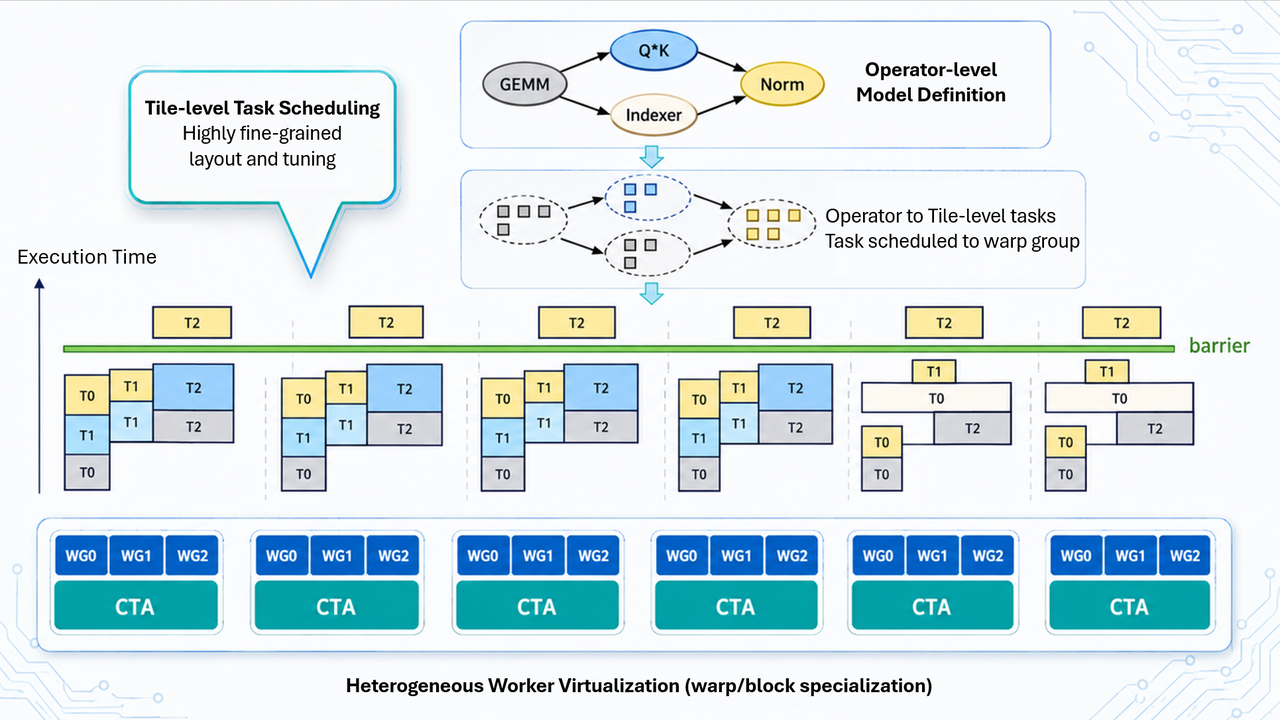
技术上更值得关注的是TileRT的设计思路。当前主流推理框架仍以operator/kernel为基本调度单元,每个算子都要走完"host启动→读权重→计算→写回→同步"的链路,在单token、小batch、多卡TP场景下,算子被切到微秒级,原本可忽略的调度、访存与同步开销会被迅速放大。
TileRT的做法是彻底抛弃Runtime层的动态调度,在编译期(AOT)将整个计算图静态编排为一个常驻GPU的persistent Engine Kernel。单卡内,计算、异步IO与通信全部拆解为Tile级微任务,整个推理只Launch一次Engine Kernel,算子间的中间结果不再写回Global Memory,而是经Register、Shared Memory与L2 Cache直传。多卡尺度上,TileRT把SM内部的Warp Specialization思路外推到整张8卡NVL拓扑,不同GPU rank不再执行同构逻辑,而是按计算密度与数据依赖被特化为不同worker。
这一路线本质上是用编译期静态调度换运行时灵活性,与vLLM、TensorRT-LLM等主流方案的Runtime-heavy路径形成对照。
竞品对比:海外高速API与国内常规吞吐
横向比较有助于理解400 tokens/s的位置。海外侧,Groq基于LPU硬件的Llama 70B推理速度在200-300 tokens/s区间,Cerebras Inference对部分中等规模模型曾报出更高数字,但这些路线依赖专用推理硬件,且模型规模与GLM-5.1旗舰版不完全对位。SambaNova走的是类似路径。
国内侧,主流厂商通用旗舰API(如DeepSeek-V3、Qwen3-Max、Doubao-1.5-pro、Kimi K2系列)的常规输出速度多在30-100 tokens/s区间,部分轻量版本能跑到150-200 tokens/s,但旗舰模型保持400 tokens/s级别的公开案例此前没有。 差异化层面,GLM-5.1高速版强调的不是硬件特化,而是软件栈层面的工程优化,理论上更容易在标准GPU集群上复制。这也是TileRT技术博客把方法论公开的潜在意图——把"速度作为下一个scaling维度"的论述推向行业。
局限性:企业灰度、场景限定与未公开维度
几个待观察的点比较明显。
一是开放范围。GLM-5.1高速版目前仅面向智谱MaaS平台部分企业客户提供,没有公开个人开发者入口和定价信息,普通用户暂时无法测试,社区难以独立验证400 tokens/s在不同负载下的稳定表现。
二是技术细节透明度。智谱与TileRT团队公开了架构思路,但量化方案、上下文长度限制、长上下文场景下速度衰减曲线、不同输入长度对应的TTFT(首token时延)等关键指标尚未给出完整数据。
三是场景适配。Coding、Agent调度、实时交互等场景对速度收益最敏感,但部分对推理深度要求高的任务(复杂数学、长程规划),未必能从tokens/s的提升中线性获益,这取决于模型在加速路径下是否保留了完整的推理能力。
四是与GLM-5.1普通版的定位切分。是面向高优先级客户的SLA增强通路,还是会逐步合并为默认能力,目前未明确。
对开发者而言,GLM-5.1高速版的意义更接近一个信号——当模型能力进入相对平台期,工程层面的tokens/s有可能成为下一阶段的主要竞争维度。智谱与TileRT的组合给出了一个不依赖专用推理硬件的解法样本,后续Qwen、DeepSeek、字节豆包等是否跟进类似的全栈推理重构,是值得跟踪的方向。  AI 速览