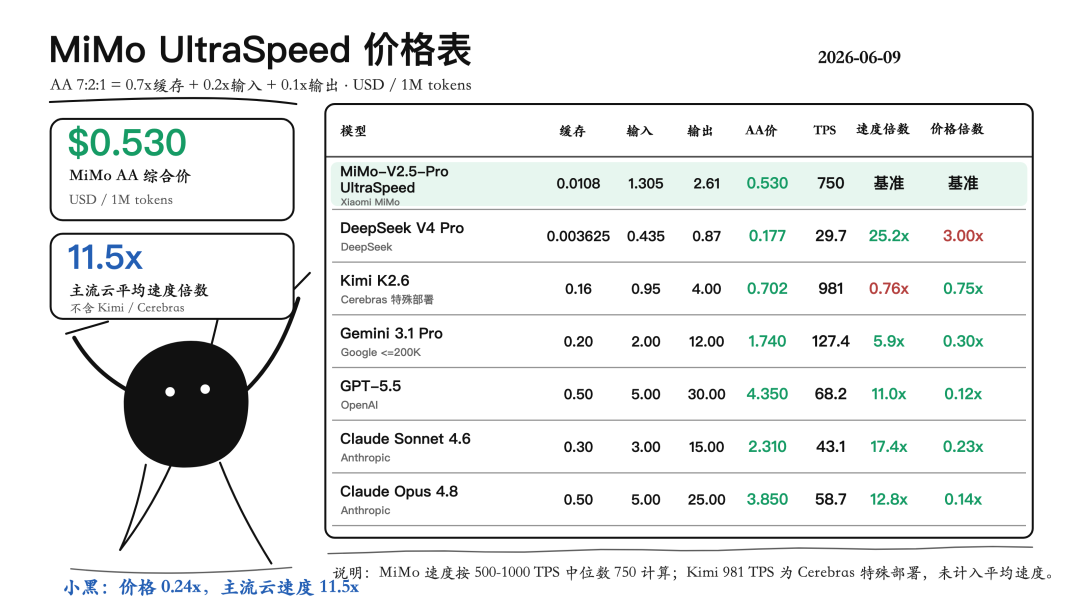
6 月 9 日,小米正式上线 MiMo-V2.5-Pro UltraSpeed 极速模式,在单 8 卡 NVIDIA GPU 节点上实现万亿参数 MoE 模型 750-1000token/s 的推理速度,峰值突破 2140token/s,比主流大模型快 6 倍以上。结合此前 99% 的大幅降价,该模式成为当前速度与性价比双优的标杆产品,彻底打破 “快模型必然低质” 的行业偏见。
一、性能价格双碾压,全面超越主流竞品
官方公布的综合对比数据显示,MiMo UltraSpeed 采用 7:2:1 加权定价公式,综合 AA 价仅为 0.53 美元 / 百万 token。
在速度方面,其常规输出速度 750token/s,是 DeepSeek V4 Pro 的 25 倍、GPT-5.5 的 11 倍、Claude Opus 4.8 的 12.8 倍。唯一速度接近的 Kimi K2.6(981token/s)依赖 Cerebras 晶圆级芯片私有部署,无法大规模普及;而 MiMo UltraSpeed 基于通用 GPU 集群实现,具备规模化商用能力。价格方面,其综合成本仅为 GPT-5.5 的 12%、Claude Opus 4.8 的 14%,在保证顶尖性能的同时,将推理成本降至行业新低。 二、多场景实测验证:速度与质量兼得
实测数据证实,UltraSpeed 模式并未牺牲模型能力。
网页开发场景中,同一个复杂提示词测试,思考过程稳定在 700token/s 以上,输出峰值达 2140token/s;接入 Claude Code UltraCode 模式后,生成的网页交互性与多尺寸适配度,与 GPT-5.5 high 模式开发效果相当。 3D 创作方面,仅用 3 分钟就生成了包含灯光、特效、互动逻辑的吉他英雄游戏页面。
最震撼的是多 Agent 批量任务:12 个智能体协同读取多个 Github 项目,完成升级分析、可读性检测、README 统一风格等复杂工作,仅耗时 11 分钟,同等任务此前需通宵运行。作者还基于该模型开发了 mini loop Skill,可自动检测并优化新 Skill 的易用性。
三、三大核心技术,破解提速不降质难题
MiMo UltraSpeed 的速度突破并非依赖小模型阉割,而是通过三项技术创新实现:
首先采用FP4 混合量化技术,在不损失模型能力的前提下大幅压缩参数体积;
其次引入提前草稿机制,先用低成本方式快速生成候选 token,主模型仅需验证修正,类似输入法整句联想,避免逐字计算;
最后优化GPU 流水线调度,将计算、数据搬运、通信环节并行化,让 GPU 持续满负荷运行。
这套组合拳让万亿参数 MoE 模型实现了千级 token/s 输出,同时保持了 MiMo-V2.5-Pro 的原有能力水平,在代码开发、逻辑推理、多模态生成等维度均表现稳定。
四、生态适配与使用指南
目前 MiMo UltraSpeed 已支持接入 Claude Code 桌面版,用户只需在供应商配置中添加对应 API 密钥,开启路由功能即可使用。
配合动态工作流能力,可高效处理代码迁移、项目重构、批量文档处理等重度任务。随着极速模式的推出,AI 开发效率迎来质的飞跃。此前需要数小时完成的复杂任务,如今压缩至分钟级,开发者无需再等待模型输出,可将更多精力投入创意与架构设计。
这款兼具速度、质量与性价比的模型,有望重塑大模型推理市场格局,推动 AI 应用进一步规模化落地。
 AI 速览