用 Hermes 折腾了一段时间,真正让人头疼的坑,不是认证、不是跑通工具,是 Model 和 Skill 怎么配这件事。
踩了一圈弯路之后发现,这两样没配好,模型再贵也是白瞎。下面 3 个错误你大概率会碰到,一起说清楚,最后再附 8 个每天都能用到、不花一分钱的内置 Skill。
先搞清楚两个基本概念
Skill 是一份说明书,告诉模型做某件具体的事要按什么步骤来,注意什么,最后输出成什么格式。
有一点特别重要:Skill 只在你调用的时候才加载,配再多也不多花钱,但它能让模型不再靠猜来干活。
Model 和 Skill 是乘法关系。任何一个为零,结果就是零。
Hermes 新手容易忽略的三大错误
错误一:把它当普通聊天在用
你大概这样用过——装好之后直接说"帮我写本周工作总结",它也写了,还写得挺长。但读下来就一个感觉:用 AI 腔把你上周做的事重新念了一遍,没重点,没结构,你老板关心的关键数据一个没提。
原因很简单,它不知道你在什么公司、什么岗位、老板看重什么 KPI。你让它猜,它就乱猜。
解决方式是先看看 Hermes 自带哪些说明书。装好后它带了 70 多个,开箱即用。终端输入:
太长的话按关键词搜:
找到对应功能之后,直接说人话就行——"帮我把这个 YouTube 视频总结成三条要点"、"帮我把这份合同的重点提取出来",这样比空口让它猜稳得多。
错误二:觉得模型越贵效果越好
买了最贵的订阅,让它写竞品分析,第一次确实不错,跑多几次质量就开始飘。
问题在于——你让一个很聪明的人做事,但没给他任何背景和框架。他可能花大篇幅写行业历史,但你真正要的是竞品对比和定价差异。
看一下 2026 年 5 月的实际定价差距:
- DeepSeek V4 Flash 的 API 价格约为每百万 token 输入 0.28
- GPT-5.5 则是每百万 token 输入 30.00
差距大概在 35 到 100 倍之间。
重点不是便不便宜,而是:便宜模型 + 好说明书,真的能跑赢贵模型 + 没说明书。 说明书把路画好了,弱一点的模型跟着走,比贵模型靠感觉猜要稳定得多。
新手不用一上来就买最贵的。从便宜模型开始,先把 Skill 配好,效果够用了再考虑升级。
错误三:换模型太频繁,不给它适应时间
用 DeepSeek 配好了一套,跑了两周效果挺好。听说 GPT 更强,马上切过去,结果之前好用的套路开始出问题——格式不对、步骤跳着走、甚至卡住。
每个模型性格不一样:
- DeepSeek:中文能力强,但你要把话说清楚,说模糊了容易绕弯
- Claude:擅长按规矩办事,说明书可以写得简单些
同一份说明书,不同模型读,效果差很多。
换模型之后,先跑一遍你最常用的几个任务,看看有没有变差。变差了,就把话说得更明确一点。Hermes 里可以设几种"工作模式",一个跑 DeepSeek,一个跑 GPT,互相不干扰,随时切换。
8 个免费 Skill,按使用场景分
场景一:快速消化别人的内容
youtube-content —— 看到一个半小时视频没时间看:
它会抓字幕,整理成几条重点。
nano-pdf —— 收到几十页 PDF 不想从头读:
ocr-and-documents —— 截图里的字一秒变文字:
不用装任何 OCR 软件。
场景二:写完东西,想让它不像 AI 写的
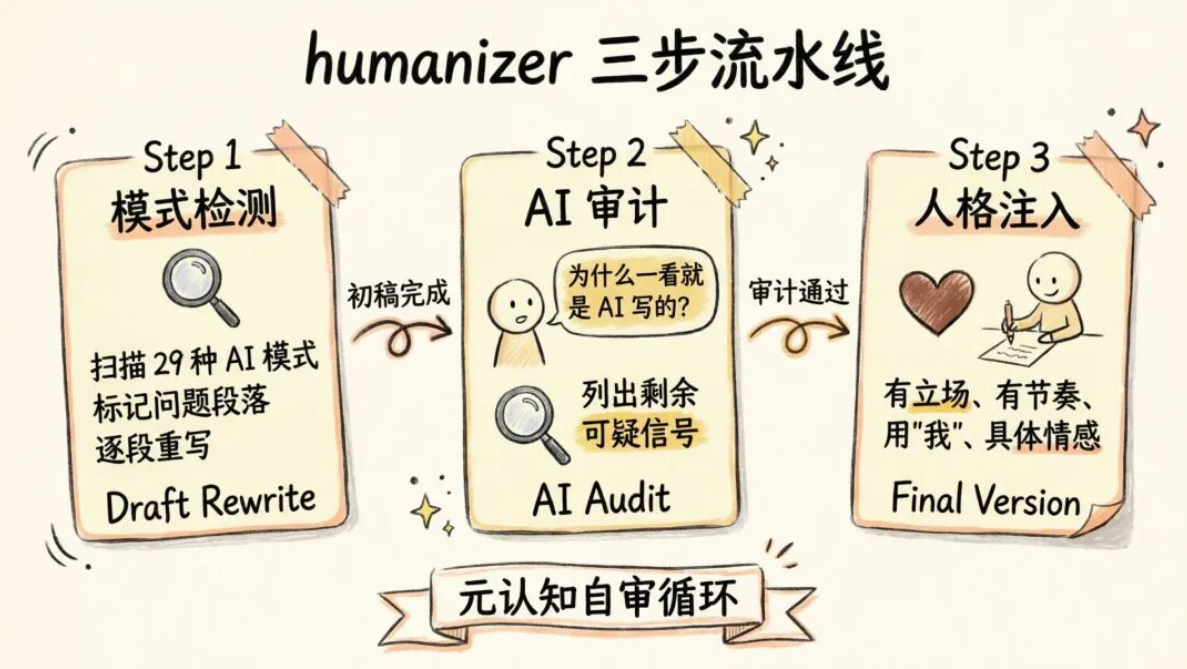
humanizer —— 改语气,让文字更像人说的:
avoid-ai-writing —— 比 humanizer 更彻底的清洗。它有一份 100 多个常见 AI 写作词的替换表,两遍审计——第一遍找问题,第二遍验证修改。"值得注意的是""与此同时""具有重要意义"这些词会被全部清掉。
区别很简单:想改语气用 humanizer,想标准化清洗 AI 痕迹用 avoid-ai-writing。
这个是社区 Skill,需要手动装一下:
场景三:抓网页、搜信息
defuddle —— 普通抓网页,90% 是导航、广告、页脚,token 全浪费在这些上面。defuddle 先过一遍 reader mode,只把正文给模型,省下 5 到 10 倍的 token 消耗。
felo-search + felo-web-fetch —— 带来源验证的搜索。felo-search 合成答案的同时标记来源,还会提示"这条信息可能过期"。felo-web-fetch 把网页干净提取成 markdown 或纯文本。做内容研究的话,这两个组合比默认 web search 强不少。
场景四:随口说就出图
excalidraw —— 不用学任何设计软件:
直接给你一张手绘风格的图,能拿去做配图。
花十分钟搞清楚怎么给模型配好说明书,比你换来换去折腾贵模型要值得多。Hermes 的核心逻辑就这一句:便宜模型 + 好 Skill,稳定性和效果都能超过贵模型裸跑。 新手从这里入手,比什么都快。
 AI 速览