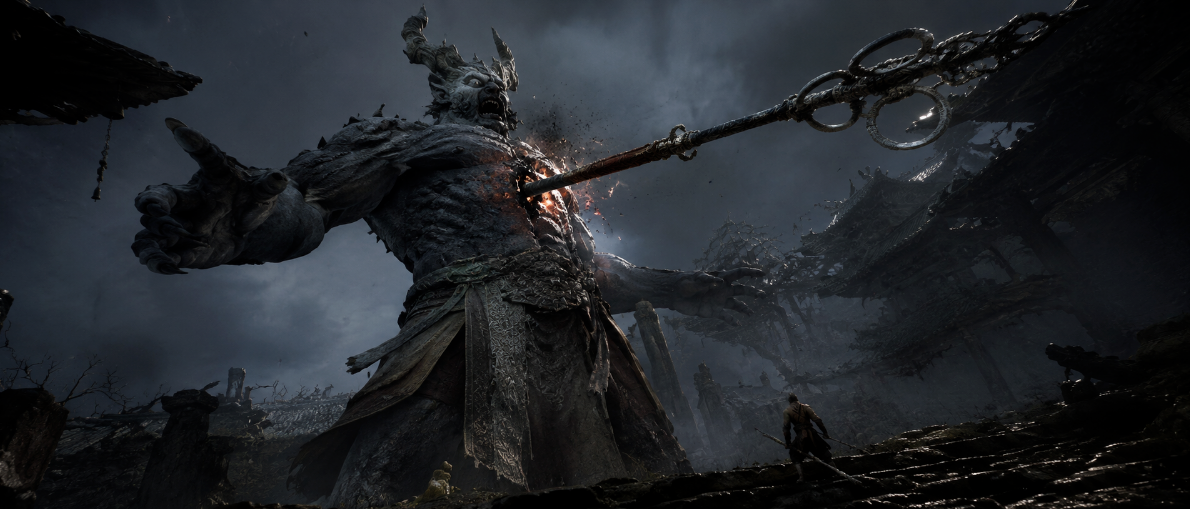
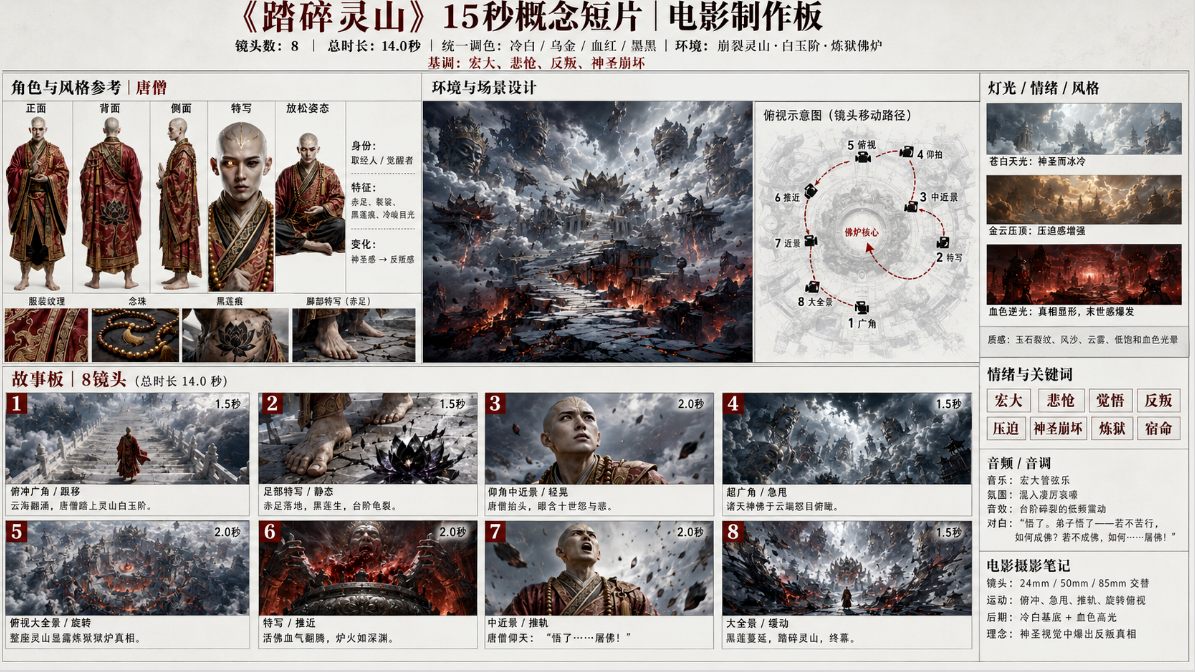
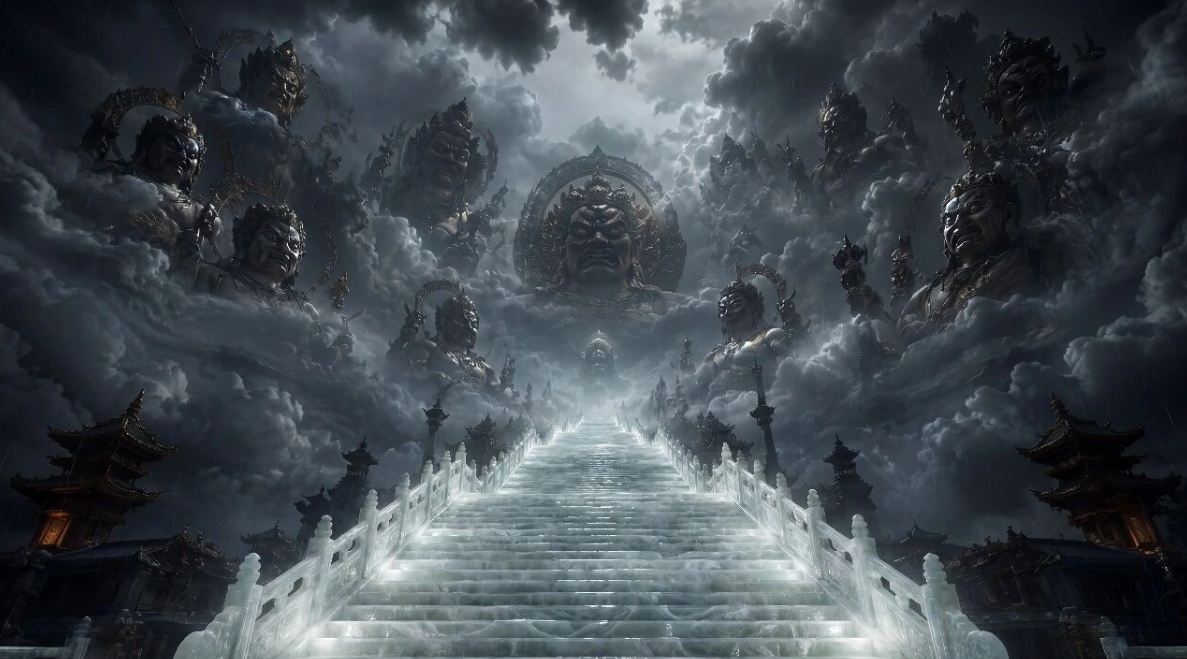
做AI短片卡住大多数人的,不是创意,是执行。分镜画出来风格乱、人脸每隔几帧就崩一次、好不容易做出来的静帧导入视频模型之后跟原图对不上……这些坑,踩过一次就知道有多劝退。这篇文章把GPT Image 2生成电影级分镜板、再用Seedance 2.0落地成片的完整流程,以《灵山炼狱》这套史诗级短片为例,拆解给你,提示词模板直接可以复制套用,新手也能上手。
为什么是GPT Image 2和Seedance 2.0这两个模型
做AI短片,核心绕不开两件事:分镜要有质感、有一致性;视频要还原分镜、运动要流畅。GPT Image 2和Seedance 2.0刚好把这两个需求各负责一半。
GPT Image 2是OpenAI于2026年4月正式发布的最新一代图像生成模型,引入了O系列推理能力,生成前会主动规划构图、校验约束条件。它的语义理解能力、画面叙事感、多画面一致性控制,目前处于顶流水准。你把完整的分镜脚本、角色设定、风格要求喂给它,它能一次出一张结构完整、风格统一、光影连贯的全案分镜板,人物、场景、色调全程不跑偏。《灵山炼狱》这套分镜,从角色三视图、场景概念图到8个镜头的完整分镜,只改了两次提示词就定稿了。
Seedance 2.0是字节跳动于2026年2月发布的最新视频生成模型,参考图还原度极高,支持多模态输入(最多9张图、3段视频、3段音频同时作为参考),对人物、服饰、纹身等细节的复刻能力很强。用GPT Image 2生成的分镜图直接作为参考图导入,配合运镜提示词,出来的效果跟分镜板高度一致,新手也能把控。
开始之前:前期策划做扎实,后面才不返工
很多分镜翻车、视频跑偏,根子在前期没想清楚。打开模型之前,先把这三件事敲定。
第一件:把项目基础参数定死
照着下面这张表填,别含糊:
第二件:把角色和场景的视觉资产先生成出来
角色设定要具体到脸型、发型、服饰、标志性细节。提前用GPT Image 2生成一张角色三视图加特写,作为后续全片的人物锚点,只要后续生成时上传这张图作为参考,人物形象就不会乱跑。场景也一样,生成一张包含整体结构、光影氛围、核心元素的场景概念图,全片场景有了统一参考,就不容易穿帮。
第三件:把剧本写具体
把剧本完整粘贴进去,检查逻辑是否通顺。剧本里的画面描述越具体越好,少用"宏大壮阔""震撼人心"这类形容词,多写"角色从画面右侧缓步走上台阶""熔岩从裂缝中喷涌而出"这样可视化的动作描述,后续直接复制到提示词里用,省去重新翻译的步骤。
实操第一步:GPT Image 2生成电影级分镜全案
基础设置
- 模型选择:GPT Image 2最新版本(gpt-image-2)
- 使用推理模式(thinking mode)效果更佳,尤其是需要生成结构复杂的多格分镜板时
可直接复制的全案分镜板提示词模板
以《灵山炼狱》为例,把下面提示词里的剧本粘贴区替换成你自己的内容,风格参考也可以换成你需要的:
生成后的修正技巧
出现人物不一致时,把第一次生成的角色特写图作为参考图上传,重新生成,GPT Image 2对参考图还原度很高,一次基本能锁住人设。某个分镜帧不满意,单独细化那一帧的描述,单张重新生成替换掉,不用整张分镜板重做。
实操第二步:Seedance 2.0,分镜图直接落地成片
前期准备:合规校验别跳过
真人/写实角色在生成前,必须先过合规校验这一关。在平台素材库找到你的角色参考图,走合规校验流程,通过之后这张图就能作为全片的人物锚点使用,后续生成不会出现因角色违规导致失败的问题。
逐镜头生成参数设置
以8号镜头为例:
- 开启全能参考模式,参考权重设置在0.8至0.85之间
- 这个权重区间既能保证分镜还原度,又不会因为参考图权重过高导致运动卡顿
运镜提示词要具体,比如"缓慢下推镜头,角色从画面中央向右侧移动,火光从左侧框外渗入"这类描述,比"史诗级运镜"有用得多。
说到底,GPT Image 2和Seedance 2.0能做的,是把你从反复调参、反复返工的执行消耗里解放出来。真正让作品出圈的,还是你对故事的判断和对画面的审美。这套流程跑通之后,希望你把节省下来的时间,放在那个最重要的事情上——把故事讲好。
 AI 速览