阿里全新图像生成模型 Qwen-Image-3.0 主打细节真实、内容丰实、知识厚实三大核心能力,本文通过九大真实业务场景完整实测,客观拆解模型优势、使用门槛与现存缺陷,对比海外同类模型,还原真实商用落地表现。
一、三大核心能力亮点,适配多行业生产需求
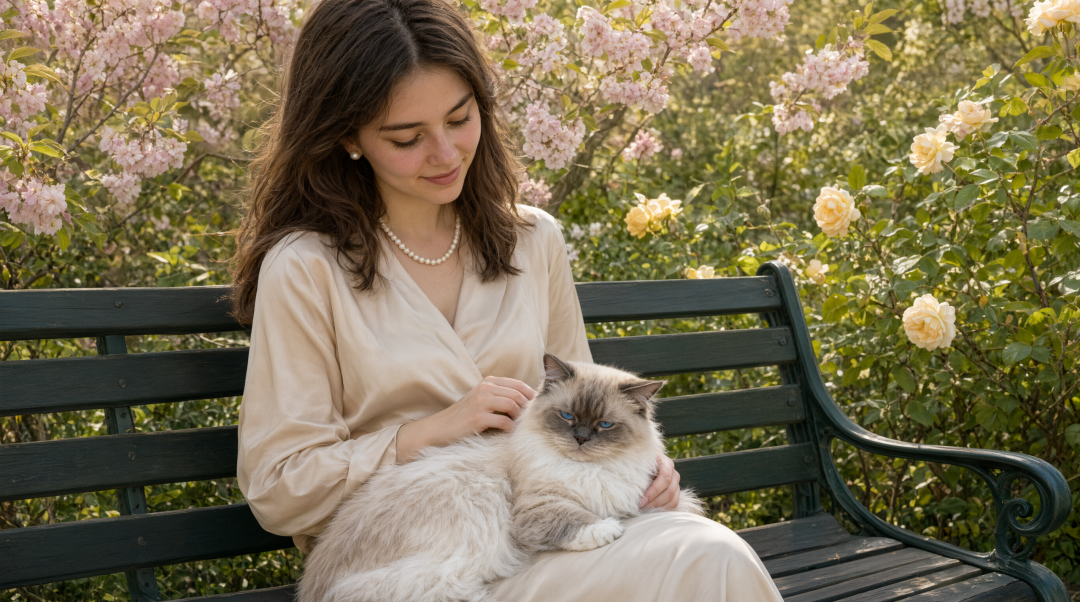
- 细节真实:高精度精细渲染 模型支持 10px 极小文字清晰输出,发丝、皮肤纹理、公式上下标、手写批注等微观细节还原到位。实测学术论文、人像写真场景,文字排版工整,复杂数学公式无糊化,同场景对比 GPT Image 2 细节表现更稳定;手写读书笔记可精准匹配原文段落,仅少量同音错别字,二次指令即可修正。
- 内容丰实:超长输入承载复杂版面 最高支持 4.5k Token 输入,可一次性容纳多类视觉需求,能同步生成九宫格多主题图解、试卷、分镜、网页组合稿,无需分多次绘图,大幅减少反复生成的操作成本,适合设计师、教育从业者批量产出成套视觉素材。
- 知识厚实:多语言 + 多场景原生适配 原生支持 12 国文字生成,适配直播间、网页、科普海报、UI 界面等多元场景;日文、中英混排、跨境电商海报等测试中文字排版自然,基础行业规则认知到位,海外测评显示综合图文表现优于 Nano Banana、GPT Image 2 同类竞品。
二、九大场景实测,暴露关键使用门槛
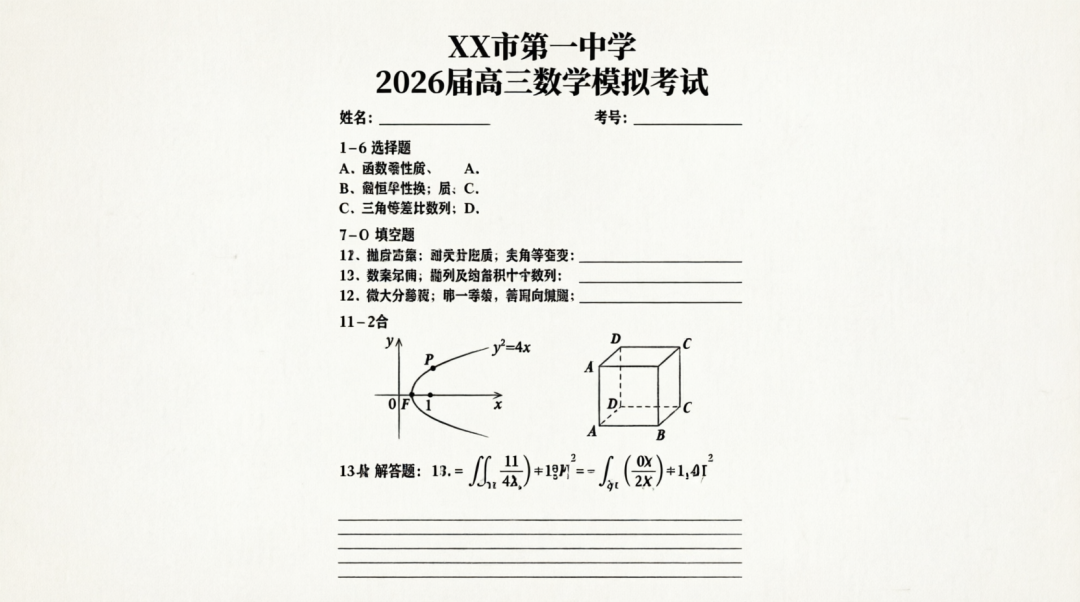
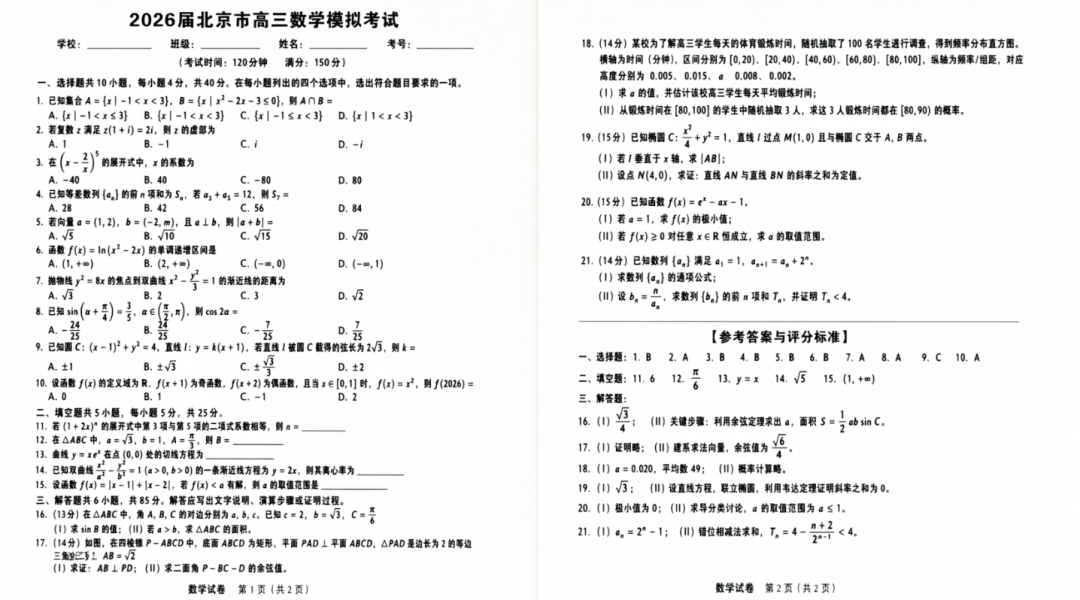
九大实测覆盖论文、人像、笔记、九宫格、高考试卷、设计合集、海外直播间、多语种海报、仿真 UI,其中高考试卷场景暴露最明显适配门槛:直接输入题库无法生成规范试卷,会出现漏题、乱序、拒绝绘图等问题。
官方最优操作流程为:先用千问大模型处理题库,生成专属 Markdown 提示词,再导入 Qwen-Image-3.0 渲染版面;跨模型提示词直接复用极易出现生成失效、内容错乱,不同大模型提示体系不互通是核心使用阻碍。
其余场景整体达标:九宫格图解、多语种旅游海报、人像写真、公众号仿真页面均可正常输出,但存在生成速度偏慢问题,复杂图纸单张耗时可达 3 分钟以上。
三、当前落地三大明显短板
- 生成效率偏低 复杂图文、试卷、高精度人像渲染耗时久,批量生产场景会拉高时间成本,对比海外模型生成速度差距明显。
- 复杂长文本稳定性不足 大量试题、多段落文字场景易出现丢内容、语序错乱、文字拼写错误,多语种生僻术语易混淆,无法做到一次成型,需要多轮迭代修正。
- 场景融合还原度有限 仿真 UI 页面会混杂多款平台风格,难以 1:1 复刻指定产品界面,高度定制化界面仍需要人工二次精修。
四、行业落地客观总结
相比前两代千问图像模型,Qwen-Image-3.0 在文字渲染、长版面承载、多语言能力实现跨越式升级,可满足教育、电商、文创、UI 设计大部分初稿生产需求,大幅降低素材制作门槛。
但现阶段无法实现 “一次出稿直接商用”,长文本、高度定制化场景仍存在稳定性、速度缺陷,且有专属提示词使用限制,对新手不够友好。后续版本若优化生成速度、长文本纠错能力、跨模型兼容性,将进一步提升商用交付能力。
 AI 速览