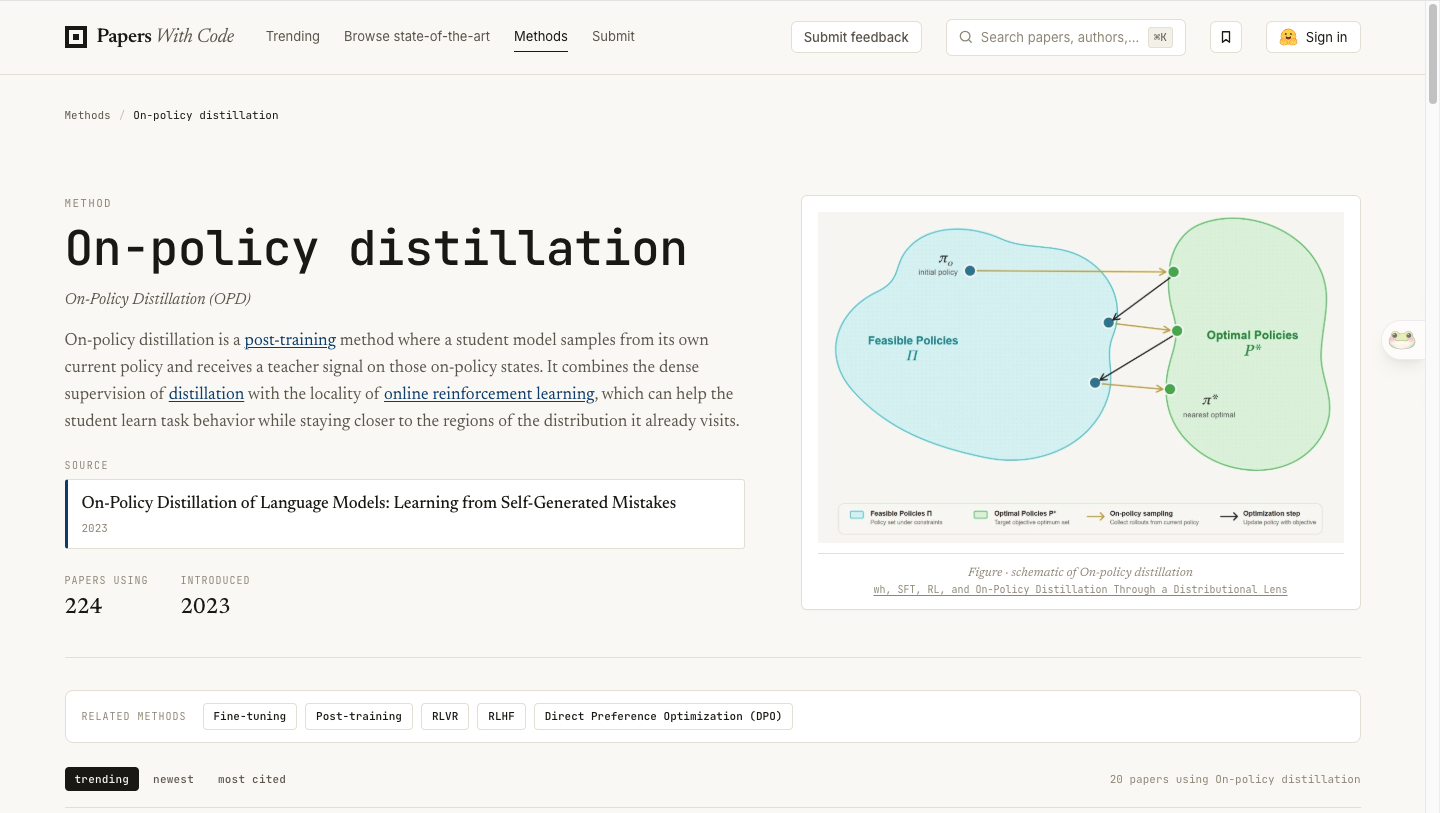
2025 年 10 月 Thinking Machines Lab 发布的《On-Policy Distillation》博客,把一个原本只在论文圈被讨论的技术词推到了 LLM 后训练的主舞台。短短半年内,Qwen3、DeepSeek-V4、Gemma 2、MiMo-V2-Flash、GLM-5 几乎所有主流开源模型都把 On-Policy Distillation(在线策略蒸馏,简称 OPD)写进了技术报告;PapersWithCode 上 183 篇论文引用了该方法;腾讯团队 Mingyang Song 等人在 2026 年 4 月发布的综述论文(arXiv:2604.00626)正式将其定义为"在学生采样轨迹上做 f-散度最小化的后训练范式"。本文围绕"OPD 解决什么问题、性能领先在哪里、产业怎么落地、自己怎么选"四条主线,做一次完整梳理。 OPD 是什么:把"看老师下棋"换成"老师批改你的每一步棋"
理解 OPD 最快的路径是回到 LLM 后训练的三种主流路径:SFT(监督微调)、RL(强化学习)、KD(知识蒸馏)。SFT 与传统离线蒸馏属于 off-policy,数据来自老师而非学生本身;RL 属于 on-policy,但奖励信号稀疏——一整轮 rollout 只拿到一个标量分数。OPD 把两者结合:学生从自己的当前策略采样轨迹,教师对学生生成的每个 token 计算 log-probabilities 并形成 dense 反馈。
Thinking Machines 给出的国际象棋类比已经成为该领域标配解释:off-policy 蒸馏像看大师对局,你看到的棋路精彩,但新手很少会走进那种局面;RL 像无人指导地自己下棋,只在结束时知道输赢;OPD 则是教练对你每一步走法都打"妙手 / 失误 / 漏着"的逐步评级,既在你真实会遇到的局面里训练,又给出密集反馈。
数学上,OPD 通常采用 per-token reverse KL 作为目标:KL(π_student || π_teacher),在每一个 token 上让学生分布逼近教师分布。腾讯综述论文进一步把这一目标统一为更一般的 f-散度框架,reverse KL、forward KL、JSD、skew-KL 都是其中的特殊解。
三种后训练范式核心对比
这三栏差异看似细微,却决定了三种方法在长序列任务上的截然不同表现。Off-policy 蒸馏存在著名的 compounding error 问题:学生早期一个小错误就会让自己漂离训练分布,后续误差按序列长度的平方累积(O(εT²))。在长链推理任务(数学、代码、Agent 长轨迹)中,这个问题极其致命——Gudibande 等人 2023 年的工作就发现纯模仿大型闭源模型的学生,会复刻其风格但不获得真正的推理能力。RL 走的是另一条路,它确实让学生从自己的错误中学,但每个 episode 只获得 O(1) bits 的信息,样本效率天然低。
Benchmark 领先:AIME 74.4%、训练效率 50-100 倍
在数学推理 Benchmark 上,OPD 的领先尤其干净。Qwen3 技术报告(Table 21)给出的同 SFT 初始化对比:
- Off-policy distillation 基础:AIME'24 = 55.0%,GPQA-Diamond = 55.6%
- RL(17,920 GPU 小时):AIME'24 = 67.6%,GPQA-Diamond = 61.3%
- On-policy distillation(1,800 GPU 小时):AIME'24 = 74.4%,GPQA-Diamond = 63.3%
OPD 在 AIME'24 上比 RL 高 6.8 个百分点,在 GPQA-Diamond 上高 2 个百分点,而算力消耗只有 RL 的约 1/10。
Thinking Machines 的复现实验给出了更细的成本拆解。从 Qwen3-8B-Base 出发,SFT 训练 400K 提示拿到 AIME'24 = 60%,要再升 10 个点到 70%,沿着 log-linear 趋势预估需要 2M 提示;而 OPD 从同一 checkpoint 出发,150 步训练(约 77K 提示,4 samples / prompt)就能到 70%。综合 FLOPs 计算,OPD 相比 SFT-2M 有 9-30 倍的 compute efficiency 提升;在自蒸馏对比实验里,OPD 用 7-10 个梯度步追上 RL 用 70 个梯度步达到的性能,等效 50-100 倍训练加速。
Benchmark 落后:小模型容量错配与思考模式不一致
OPD 并非万能。2026 年 4 月的《Rethinking On-Policy Distillation》论文(arXiv:2604.13016)系统梳理了它的失败模式:
第一,U 形容量曲线。教师能力过强反而会拉低蒸馏效率——Li 等人 2025 年记录了"learnability gap",小模型在强推理教师生成的长 CoT 上训练,持续不如更弱教师上的同等训练。Qwen3-4B-Base-GRPO 作为教师虽然在 AIME 上低于 Qwen3-4B Non-thinking,但因为思考模式与学生更接近,反而蒸馏出更强的学生。
第二,思考模式不一致。若教师 CoT 风格与学生当前策略的支撑集距离过远,reverse KL 难以收敛。论文给出的实操建议是先用 mid-training 把学生策略推进到教师 support 范围内,再开 OPD。
第三,长上下文 Agent 场景下的多轮采样开销。OPD 需要教师对每条学生轨迹做 forward pass,Agent 多步采样下计算成本可能反超 RL。
第四,黑盒 API 教师无法提供完整 token-level logit。当教师是 GPT-5、Claude Opus 等闭源模型时,只能拿到采样输出和粗粒度奖励,不能算精确 KL。Lion(Jiang et al., 2023)、Ye et al.(2025)等黑盒 OPD 方案存在,但效果显著弱于白盒。 谁在用 OPD:Qwen3、DeepSeek-V4、GLM-5、MiMo-V2-Flash 已全面落地
OPD 在 2026 年完成了从学术概念到产业基础设施的跨越。
DeepSeek-V4(2026 年 4 月 24 日发布)走得最激进——其技术报告明确表示,后训练流程"用 OPD 替换了原有的混合 RL 阶段",采取两阶段范式:先用 SFT + GRPO 独立训练数学、代码、Agent、指令跟随等领域专家,再通过对 10+ 个 domain specialist 教师的 OPD 进行统一模型合并。综述论文特别提到 V4 采用"全词表 logit 蒸馏",在每个位置上计算 KL(p_θ || p_T) 覆盖全部 |V| token,通过缓存教师 hidden states + 重建 logits 的工程手段,使百万词表、万亿参数教师上的 OPD 可行。
Qwen3 是 OPD 路线的早期受益者,其技术报告里的 AIME 数据成为整个领域的 benchmark 参考线。
Gemma 2(2024)、MiMo-V2-Flash(小米,2026)、GLM-5(智谱,2026)同样将 OPD 写入了后训练 stack。小米在 MiMo-V2-Flash 上首次系统化了 Multi-Teacher On-Policy Distillation(MOPD),通过多教师的 dense token-level 奖励让 MoE 学生兼顾多个垂直能力,不必为单一 benchmark 过拟合。
值得一提的是,2026 年 5 月 NVIDIA 的 PiD(像素扩散解码器)、Flow-OPD 等工作正在把 OPD 思想迁移到 Vision/Flow Matching 模型,跨模态扩展正在成型。
实现路径:基于 Tinker 一行代码改动,GitHub 开源资源齐全
OPD 实现门槛比想象中低。Thinking Machines 把参考实现放在 Tinker cookbook 仓库,核心修改可以简化为:在已有 RL 训练脚本上,把 KL 正则化项里的"参考策略模型"替换为"教师模型",每 token 的 advantage 取 -reverse_KL,然后调用普通的 importance-sampling loss。从代码角度看,这就是几十行 Python 的差别。
社区开源资源已经成体系。GitHub nick7nlp/Awesome-LLM-On-Policy-Distillation 仓库收录了从 Hinton KD(2015)、Seq-KD(2016)、GKD(Agarwal et al. ICLR 2024)、MiniLLM(Gu et al., 2024)、DistiLLM、AKL、SPIN、Speculative KD,到 OPSD、AlignDistil、SCOPE、SDZero、Lightning-OPD 等百余篇论文的完整时间线;thinkwee/AwesomeOPD 则覆盖了 VLMs、Agent、Draft Model 等垂直方向的 OPD 应用。
选型建议:三类典型场景该怎么选
对工程团队,以下三类典型场景的方法选择已经较为清晰:
场景一:小模型上做数学/代码推理蒸馏——首选 OPD。Qwen3 与 Thinking Machines 的数据都已证明,这是 AIME、GPQA 等长 CoT 任务上的成本/性能最优路径。前置条件是有一个比学生强 2-4x 的同家族(或思考模式接近)教师,且能拿到 logit 访问。
场景二:企业内部知识 + 个性化助手——OPD 是当前最适合 continual learning 的工具。Thinking Machines 实验显示,把 Qwen3-8B 在 70% 公司文档 + 30% 对话数据上 mid-train 后,IF-eval 从 85% 降到 79%,再做一轮 OPD(用早期 Qwen3-8B 作为教师,Tulu3 提示)即可恢复到 83%,同时领域 QA 还有 5 个百分点的正迁移。这一"midtrain → distill"的两阶段范式正在成为定制助手训练的标准配方。
场景三:闭源 API 教师 + 强行业合规要求——OPD 不一定是首选。黑盒方案(Lion、Ye et al. 2025)只能用粗粒度奖励,失去了 OPD 最关键的 dense supervision 优势,此时可能 SFT + DPO 反而更稳。
对个人开发者,最低成本的入门路径是:Tinker cookbook 上的 distillation recipe + Qwen3 系列同家族师生对 + 一个 H100 节点,可以在数十小时内完整跑通 OPD-RL-SFT 三路对比。要把 OPD 从"读懂"推到"真正用上",这是目前路径最短的一条。
 AI 速览