说实话,Agent这个词在2026年已经被用烂了。但一个真实的问题却没人好好解决:这些Agent根本不了解你。
每换一个新工具,就像雇了个刚来的实习生,啥背景都不知道。你得反复跟它解释项目在哪、同事叫啥、上次沟通到什么程度……等它终于"上手",可能已经过了好几周。
OpenHuman想解决的,正是这件事。项目发布于2026年5月,登顶GitHub Trending当日热榜第一,项目地址是 github.com/tinyhumansai/openhuman。它的核心卖点只有一句话:Context in minutes, not weeks——几分钟之内,让AI读完你所有的工作上下文。 OpenHuman怎么做到的
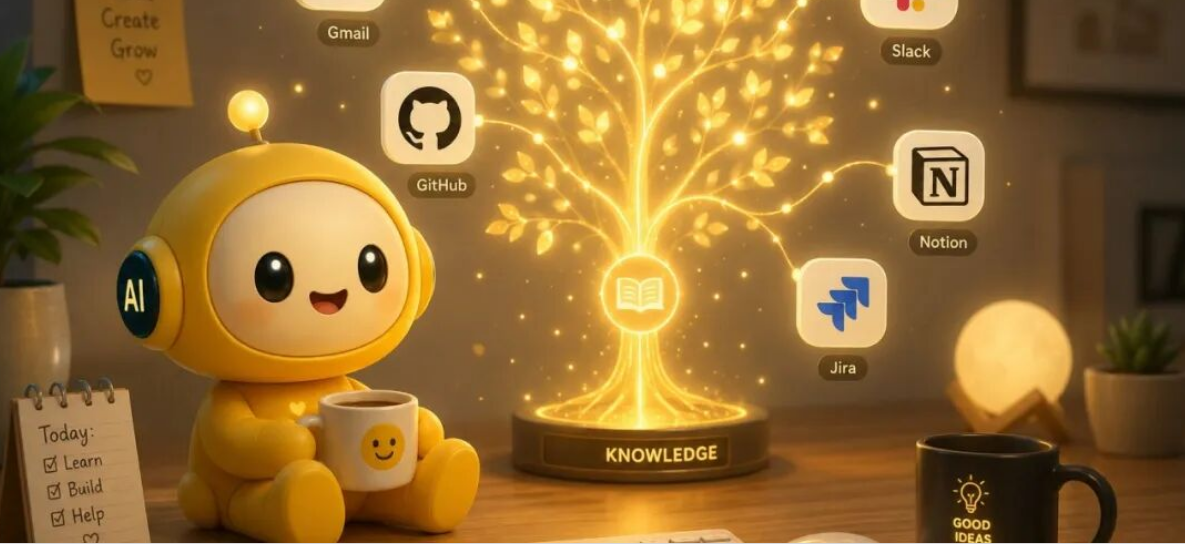
你只需要把常用服务连进来。Gmail、Notion、GitHub、Slack、Google Calendar、Jira、Stripe……目前支持超过100个第三方集成,全部一键OAuth授权,不需要手动配置任何API Key。
连好之后,后台引擎会每20分钟自动轮询所有账户——新邮件、日程变更、代码提交、文档更新,全部拉取、清洗、压缩,存进一棵叫做"记忆树(Memory Tree)"的结构里。这些内容会同步生成.md文件,存进一个兼容Obsidian的本地知识库,数据完全在你自己机器上。 关掉应用、断开网络,数据还在。隐私,是你的。
这个设计思路受前特斯拉AI总监Andrej Karpathy的启发——他曾公开分享过一套工作流,把所有笔记、项目信息整理成结构化Markdown,存进Obsidian让AI持续索引,他称之为"LLM as OS":大模型是操作系统,知识库就是硬盘。OpenHuman直接把这套逻辑做成了可用的产品。
OpenHuman三个有意思的设计
有个功能叫 TokenJuice,每次工具调用的结果在送进大模型之前,会先经过一层压缩:HTML转Markdown、长URL缩短、重复内容去重。官方说能减少最多80%的Token消耗。压缩规则分三层叠加——内置默认规则、用户自定义规则、项目级规则,以JSON格式存储,改起来不需要重新编译代码。
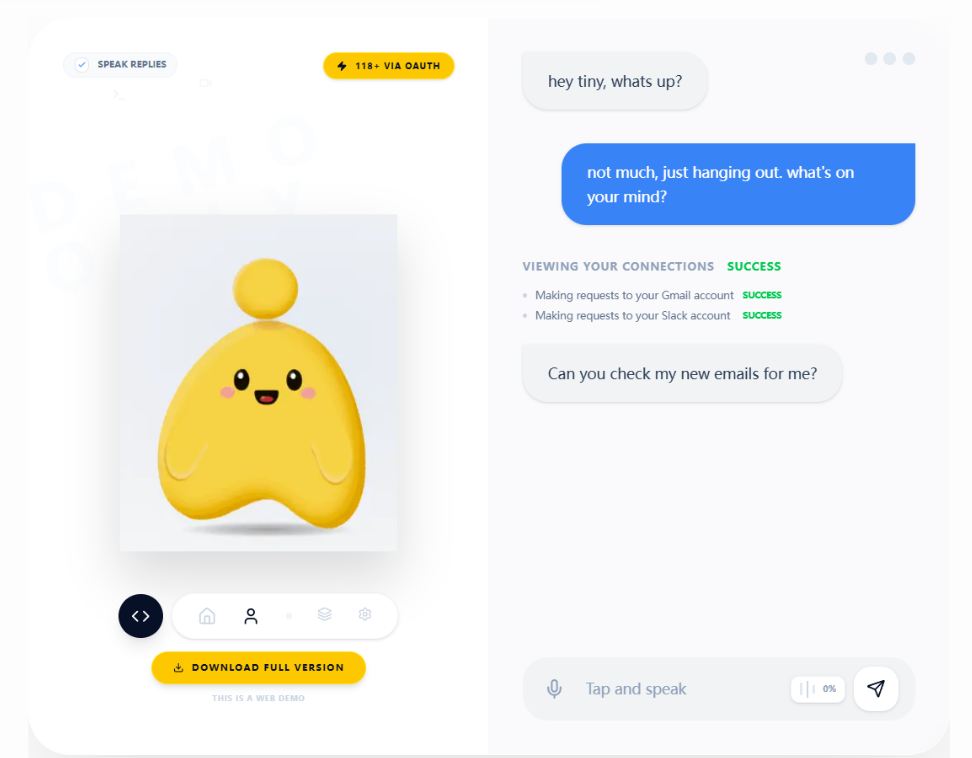
还有个"桌面吉祥物",可以说话,还能作为独立参会者加入Google Meet会议,内置语音识别和ElevenLabs语音合成。你开会它旁听,记要点;你离开后它在后台继续处理待办。更奇的是它有个"潜意识循环":即使你不跟它互动,它也会持续加载任务、读取近期记忆,自主判断哪些可以执行。离开时间够长,它还会进入"做梦"状态,对当天数据做深度整理。
内置的模型路由会根据任务类型自动分配模型——深度推理走重模型,简单问答用轻量级,涉及图片则切换视觉模型。不需要你手动选。
早期项目,短板也明显
GPL-3.0协议对商业使用有限制;技术栈偏重,核心用Rust写的;项目还在早期阶段,社区贡献者不多,稳定性肯定还有待打磨。这些都是真实存在的问题,不能绕开不说。
但方向这件事,感觉是对的。
Agent越来越多,真正的差异化不在于模型有多强,而在于谁能更快、更准、更私密地理解使用它的那个人。大多数Agent工具的上下文是存在云端某个服务器里的,你换个设备、换个平台,上下文就断了。OpenHuman把这件事反过来做——上下文存在你本地,Agent跟着你走,而不是绑在某个平台上。
这不只是功能差异,某种程度上是一种不同的设计哲学:你的AI助手应该属于你,而不是属于某个产品的用户账号。
 AI 速览