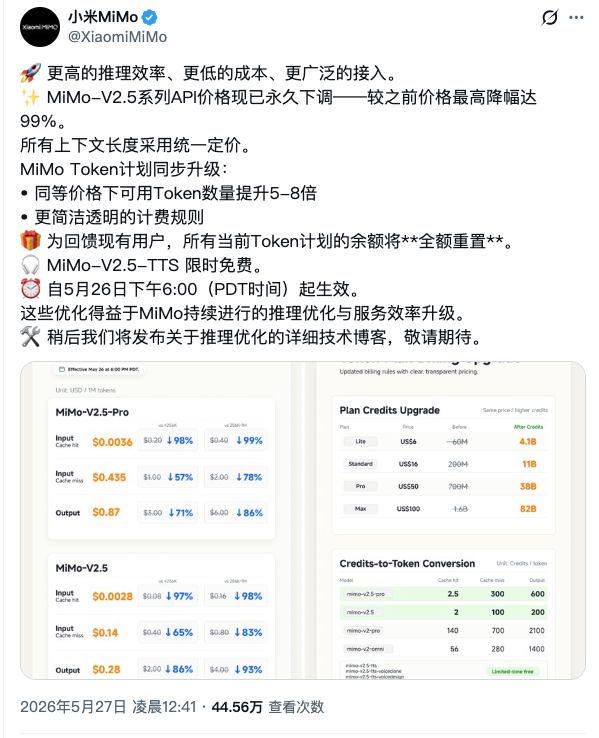
5月27日消息,今天凌晨开始小米 AI 模型开放平台 MiMo 启动 V2.5 系列 API 永久降价,相比原始 API 定价最高降幅 99%,所有上下文长度采用统一计价。同步上线的 MiMo Token Plan 调整后,同等价格下可用 Token 数量提升 5-8 倍,所有当前 Token Plan 的余额全额重置,MiMo-V2.5-TTS 限时免费。官方将这次调整定位为「更高的推理效率、更低的成本、更广泛的接入」三件事的同时落地,是 DeepSeek、Qwen 之后又一次中国大模型 API 价格的整体下探。 三处定价机制变化值得分开看
第一处是上下文窗口的取消计价。 原 API 价格按短/中/长上下文分档计费,超长 context 调用单价显著高于短 context。新规则下所有上下文长度统一计价,对长上下文 Agent、RAG 流水线、超长文档总结一类场景的直接成本影响最大——开发者不再需要为「输入正好跨过 200K 阈值」这种工程细节单独做成本测算。
第二处是 Credits 计费体系。 新机制下用户消耗的不再是 token 数量本身而是 Credits 余额,1M Credits 对应 0.01 元,输入侧再细分缓存命中与未命中两档计价。这套体系与 DeepSeek、Anthropic 此前推行的 prompt caching 计费思路同源——通过差异化定价引导开发者主动设计可缓存的 prompt 结构、提升 prefix cache 命中率,从而降低服务端真实推理压力。
第三处是 Token Plan 套餐结构的同步重构。 新版 Token Plan 分为 Lite/Starter Pack 7.2 亿 credits、Standard 24 亿 credits、Pro 84 亿 credits、Max 192 亿 credits 四档,年费区间 63.36 至 1056 美元,全部叠加离峰调用 20% 折扣与 Cursor、Zed、Claude Code 等热门工具的 Day-0 支持。所有当前在有效期内的 Token Plan 用户账户额度按新规则全量重置。同步收官的还有自 4 月 28 日启动的「100T 开发者令牌赠款计划」——100 万亿 tokens 已于 5 月 26 日下午被全球开发者提前领完,活动圆满结束。针对之前 Token Plan 订阅用户的其他更新与面向 Apache 软件基金会 committers 的专项福利,官方表示将于下周公布。 SGLang HiCache 与 SWA 是技术底座
99% 降幅不是单纯的价格补贴。小米在通告中明确这次调价的核心动力来自 SGLang HiCache 技术对 SWA(Sliding Window Attention,滑动窗口注意力)机制的完整支持,使 KV cache 在长上下文场景下的实际占用大幅压缩,单卡能服务的并发请求数量提升,单 token 边际成本对应下降。
这一技术路径与 DeepSeek 在 V3.2 上用稀疏注意力压低推理成本的逻辑同源——上游模型架构改造换取下游 API 单价空间。差异在于:DeepSeek 的成本优化在模型权重层面就完成了,MiMo 则把成本优化压在推理框架与 KV cache 管理层。SGLang 是开源推理框架,HiCache 是其在分层缓存上的改造模块,SWA 则是允许每个 token 只关注固定窗口内邻居的注意力变种——三者叠加,让长上下文 KV cache 能在保留语义连贯性的前提下被高效复用。
中国大模型 API 价格走势的延续与转向
把这次降价放在过去六个月的中国大模型 API 价格走势里看,趋势更清晰。DeepSeek V4 在 1 月启动大幅降价并引入缓存差异化定价、Qwen 系列在 Q1 多次调低旗舰模型 API 价格、GLM-5 在发布时直接把定价压到行业低位。MiMo 这次 99% 的降幅延续了同一节奏,但比此前几轮更激进的地方在于:直接对存量付费用户的 Credits 余额做全量重置,这意味着同样的钱在新机制下能买到 5-8 倍的有效 token 量,老用户实际体感的边际成本下降幅度比单看价格表更深。
「100T 开发者令牌赠款计划」一个月内被全球开发者抢空的事实也从需求端给出了佐证——4 月 28 日启动到 5 月 26 日发放完毕,相当于平均每天有 3.4 万亿 token 被领走,反映出极低成本下中文开发者群体对长上下文模型调用的真实需求规模。
与之形成对照的是海外头部厂商的相反走向。Anthropic 与 Google 在过去两个月对部分模型 API 实施上调或调整计费维度,OpenAI 的旗舰模型保持高位定价。开发者社区对这种「中国厂商集体下探、海外厂商小幅上调」的剪刀差讨论持续升温——按部分开发者在社区里给出的数据,单个账户的月度 token 可用额度从此前的 7 亿量级跃升到 380 亿量级,超出该用户历史使用总量的 10 倍以上,反映出小米在开发者生态争夺上的积极姿态。
局限与机制设计的另一面
需要把这次降价的技术细节看完整。社区独立分析指出,「最高降幅 99%」主要针对缓存命中输入,无缓存命中调用的实际单价下降幅度有限——账户 Credits 余额数字大幅变大的同时,每次 token 消耗的 Credits 扣除倍率也相应上调。换言之,缓存命中率才是新机制下决定真实成本的关键变量。对能够主动设计 prompt 结构、复用系统消息、合理拆分对话轮次的开发者,这是一次实质性的成本优化;对一次性、随机性、prompt 高度变化的调用模式,实际成本下降可能远低于 99% 的标题数字。
这种「价格杠杆引导技术行为」的设计与 DeepSeek 的缓存差异化定价是同一思路:把降价从粗粒度的全面补贴转向针对特定使用模式的精细化运营。长期来看,这会逐步把开发者社区分化为「会用缓存的」与「不会用缓存的」两类,前者享受深度降价、后者承担相对较高的实际成本。
另一处需要冷静看待的是 MiMo-V2.5 系列在模型能力梯队中的定位。SGLang 框架优化与定价机制创新解决的是推理效率与商业策略问题,模型本身在 SWE-Bench Verified、Terminal Bench、长上下文 Agentic 任务等核心 benchmark 上的对位关系并未随定价变化而改变。对追求绝对性能上限的场景,价格优势不一定能弥补能力差距;对绝大多数轻量到中等复杂度的开发任务,新定价确实把使用门槛压到了行业最低水位。
对中文 AI 开发者而言,这次调价的实际信号是:API 价格战已经从「全面补贴」进入「精细化运营」阶段,缓存命中率、prompt 结构设计、prefix 复用策略将比单纯比对单价更能决定真实账单。下周公布的针对老 Token Plan 用户的补充更新与 Apache 软件基金会 committers 的专项福利,将是观察小米下一步开发者生态策略的关键窗口。
 AI 速览