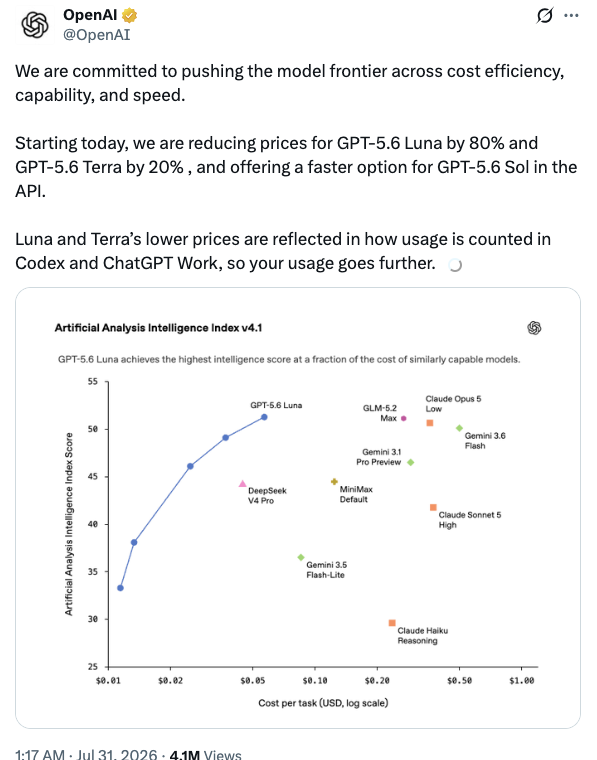
7月31日消息,OpenAI 宣布下调 GPT-5.6 系列两款模型的 API 定价:最轻量的 Luna 降价 80%,中端的 Terra 降价 20%。同日,旗舰模型 Sol 的标准定价不变,但新增 Fast 模式——速度最高提升 2.5 倍,价格为标准的两倍。距 GPT-5.6 系列正式发布仅约三周。
OpenAI 在前一天的工程博文中披露了降价的技术来源之一:GPT-5.6 Sol 在人类监督下自主重写了生产环境的 GPU kernel 代码,将端到端服务成本降低了 20%。这是首次有前沿模型自主优化自身推理基础设施并直接转化为客户定价调整的公开案例。
具体调价与 Fast 模式
降价后的 API 定价(每百万 token):
- Luna: 输入 0.20/输出0.20/输出1.20(降价前 1/1/6,降幅 80%)
- Terra: 输入 2/输出2/输出12(降价前 2.50/2.50/15,降幅 20%)
- Sol 标准: 输入 5/输出5/输出30(不变)
- Sol Fast: 输入 10/输出10/输出60(新增,标准的 2 倍价格,最高 2.5 倍速度,智能水平不变)
Fast 模式取代了此前的 Priority Processing,API 中设置 service_tier: "fast" 即可启用(向后兼容 "priority" )。ChatGPT 和 Codex 的订阅价格不变,但 Luna 和 Terra 消耗的额度相应减少。
Sol 自主优化:降价的技术底座
OpenAI 在7月29日的工程博文中详细披露了 GPT-5.6 的效率优化路径。其中最引人注意的环节是 Sol 通过 Codex 对自身推理基础设施的自主优化。
据 OpenAI 披露,Sol 分析了在线流量,找出可以预计算、省略或并行化的操作,然后使用 Triton 和 Gluon(OpenAI 维护的开源 GPU 编程语言)重写了执行矩阵乘法、注意力计算等核心操作的生产 kernel。OpenAI 使用其开源工具 FpSan(浮点数消毒器)验证了模型生成的 kernel 代码的数学正确性。这些优化将端到端服务成本降低了 20%。
此外,Sol 还自主设计并运行了数百次实验,优化其投机解码的草稿模型——测试不同的模型规模、架构和特征,将 token 生成效率提升了 15% 以上。在训练过程中,Sol 还能自主监控并在硬件故障或训练不稳定时进行干预。
OpenAI 将此描述为一个正反馈循环的开端:模型能力提升带来更高的自主优化能力,进而加速效率提升和成本下降。不过需要指出的是,整个过程是在人类工程师监督下进行的,并非完全无人干预。
价格战脉络中的双向策略
将此次降价放入 AI 模型定价的历史脉络中,能看到 OpenAI 正在执行一个分化的双向策略。
向下打量:Luna 降价后的合计价格为 1.40/百万token(输入+输出),已接近DeepSeekV4Pro永久降价后的1.40/百万token(输入+输出),已接近DeepSeekV4Pro永久降价后的1.305/百万 token 水平。两年前 GPT-4 的同一指标是 $90/百万 token。Luna 的定位是"大规模可验证任务"——分类、提取、摘要、工作流编排——这正是企业 AI 应用中调用量最大的场景。当这些任务的单次调用成本降到可忽略的水平,使用模式从"值不值得调一次 API"变成"默认用 AI 处理"。
向上收溢价:Sol Fast 的合计价格为 70/百万token,是Sol标准的两倍,也是当前所有主要模型配置中最贵的选项之一(AnthropicClaudeFable5/Mythos5合计70/百万token,是Sol标准的两倍,也是当前所有主要模型配置中最贵的选项之一(AnthropicClaudeFable5/Mythos5合计60/百万 token)。OpenAI 将其定位于"对响应时间敏感的企业工作负载"——用价格筛选出愿意为延迟付费的客户。
中间层的挤压最为激烈。Terra 降价后为 2/2/12,与 Google Gemini 3.1 Pro 的定价完全相同。Kimi K3 的 3/3/15 也在这一区间。中端模型的竞争已经从"谁更便宜"转向"相同价格下谁的能力和生态更强"。 CNBC 在报道中指出了降价的商业背景:企业客户在尚未看清 AI 投资回报率的情况下,对部署高价模型犹豫不决。降低低端和中端模型的价格门槛,是 OpenAI 让更多企业先用起来的策略——先扩大 API 调用量,再用 Sol 和 Sol Fast 锁定高价值场景。
 AI 速览