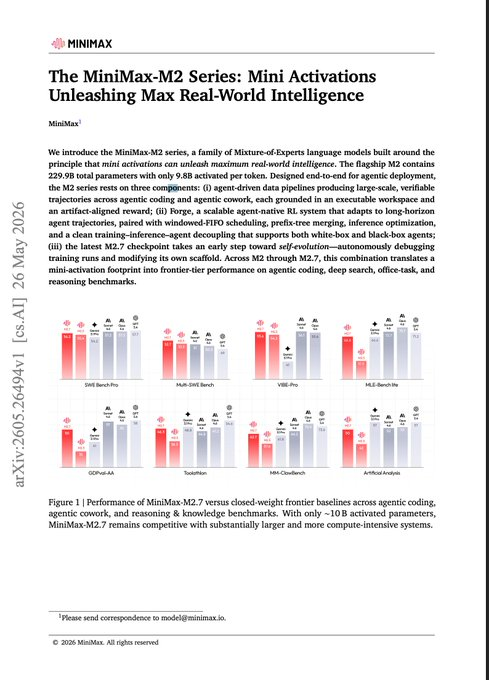
5月26日,MiniMax 在 arXiv 公开了 35 页的 M2 系列技术报告(arXiv:2605.26494),署名作者超过 300 人。这是自 2025 年 12 月 23 日 M2 首次开源以来,MiniMax 首次系统披露 M2 → M2.7 整条产品线背后的训练数据、RL 系统与自进化路径。论文标题"Mini Activations Unleashing Max Real-World Intelligence"也写得很直白:用极小的激活参数撬动真实世界 agentic 任务上的前沿性能。
模型基础参数没有变化:229.9B 总参数、9.8B 激活参数,MoE 架构。这条参数线从 M2 一路贯穿到 M2.7,没有再扩。MiniMax 此前已经把 M3 的方向定在"结构创新 + 预训练",意味着 M2 系列的所有性能增益都来自后训练侧——也就是这篇论文要回答的核心问题。
9.8B 激活的"mini"逻辑
229.9B 总参拆成 9.8B 激活,是 M2 系列最被讨论的设计选择。MiniMax 的论证不是"参数小所以便宜",而是把激活量直接和 agent 工作流的反馈节奏绑定:plan → act → verify 这条循环里,激活越小,单步推理延迟越低,compile-run-test 和 browse-retrieve-cite 这类强交互链路的反馈周期就越快。同样的算力预算,能跑更多并行 rollout,对回归套件和多 seed 探索更友好。
横向对比:Kimi K2 约 1T 参数、Qwen3-Coder-480B-A35B 是 480B/35B 激活、GLM-4.6 仍在更大激活区间——9.8B 是目前开源 agentic 模型里把激活压得最狠的一档,同时还能在 SWE-Bench、Terminal-Bench 类基准上和这些大模型平起平坐。 Agent 驱动的数据管道
论文把数据侧总结成两个场景:agentic coding 和 agentic cowork。两条管道有三个共同特征。
第一,所有训练轨迹都生成在可执行工作空间里,不是纯文本对话数据。代码改完要能编译、能跑测试;office task 改完要能产出符合规格的 artifact。
第二,奖励信号是 artifact-aligned reward。模型不是被"答得像不像"评价的,而是被"产出的东西能不能用"评价的。这把传统 RLHF 的偏好打分换成了基于产物的可验证信号。
第三,规模化。MiniMax 在过去几次发布里反复提到 200,000+ 的真实世界环境,覆盖 10+ 编程语言(Go、C/C++、Rust、TypeScript、Python、Java、Kotlin、Dart、Ruby 等)。论文把这套数据管道单独列为三大支柱之一,规模和工程化程度比单纯的数据集策划要重得多。
Forge:可扩展的 agent-native RL 系统
Forge 是论文里技术含量最高的部分。整套系统围绕"长时程 agent 轨迹"这个核心问题展开,关键设计有四块。
Windowed-FIFO scheduling:异步调度策略,平衡系统吞吐和样本的 off-policy 程度。Agent rollout 时间差异极大,传统同步调度会被最长的那条轨迹卡住,windowed-FIFO 通过滑动窗口控制陈旧度,把吞吐拉起来。
Prefix-tree merging:训练样本以前缀树结构合并。同一个 prompt 下的多条 rollout 共享前缀,显存和计算复用率大幅提升。MiniMax 此前公开过这套技术带来约 40x 的训练加速。
训练-推理-agent 三层解耦:Forge 在训练/推理引擎与 agent scaffold 之间插了一层中间层,agent 可以是 Claude Code、Droid、OpenCode、自研 harness,都能接入同一个训练循环。模型学到的能力不会被某个具体 scaffold 绑死。 white-box / black-box 双支持:黑盒 agent(只能调 API 拿轨迹)和白盒 agent(能直接读写内部状态)都能用 Forge 训练,这一条对企业自研 scaffold 接入意义很大。
算法侧仍然是 MiniMax 在 M1 论文里提出的 CISPO(Clipped Importance Sampling Policy Optimization)。和 PPO/GRPO 不同,CISPO 不裁 token-level 更新,而是裁重要性采样权重,所有 token 都能贡献梯度,对维持 entropy 和大规模 MoE RL 训练稳定性都有帮助。在 Qwen2.5-32B 上的对照实验里,CISPO 相比 DAPO 取得约 2x 的加速。长上下文的 credit assignment 问题则用 process reward 解决——对 rollout 过程做端到端质量监控,而不只看最终结果。
M2.7:朝自进化迈出的第一步
论文最后一块讲 M2.7,被定义为"早期但具体"的自进化样本:MiniMax 让一个内部版本的 M2.7 接手 scaffold 优化任务,跑了 100+ 轮全自主迭代——分析失败轨迹 → 规划改动 → 修改 scaffold 代码 → 跑评测 → 比较结果 → 决定保留还是回滚。最终内部评测集上拿到 30% 的性能提升。
更值得注意的是 M2.7 在 MiniMax 内部已经接管了 30%~50% 的 RL 团队日常工作流——文献调研、实验跟踪、数据管道、debug、merge request 都能闭环。OpenAI 的 MLE Bench Lite(22 个 ML 竞赛)测试里,M2.7 以 66.6% 的奖牌率位列第二,仅次于 Opus 4.6 和 GPT-5.4。
这部分在论文里只是"early step",但和 Anthropic 的 Claude Code skill self-improvement、OpenAI Codex 的方向是同一条线——模型直接参与自己 scaffold 的迭代,是当下 agent 训练里被开源社区关注度最高的方向之一。 Benchmark 逐项拆解
把 M2 → M2.7 的关键分数拉到一起对比:
SWE-Bench Verified(仓库级代码修复)
- M2: 69.4 / M2.5: 80.2 / M2.7: 56.22(SWE-Pro,更难版本)
- 对标:Opus 4.6 ~80、GPT-5.4 85.0、Claude Sonnet 4.5 77.2
Terminal-Bench(CLI 任务)
- M2: 46.3 / M2.7: 57.0(Terminal Bench 2)
- 对标:Claude Sonnet 4.5 在 Terminal-Bench-Hard 33、GPT-5 thinking 31
Multi-SWE-Bench(多语言代码修复)
- M2: 36.2 / M2.5: 51.3 / M2.7: 52.7
- 对标:Claude Sonnet 4.5 44.3、GLM-4.6 30、DeepSeek-V3.2 30.6
BrowseComp(浏览 agent)
- 对标:Opus 4.6 71,与 GPT-5.4 同档
GDPval-AA(专业办公任务)
AA Intelligence Index
数据上有几个明确事实:M2 → M2.5 是一次跨越,SWE-Bench Verified 直接从 69.4 跳到 80.2;M2.5 → M2.7 转向了更难的 SWE-Pro / Terminal Bench 2,分数看起来回落但实际任务复杂度更高;BrowseComp 是 M2.5 真正拉开身位的一项,76.3 比 Opus 4.6 高 5 分。
竞品定位
放回 2026 年中的竞争格局看:
对开源阵营(DeepSeek V4、Qwen3、GLM-5、Kimi K2):M2 系列是激活参数最小、训练速度优势最明显的一档。Forge 是少有的把 agent 训练框架完整开源化、可外接 scaffold 的实现,对中小团队复用价值高。
对闭源阵营(Claude Opus 4.7、GPT-5.4、Gemini 3.1):纯代码生成的天花板仍然在 Opus 4.7(87.6% SWE-Bench Verified)和 GPT-5.4 手里。M2.5 输给它们 5–7 个百分点,但定价是 1/10,吞吐有显著优势。 对场景:高并发 agent rollout、CI 集成、SRE 自动化、多文件 refactor、长链路 web 任务,M2 系列是性价比最高的选项。对 1M 长上下文、复杂 nested function calling、英文之外的世界知识,Claude / Gemini 仍然更稳。
局限
第一,M2.7 的"自进化"目前限定在 scaffold 优化和实验流程层面,不是模型权重的自我训练,离真正的递归自进化还有距离。
第二,9.8B 激活换来的速度优势伴随着 token 消耗偏高——独立测评显示 M2.5 完成同等任务消耗的 token 数接近 Sonnet 的 2 倍,定价优势会被部分稀释。
第三,长上下文窗口(192K)相比 Claude / Gemini / Qwen 的 1M 档仍是短板,对仓库级整体推理是硬约束。
第四,部分第三方平台部署存在 tool calling 偶发问题,官方 API 更稳。
M3 之前的关键信号
这篇论文的发布时点本身就是信号——M3 准备就绪、MSA 论文在路上、M2 系列封盘总结。M2 → M2.7 这条产品线证明了"小激活 + agent-native RL + 自进化"是一条完整可行的路径;接下来 M3 重点放在结构创新和预训练侧,意味着 MiniMax 押注的下一波增益不再来自后训练。开源社区从 CISPO、Forge 到自进化机制的连续采用,也让 M3 的预期被进一步放大。
对 agent 框架开发者而言,Forge 的解耦设计是最值得参考的部分;对应用层团队,M2.5 / M2.7 仍是 2026 年中性价比最高的开源 agent 模型选择。
 AI 速览