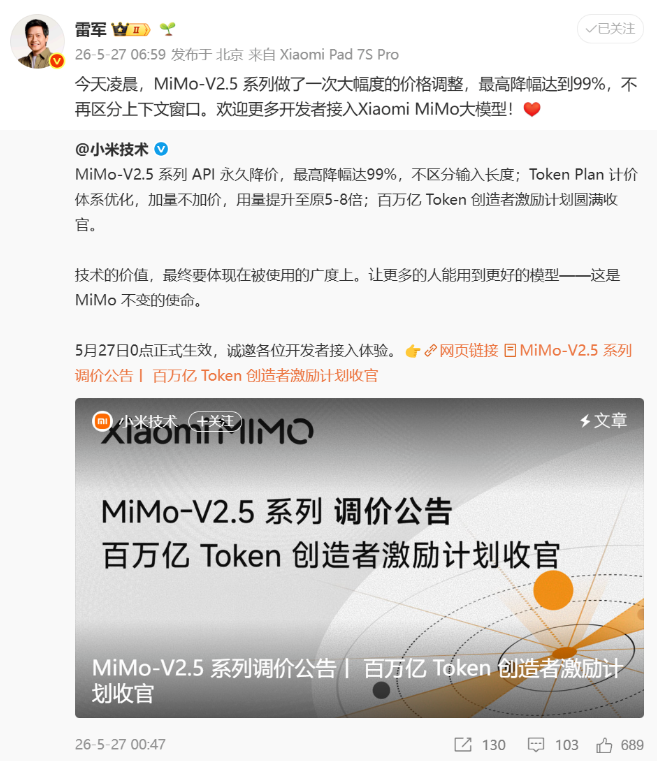
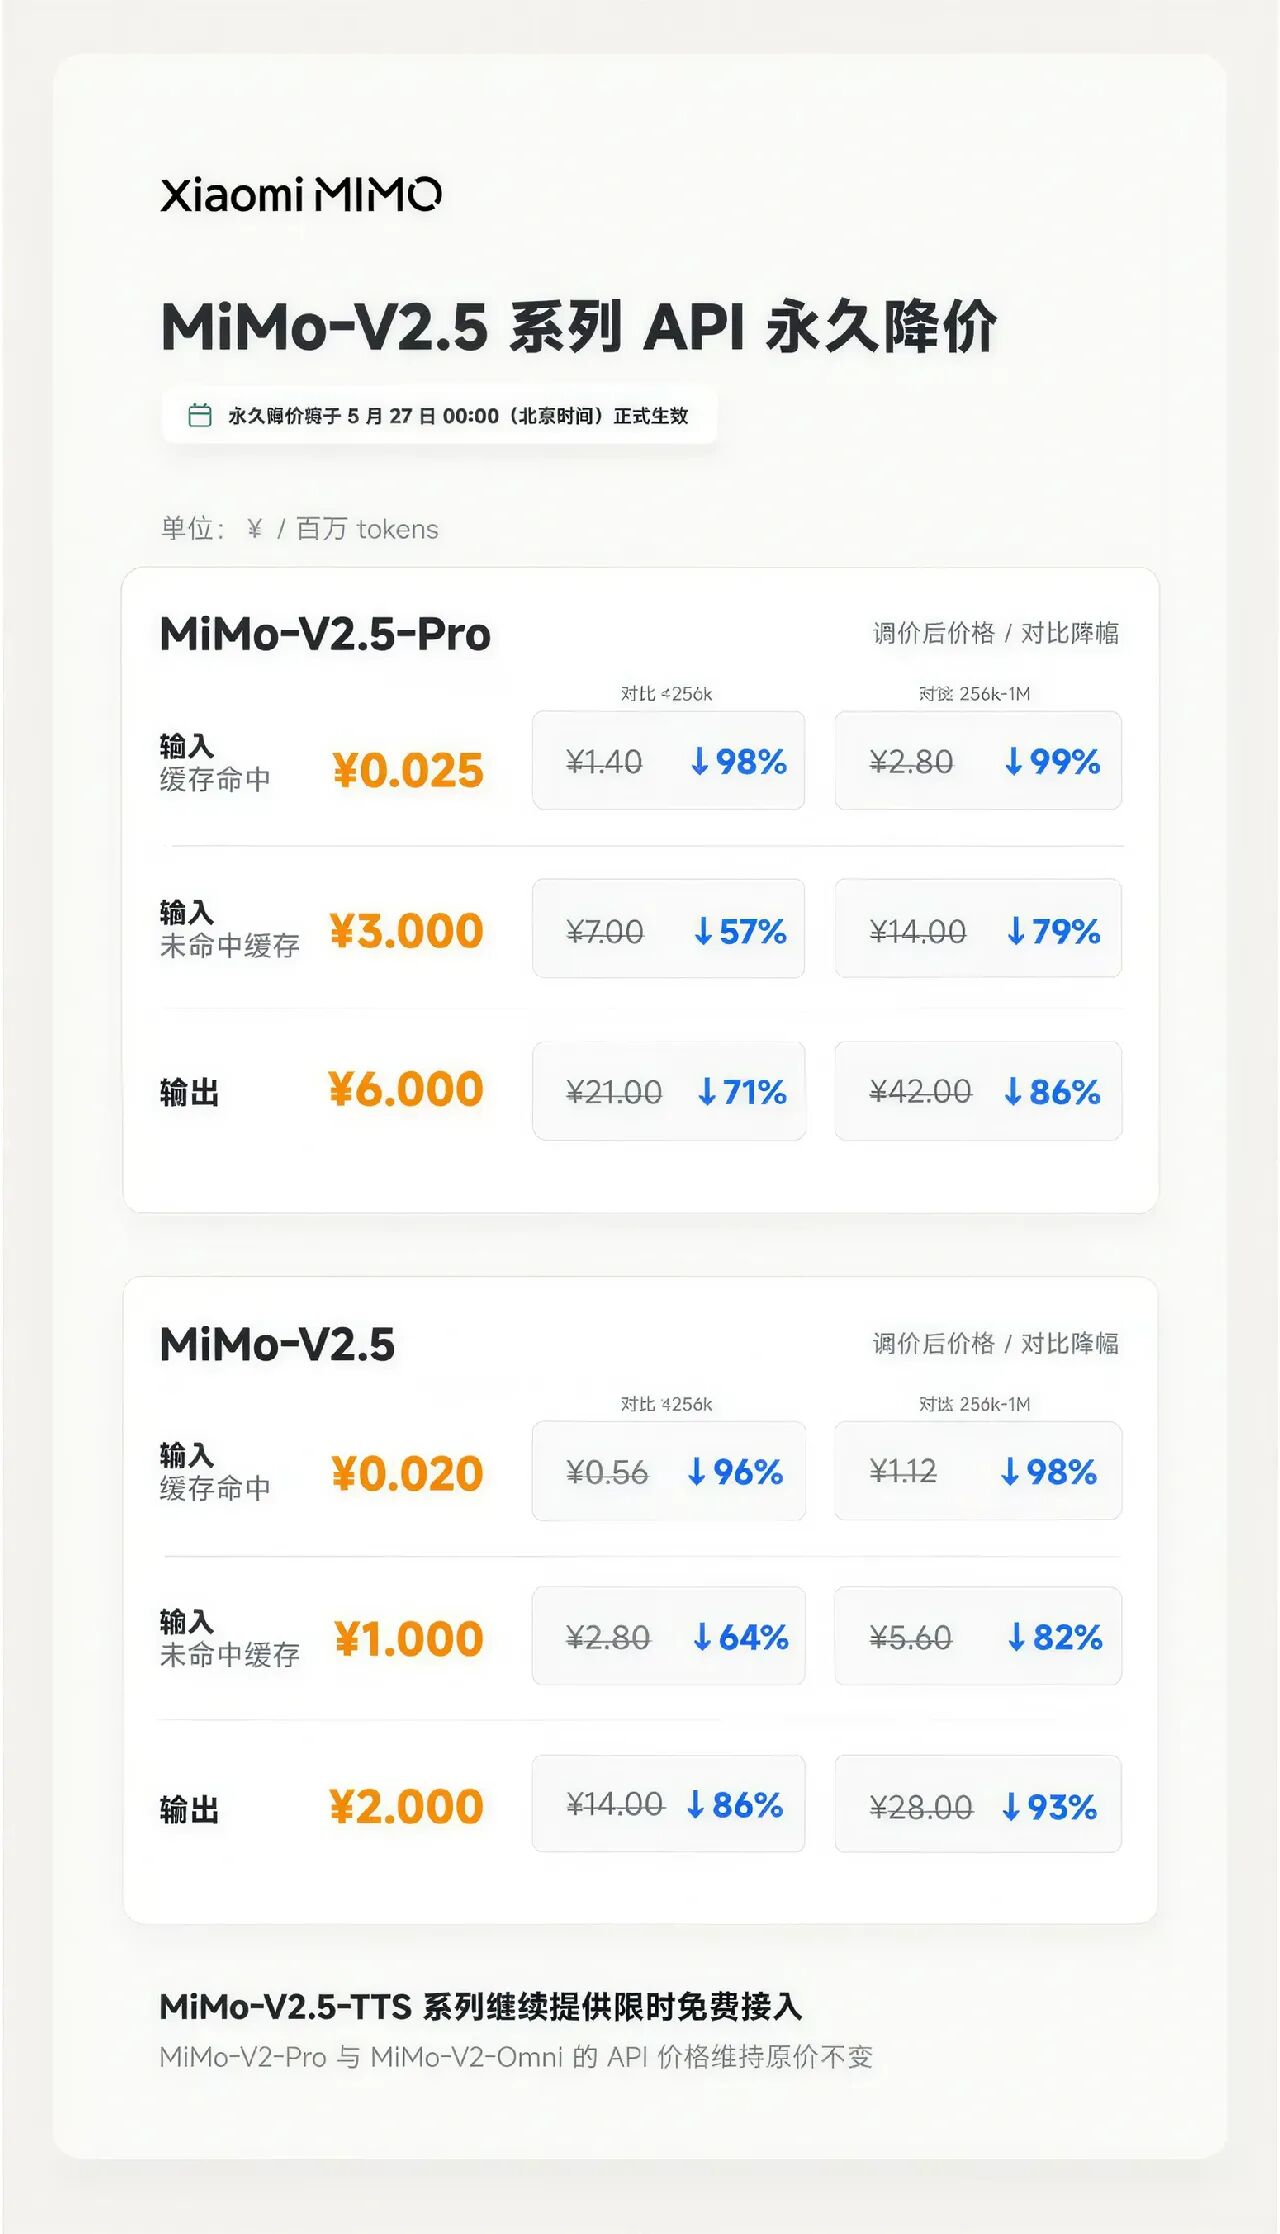
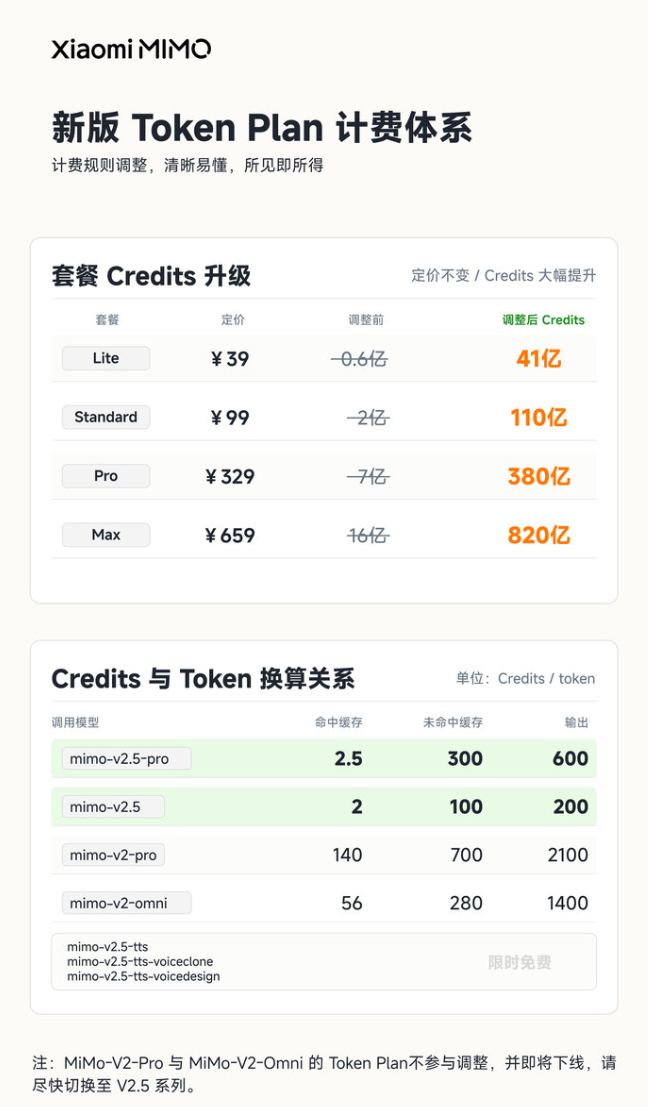
大模型API的价格战,正在被算法创新而非烧钱补贴重新定义。5月27日,小米宣布MiMo-V2.5系列API永久降价,最高降幅达99%,MiMo-V2.5-Pro旗舰型号的缓存命中输入价格降至0.025元/百万tokens,未命中为3元,输出为6元,定价与DeepSeek V4 Pro完全对齐。这不是补贴战,而是算法层面真实的成本压缩——能做到这个价格,DeepSeek和小米各有各的底气。 在这轮降价潮之前,阿里Qwen团队已率先为Qwen3.7-Max开启自动隐式缓存,最高提供80%的输入成本减免。听起来不错,但细节值得注意:显式缓存面临125%的首次创建溢价,缓存存活周期仅有5分钟。创建成本高、留存时间短,背后暗示的是该模型KV缓存占用偏大、单位token计算负载相对更重,真正能让利给开发者的空间因此受限。
相比之下,小米此次调价自北京时间5月27日零时正式生效,全球同步,且取消了原有区分上下文窗口长度的定价方式。对于需要跑长上下文的Agent开发者来说,这个变化本身就已经省掉了一笔隐性成本。
DeepSeek那边,数据更能说明问题。V4 Flash和V4 Pro均于2026年4月24日发布,均支持超过100万tokens的上下文窗口。发布后一个月,V4 Flash以极低的使用门槛迅速登顶OpenRouter月度消耗榜首,V4 Pro也跻身前十。在Cursor、Claude Code这类需要频繁读取代码库的Agent编程场景里,得益于接近99%的前缀缓存命中率,开发者用Pro模型跑8000万tokens只需约4元人民币;Flash模型单日消耗278亿tokens,成本约160美元——这个数字,放在一年前几乎不可想象。 你可能会问,价格压这么低,背后到底是不是在亏本硬撑?答案其实在模型架构里。
DeepSeek V4的关键在于两项注意力机制创新:压缩稀疏注意力(CSA)与强压缩注意力(HCA)。在100万tokens的推理任务中,这两项技术协同将推理算力FLOPs压缩至上一代的27%,KV缓存空间缩减至10%,相较传统GQA模型缩减超百倍。这不是营销数字,是实实在在的算力节省,节省下来的成本才是定价空间的真正来源。
小米MiMo-V2.5系列由前DeepSeek核心成员主导研发,走的是另一套路径。MiMo-V2.5-Pro采用1.02T总参数的MoE架构,但实际推理时只激活约4.1%的参数(约42B)。通过交错堆叠滑动窗口注意力(SWA)与全局注意力(GA),长上下文场景下的KV缓存开销降低了7倍;配合多token预测(MTP)机制,输出吞吐量相应提升3倍。高缓存命中率加高吞吐量,最终落地成你看到的那个价格表。
有开发者社区的讨论指出,这场降价潮与Anthropic、Google等美国公司近期提高API价格的方向形成了明显反差。两边走向截然相反,背后是不同的技术路线与市场策略在各自兑现。一边在探索高溢价模型的能力边界,另一边在用算法效率把成本打到地板。
对你而言,这意味着什么?如果你正在构建依赖高频调用、长上下文读取的Agent应用,现在的成本门槛已经和两年前不在同一个数量级了。低成本普及时代不是一句口号,它正在以每百万tokens几分钱的单价,真实地到来。
 AI 速览