近期阶跃星辰开源的 Step 3.7 Flash 模型凭借超高推理速度、原生多模态能力和 Agent 专项优化出圈。
实测发现,这款模型不仅速度碾压主流大模型,在前端开发、PPT 生成、视觉理解等场景表现亮眼,更适合作为 Agent 工作流辅助模型,兼顾效率、性能与成本。
本文从核心参数实力、多场景实测表现、模型搭配价值、Agent 落地优势四大维度深度解析。
一、核心参数拉满,速度性能双在线
Step 3.7 Flash 采用 MoE 专家混合架构,总参数 196B,激活仅 11B,轻量化设计兼顾性能与推理效率。
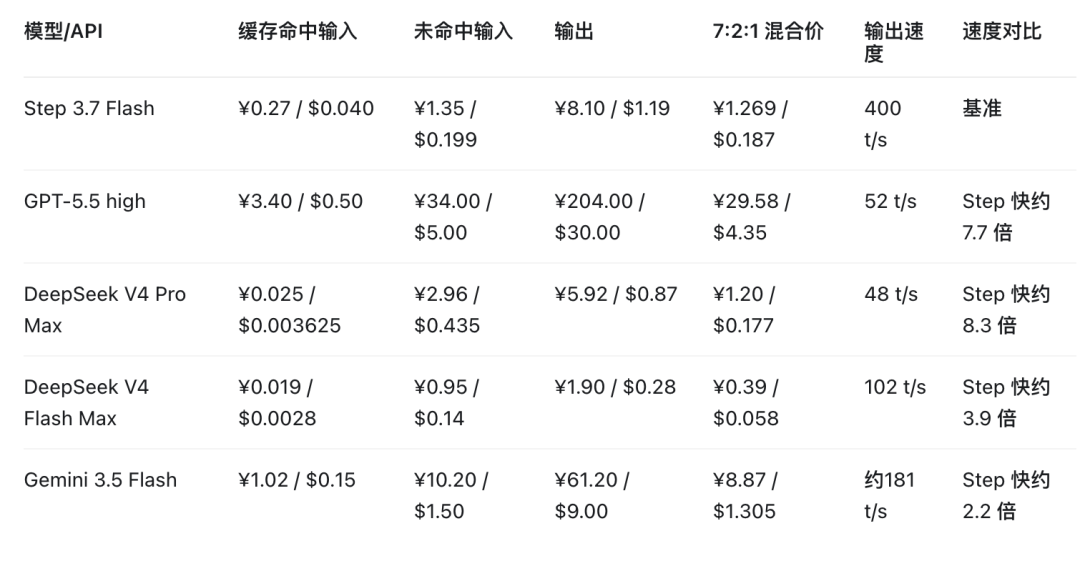
其最大亮点是400token/s 生成速度,远超标准版 GPT5.5 的 42-72token/s,差距高达数倍。模型默认支持 256k 超长上下文,还配备三档推理强度可自由调节。
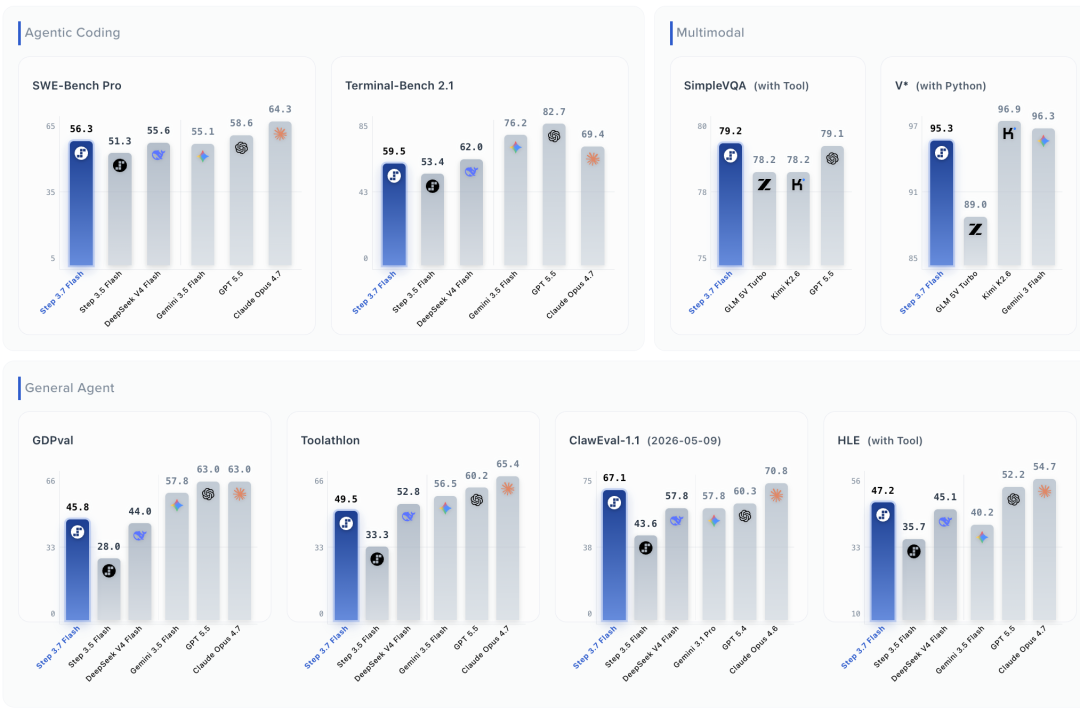
性能层面,该模型相比上一代 3.5 Flash 实现全面升级,在通用 Agent、真实编程、高难知识推理等测评中,超越 DeepSeek V4 Flash、Gemini 3.5 Flash,终端命令行、复杂编码、工具调用能力直追 GPT-5.5 与 Claude Opus 4.7。同时原生支持多模态,可处理截图、图片、网页等多元输入,无需额外适配即可完成视觉理解任务。 二、多场景实测,速度优势彻底凸显
通过 HTML 网页生成、AI 主页设计、Codex 教程 PPT 制作三大实战案例,对比纯 GPT5.5、GPT5.5+Step 3.7 Flash、纯 Step 3.7 Flash 三种模式,差异十分明显。
网页设计场景中,GPT5.5 耗时 4 分钟完成初版,Step 3.7 Flash 仅需 36 秒即可输出完整 HTML,且精准复刻极简黑白、大留白、胶囊按钮等视觉风格。
AI 主页开发时,纯 Step 3.7 Flash152 秒完成全模块生成,设计风格新颖色彩丰富,仅存在少量文本小 bug。
PPT 制作场景下,它快速生成带演讲模式的教程 PPT,重构主题配色与点阵元素,效率远超传统大模型。
综合来看,纯 GPT5.5 稳定性强但速度极慢,还易冗余内容;组合模式兼顾设计感与内容深度,资料检索能力最优;纯 Step 3.7 Flash 以极致速度为核心优势,满足轻量化快速出稿需求。
三、模型灵活搭配,降低使用成本与试错门槛
日常使用 Hermes 等 Agent 工具时,存在大量低风险、高重复、耗 Token 的后台任务,包括会话标题生成、长对话摘要压缩、网页内容抽取、历史聊天检索、任务拆分拆解等十余项功能。这类任务无需旗舰大模型,适配轻量化快速模型即可。
将 Step 3.7 Flash 作为辅助模型接入 Agent,可替代高价 Pro 模型处理基础任务,大幅减少积分消耗与额度超限问题。同时模型切换门槛低,无需改动复杂架构,可自由搭配不同模型分工协作,高端模型负责核心推理,Flash 模型承接轻量化高频任务,既节省成本,又避免单次对话耗时十几分钟的卡顿问题。
四、适配 Agent 生态,成工作流高效副驾
当下 Agent 任务往往需要十几次甚至几十次模型调用,单次速度优势会在多轮工作流中持续放大。
Step 3.7 Flash 针对 Agent 场景深度调优,工具调用、任务判断、操作审批等能力稳定可靠,接入后后台任务进度条全程流畅无卡顿。相较于传统模型切换的适配难题,新模型试错成本极低,无需大量 Token 测试验证兼容性。
其价值不止于替代部分旗舰模型,更在于重构 Agent 工作流逻辑,让复杂任务实现高低模型分层协作。在多轮对话、工具编排、长上下文处理等高频场景中,既能保证任务完成质量,又能实现速度与成本的双重优化,成为国产模型落地 Agent 应用的优质选择。
 AI 速览