最近发布的大模型更新真的是像雨后春笋一般,我这边测试都排起了,好不容易测完了。最近测的是GPT-5.5、DeepSeek V4 Pro、小米 MiMo-V2.5-Pro、MiniMax M2.7 四款顶级大模型的 Agent 实战横测。 这次测试采用完全一致的 Hermes Agent 环境,仅替换模型,围绕 Skill 封装、网页开发、PPT 生成、知识库管理、浏览器自动化五大核心任务展开,综合评估模型稳定性、执行能力、成本与体验,最终得出长期可用、稳定干活的实用结论。 一、测试背景与设计:公平对比,聚焦 Agent 真实场景
本次测试聚焦高强度 Agent 落地场景,排除 Claude Opus 等高成本模型,选取四款性价比与性能均衡的主流模型。测试统一记忆、技能、系统设置与工具权限,仅变更模型底座,确保结果客观。 五大任务覆盖开发、设计、知识管理、自动化等高频场景,同时统计上下文消耗、Token 成本与执行稳定性,还原真实使用体验。
二、五大任务实测:各模型表现差异显著
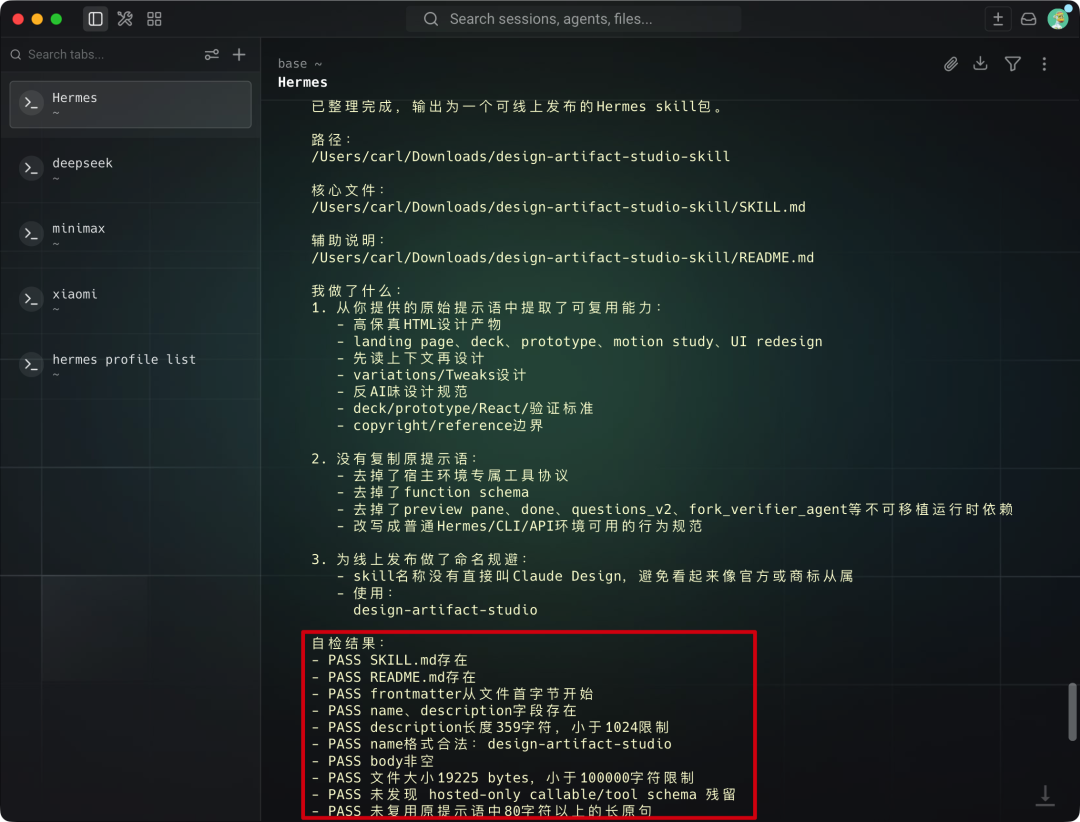
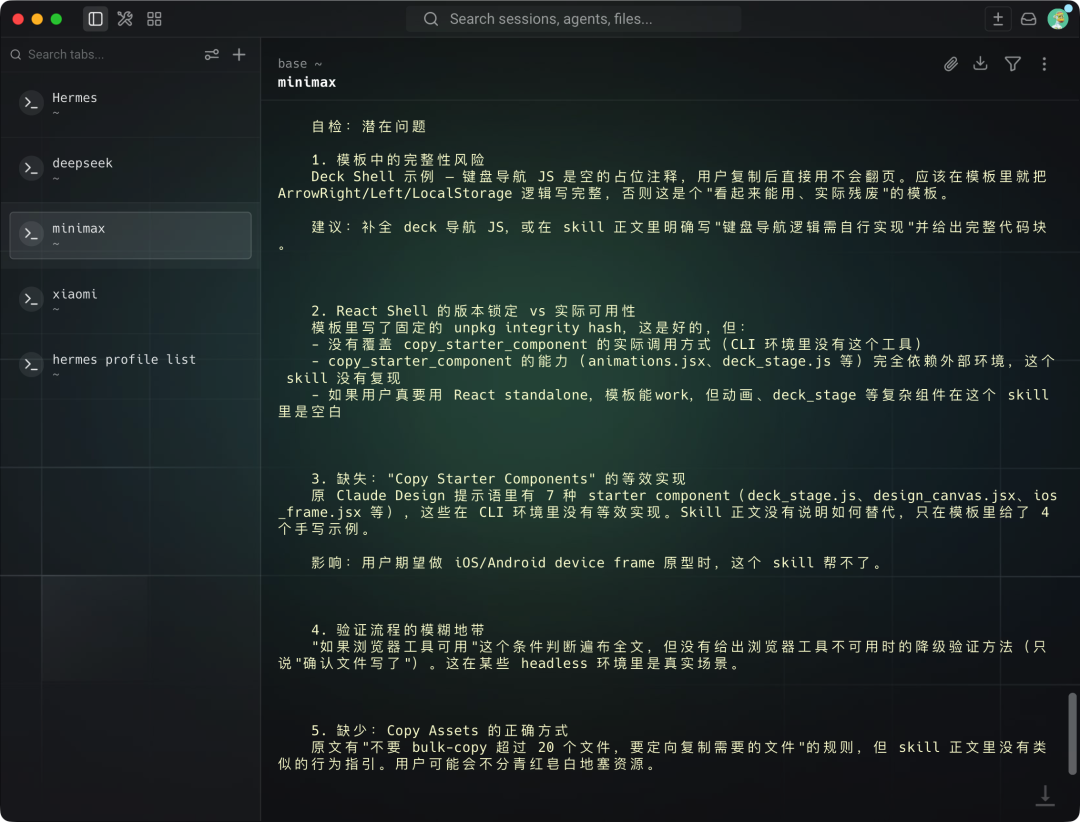
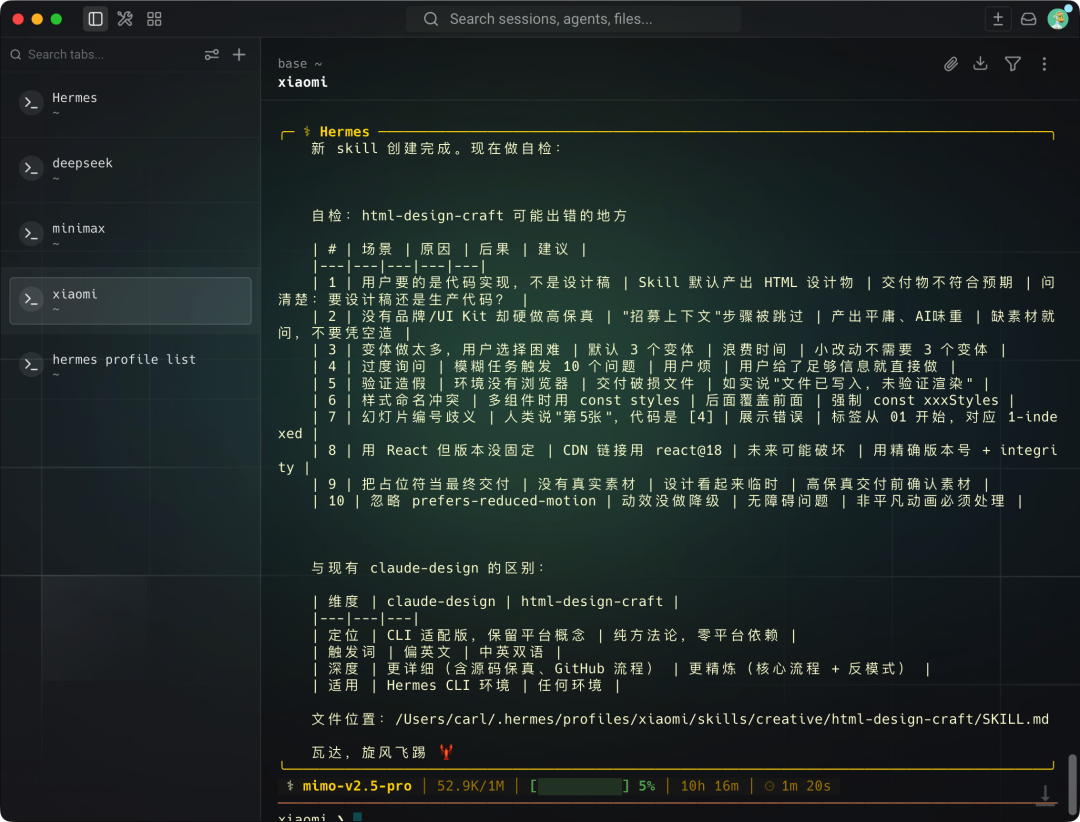
1、Skill 封装:GPT-5.5 输出规范,适合快速发布;MiniMax M2.7 主动发现缺陷并提供修复方案;DeepSeek V4 Pro 检出潜在问题;小米 MiMo 优先校验现有 Skill,再按需新建,逻辑严谨。
2、网页开发:GPT-5.5 交互有亮点但布局错位;MiniMax 页面完整、中英排版舒适、交互贴合程序员身份;DeepSeek 创意突出但知识库信息干扰严重;小米风格务实,命令行交互符合技术场景,缺乏惊艳感。
3、PPT 生成:GPT-5.5 排版合格但输出冗余;MiniMax 聚焦核心流程,结构清晰;DeepSeek 配色合理但排版混乱;小米偶现上下文中断,需手动触发继续,最终输出步骤完整。
4、知识库整理:GPT-5.5 提出试点目录 + 定时迁移;MiniMax 给出量化评估标准;DeepSeek 主张激进重建;小米采用无损桥接方案,保留原有目录,新增 LM wiki 速读层,兼顾兼容与效率。
5、浏览器自动化:GPT-5.5 耗时最长;MiniMax 输出最细致,提供多维度榜单与潜力评估;DeepSeek 仅提示排名波动;小米表现最佳,完成数据对比、脚本编写与本地定时任务配置。
三、成本与消耗:MiniMax 性价比突出,小米额度焦虑明显
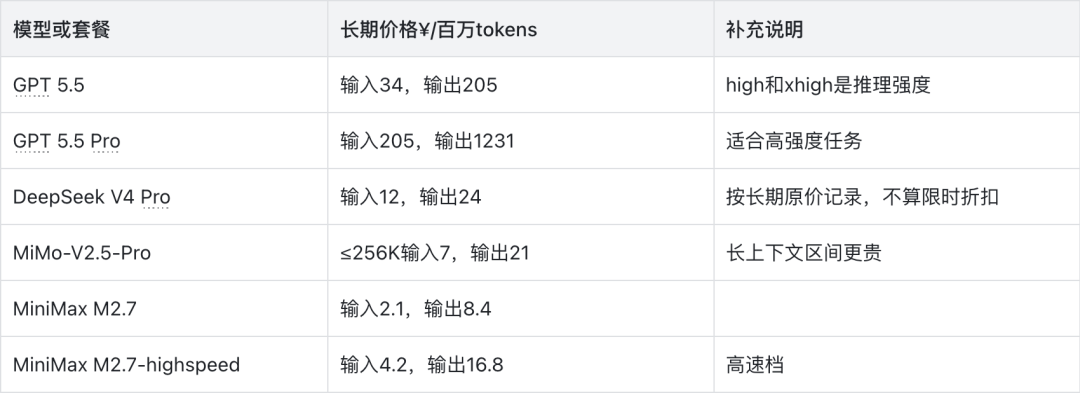
MiniMax 上下文消耗少、API 价格低,Coding Plan 资源充足,长期使用成本可控。
DeepSeek V4 Pro Token 消耗极高,约为同类模型的 8 倍。
小米 MiMo-V2.5-Pro 月额度固定,高强度使用下消耗快,Plus 版不足、Pro 版成本偏高,易产生使用焦虑。
GPT-5.5 性能稳定但价格偏高,适合核心任务。
四、最终结论:稳定干活才是 Agent 主力标准
综合五大任务、稳定性与成本,四款模型各有优势:GPT-5.5 综合能力均衡、输出规范;MiniMax M2.7 细节完善、性价比拉满;DeepSeek V4 Pro 创意强但稳定性与成本待优化;小米 MiMo-V2.5-Pro 知识库与自动化表现亮眼,高频使用成本较高。
测试表明,Agent 时代不再只看榜单排名,稳定执行、低成本、长期可用才是核心标准。GPT-5.5 与 MiniMax M2.7 组合,成为本次测试中最适合长期承担 Agent 任务的选择。
 AI 速览