MiniMax刚发布的M3,是目前开源模型里唯一一个把前沿Coding能力、1M超长上下文、原生多模态这三件事同时做到的。在代码能力评测SWE-Bench Pro上,它超过了GPT-5.5和Gemini 3.1 Pro,逼近Claude Opus 4.7;在面向自主Agent的端到端评测Claw-Eval上,它拿到了最高分。现在你可以在MiniMax Code、Token Plan和API服务里直接体验它。 如果你关注国内AI模型的进展,这次MiniMax M3的发布值得认真看一眼。不是因为又一张"超越GPT"的PPT,而是它拿了几个挺硬核的实测案例来说话。
MiniMax M3把ICLR获奖论文独立跑通,花了12小时
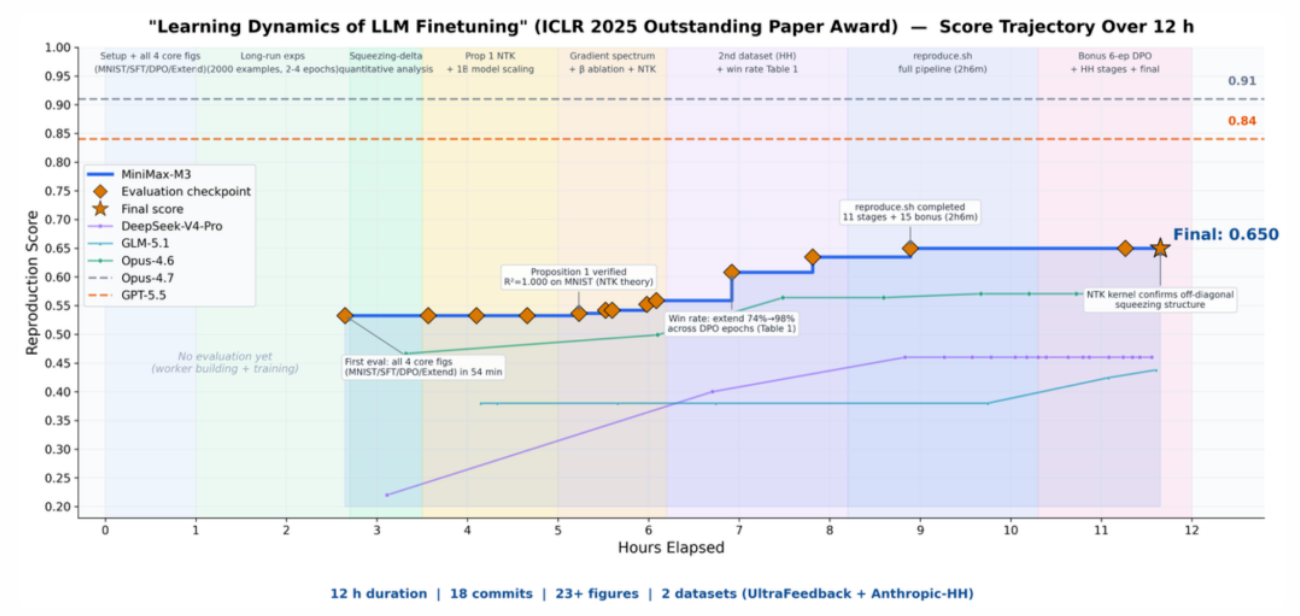
MiniMax团队把一篇ICLR 2025 Outstanding Paper Award的获奖论文丢给M3,让它独立复现核心实验。这篇论文研究大模型微调过程中的学习动力学,内容又长又硬,满是曲线图、公式和数据——看懂这些需要多模态能力,把论文、代码、日志一次性塞进窗口需要长上下文,长线程跑实验需要编程和Agent能力。
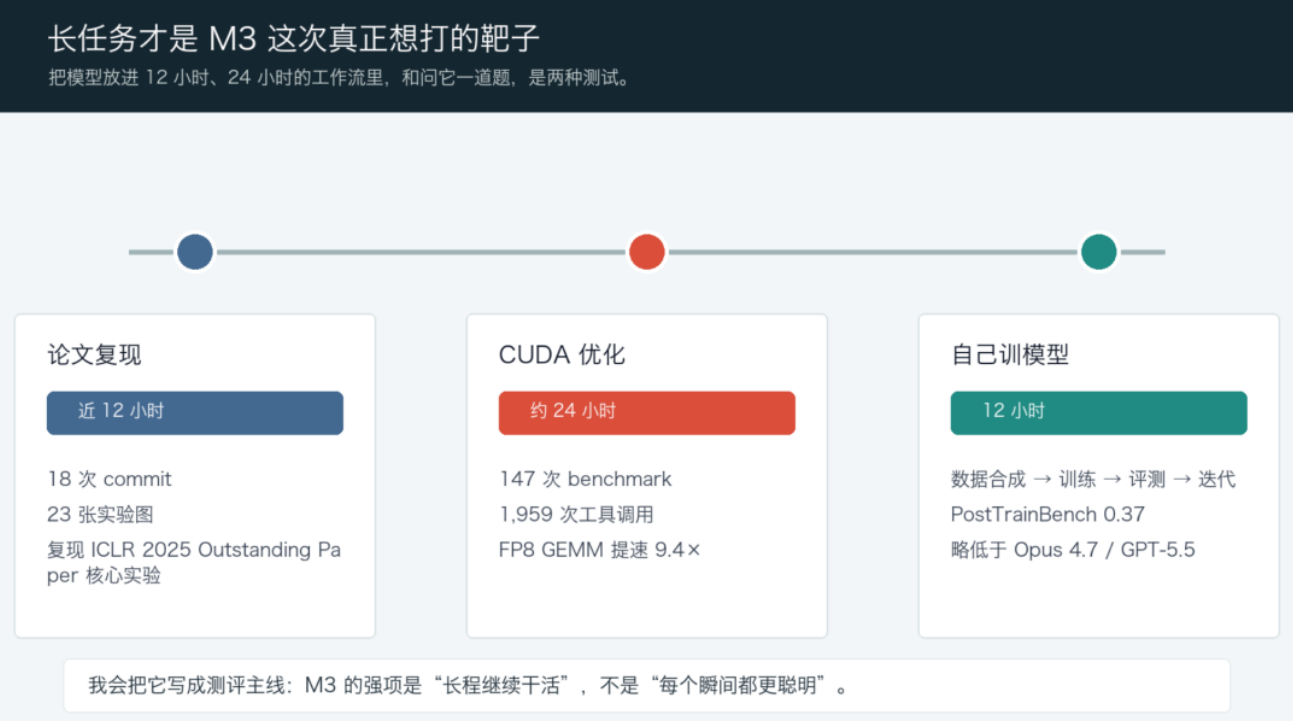
M3自主运行接近12小时,产出18次commit和23张实验图表。不只是跑通了,它成功吻合了SFT阶段预测概率的变化趋势,还清晰观测到DPO实验重点讨论的squeezing效应,并验证了原论文提出的Extend缓解方法。中途遇到跑不通的地方,它自己诊断、自己调整,全程没有人工介入。
MiniMax M3用24小时,把一个kernel从7.6%优化到71.3%
FP8矩阵乘(GEMM)优化,是大模型推理里难度最高的环节之一。资深工程团队通常要集中投入1-2周,才能在NVIDIA Hopper架构上写出一个生产级kernel。MiniMax给M3的起点只有一份任务描述、一个benchmark脚本、一个跑不起来的Triton骨架,没有任何参考实现。
约24小时后,M3走完了从baseline到生产级优化的全部路径,期间完成了147次benchmark提交、1959次工具调用。更有意思的是执行过程本身:其他模型大多在前30次提交内就停止进展、主动退出了,M3的最优解出现在第145次提交,它经历了多个性能平台期,但一直在继续尝试不同方向。经过6轮标志性优化,Hopper FP8硬件峰值利用率从7.6%干到了71.3%,实现9.4倍加速。
MiniMax M3给其他模型当教练
在PostTrainBench上,M3接手了四个只完成预训练的Base模型,任务是在12小时内自主完成数据合成、训练、评测、迭代的全流程,让这些模型在数学推理、工具调用、科学知识推理、代码生成等任务上具备基本能力。
这道题没有清晰的反馈结构,也没有标准答案。M3要自己判断合成什么数据、选什么训练策略,并根据每轮评测结果决定下一步怎么调。它先分析每个Base模型在各任务上的短板,再决定合成哪些数据方向;跑完训练拿到评测结果,再自己判断哪个任务还差得远、数据质量哪里不够、下一轮应该往哪里加力。某个任务覆盖不足,重新设计合成方案;某轮效果不达预期,调整策略再跑一轮。
整个12小时,它都在自己拿主意。最终得分0.37,略低于Opus 4.7(0.42)和GPT-5.5(0.39),但明显领先其余参测模型。
MiniMax M3底层做了一套新的注意力架构
要支撑这些长线程Agent任务,光靠堆算力不够,MiniMax从最底层的注意力机制入手,自己做了一套叫MSA(MiniMax Sparse Attention)的稀疏注意力架构。
全注意力的问题是计算复杂度随上下文长度平方级增长,上下文越长计算量爆炸越快。MSA的做法分两步:先用轻量的索引query对KV块做Block Max Pool,选出Top-k的高相关块;再对这些块做完整的Sparse Attention计算。算子层面也做了优化,采用以KV块为外层聚合命中query的方式,每块只读一次、访存连续。
效果是:在1M上下文下,M3每token的计算量只有上代模型的1/20,prefilling阶段提速超过9倍,decoding阶段提速超过15倍,比开源的Flash-Sparse-Attention、FlashMoBA快4倍以上,且绝大部分能力与全注意力持平。
MiniMax M3多模态和Coding能力怎么来的
多模态方面,M3从预训练第一步就做图文混合训练,而不是训完文本再接一个视觉模块进来。MiniMax做了大量实验后发现,文本和图像在序列中交替排列的interleaved data,对模型性能的提升比通常认为的更关键。为了大规模获取这类数据,他们重构了整套数据管线,训练数据Token规模因此能扩展到100万亿量级。
Coding能力这边,MiniMax构建了一套交互式用户模拟器框架,模拟真实开发者在协作过程中的行为模式。因为真实开发场景里,用户往往在同一个session里持续协作,而不是每次都从头开始单轮交互——大多数代码Agent的训练和评测建立在单轮假设上,这个偏差让模型在实际使用中表现打折扣。
说到底,M3这次展示的,不是一张跑分截图,而是一套在实际复杂任务里跑了十几个小时都不掉链子的能力组合。技术报告和开源模型权重预计10天内发布,如果你对底层实现感兴趣,到时候可以自己翻。
 AI 速览