近期 MiniMax 旗舰大模型 M3 开启商用测试,依托自研 MSA 稀疏注意力架构,兼顾百万超长上下文、顶尖代码能力与原生多模态,打破行业 “长文本弱编码、强代码短上下文” 的不可能三角。
实测通过大模型从零训练、PPT 工程优化两大实战验证性能,搭配全新定价体系,成为全链路 Agent 开发优选,后续模型还将开源开放权重。
一、权威榜单全面突围,多项能力超越海外旗舰
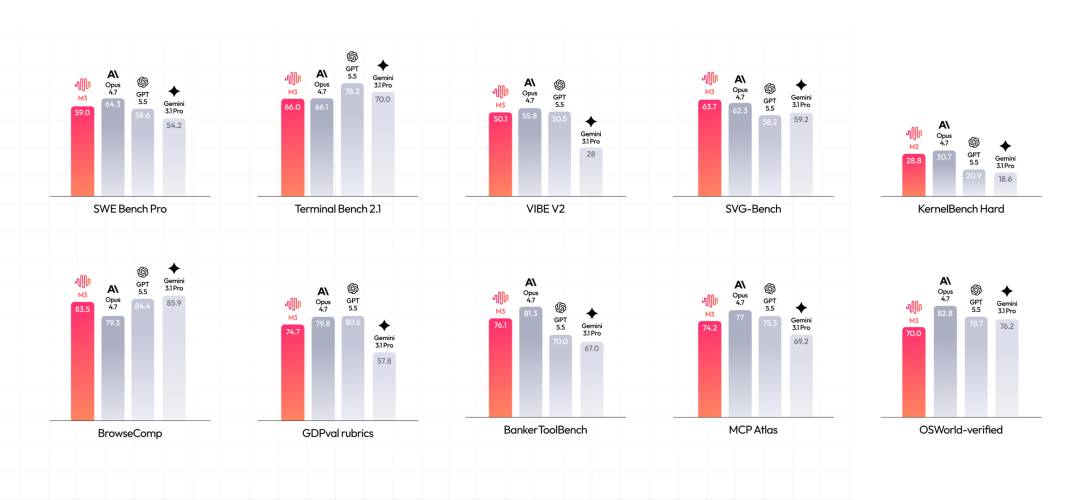
在主流权威评测中,M3 综合实力跻身全球第一梯队:
SWE-Bench Pro 软件工程得分 59.0,优于 GPT-5.5、Gemini 3.1 Pro; OmniDocBench 多模态文档、Claw-Eval 自主智能体评测登顶榜首。
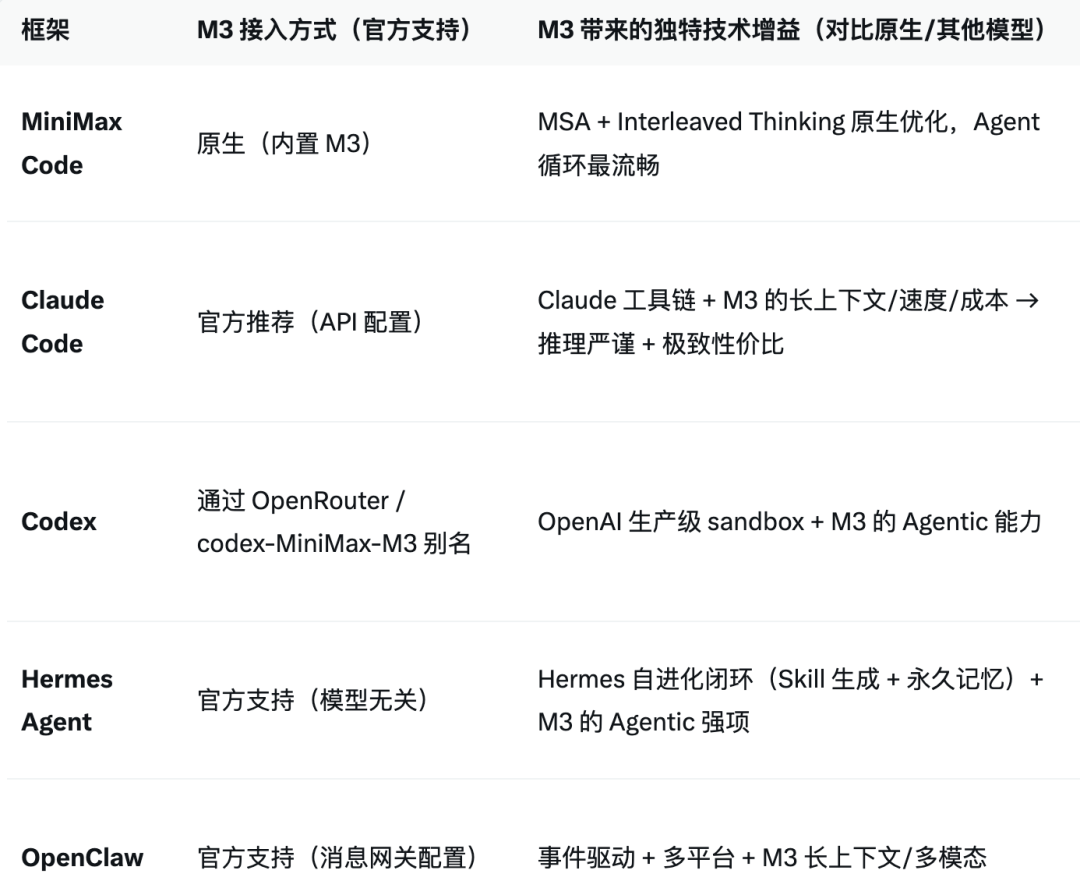
过往主流闭源模型各有短板,GPT-5.5 仅 400K 上下文难以适配 Hermes 长链路 Agent,Claude 对自定义提示词存在调用封禁限制。M3 配套专属开发工具 MiniMax Code,打通文本、语音、视频全品类 API,借助 cc switch 指令可快速切换模型,适配多框架灵活调试需求。
二、MSA 底层架构赋能,百万上下文推理效率暴涨
M3 性能优势源自自研MSA 稀疏注意力,在 100 万 token 超长上下文场景下,单 token 计算量仅为前代模型 1/20,预填充阶段提速 9 倍、解码阶段提速 15 倍。
高效算力支撑多模态统一处理,可同步解析论文文字、公式、曲线图与实验参数,复刻 ICLR 获奖论文时,连续运行 12 小时自主完成 18 次代码提交、23 张实验图表绘制,完整复现整套科研实验流程,解决长链路任务丢失上下文的痛点。
三、两大落地实战,动态多 Agent 工作流效率质变
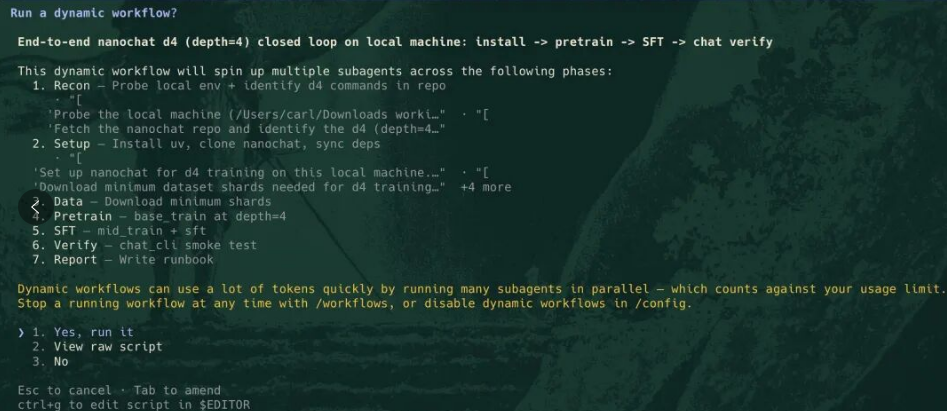
依托 Dynamic Workflows 动态子 Agent 架构,M3 落地两大高难度工程:
- 轻量化大模型全流程训练:输入 workflow 关键词即可启动多 Agent 并行,ultracode 全自动模式进一步简化操作,原本需要数天的 LSTM 训练,M3 仅用 90 分钟从零完成小型 GPT 全链路搭建,千步迭代后模型具备基础问答与数学运算能力;
- Humanize PPT 项目迭代:原项目由 GPT-5.5 开发遗留大量代码缺陷,M3 耗时 2 分 50 秒通读全量代码并输出精准到代码行的优化方案,打通中英文两套 PPT 生成插件,完善大纲梳理、口播稿、预览排版等演讲配套功能。
四、包月定价全面优化,低成本锁定 Agent 主力选型
M3 上线后 Token Plan 由限时配额调整为固定 token 包月,定价性价比突出:Plus 套餐 49 元 / 月(6 亿 token)、Max 套餐 119 元 / 月(18 亿 token)、Ultra 套餐 469 元 / 月(55 亿 token)。
大额 token 配额可支撑海量子 Agent 并行测试,项目收尾阶段 M3 还能自动生成多组测试用例、模拟七种运行场景。综合实测表现后,开发者确定将 M3 作为动态工作流专属主力模型。整体来看,M3 集齐长上下文、强编程、原生多模态三大 Agent 刚需,随着后续开源落地,将大幅降低智能体项目研发门槛,推动本地 Agent 工业化落地提速。
 AI 速览