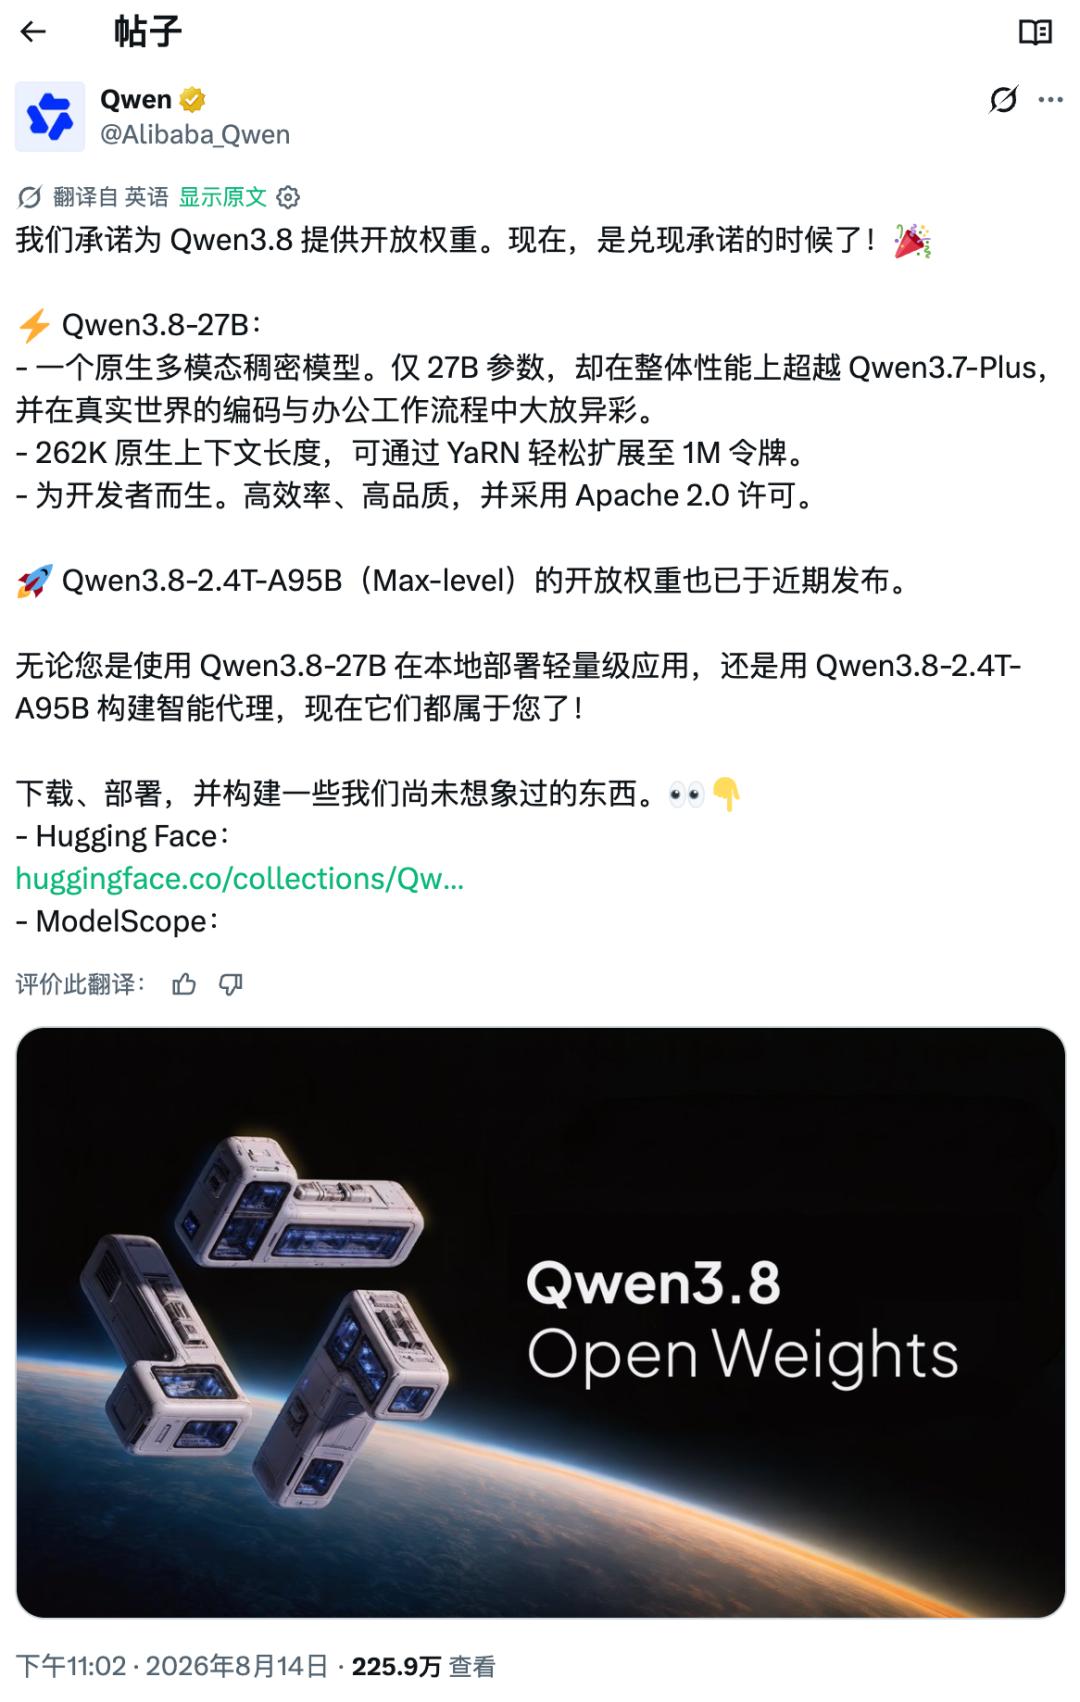
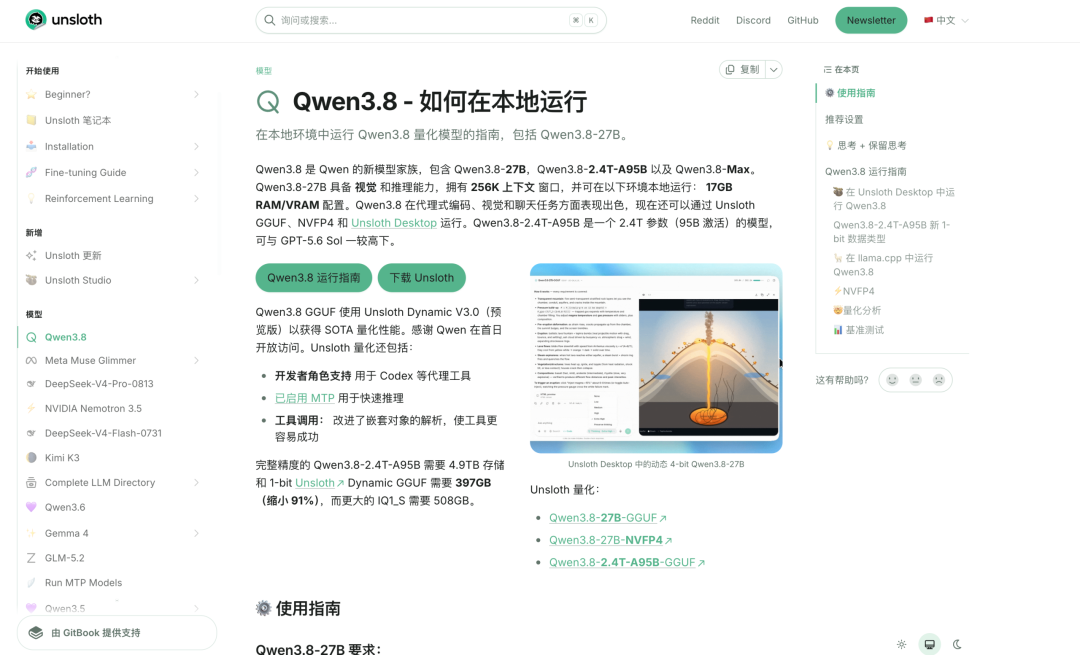
2026 年 8 月阿里通义千问 Qwen3.8 系列正式开源,其中Qwen3.8-27B 稠密多模态模型成为社区爆款。 依托 Unsloth 轻量化量化方案,普通 24G 显卡、Mac 统一内存设备即可本地完整运行,代码、办公智能体、电脑自动化多项基准超越前代 Qwen3.6-27B,部分指标反超 Claude Opus4.6 Max,兼顾低成本私有化部署与旗舰级生产力能力,本文从性能、硬件选型、部署方案、产品定位四大维度完整拆解。 一、核心性能:代码与智能体全面越级,多项指标对标 Opus4.6
Qwen3.8-27B 为原生稠密 Dense 多模态模型,262K 原生上下文,YaRN 技术可外推至 1M Token,核心优化集中在编程、本地 Agent、电脑操控三大场景:
- 代码基准大幅提升:Terminal Bench 从 63.4 升至 73.0,SWE-bench Pro 达 61.7,超越 Qwen3.7-Plus 与 Opus4.6 Max;长代码项目评测 LiveCodeBench 90.3 分,高于海外旗舰;
- 办公智能体能力:CoWorkBench 70.7,可独立完成调研、撰稿、排版全流程长任务;
- 多模态自动化:OSWorld、WebArena 电脑操作测试涨幅显著,能自主识别屏幕、操作浏览器与软件; 短板为纯学术长推理 HLE、重度终端命令执行,仍略低于 Opus4.6。 整体表现证明,本地 27B 设备可替代云端 Opus4.6 完成绝大多数开发、办公、自动化工作,大幅节省云端 Token 费用。
二、量化版本与硬件适配,普通电脑均可落地
Unsloth 推出多档 Dynamic GGUF 量化权重,根据设备内存精准匹配,清晰区分取舍:
- 2-bit(IQ2_XXS,9GB):最低 11GB 内存可启动,推理质量损失大,仅适合临时尝鲜;
- 3-bit(UD-Q3_K_XL,13.4GB):16GB 笔记本 / 显卡首选,兼顾占用与基础能力;
- 4-bit(UD-Q4_K_XL,17.9GB):24G RTX4090/5080、Mac Studio 最优选择,能力保留度高,日常主力版本;
- NVFP4(23.4GB):仅 Blackwell 架构 RTX50 系显卡可用,推理速度提升 50%,代码任务还原度 96%;
- BF16 原始精度 54.7GB:64G 工作站、多卡集群专用。 实操建议:内存优先预留空间给 KV 缓存,初次启动上下文设 32K,稳定后再上调至 128K/262K,避免内存溢出。
三、四大主流本地部署方案,适配不同使用需求
1. 可视化一键工具(新手首选)
Unsloth Desktop/LM Studio:图形界面无需命令行,自动识别显卡内存,一键下载对应量化包,内置思考开关、多模态 mmproj 视觉文件,支持本地 API 输出;Ollama 仅需一行ollama run qwen3.8快速启动,Apple Silicon 支持 MLX 加速。
2. llama.cpp(轻量化单用户)
适合本地工具对接 Codex、OpenCode,支持自定义采样参数,可关闭思考模式降低算力消耗,使用时必须同步下载 mmproj 视觉文件才能解析图片。 3. vLLM/SGLang(多人团队并发)
企业多机共享场景专用,支持连续批处理、MTP 多步推测加速,Blackwell 显卡可加载 NVFP4 权重大幅提升吞吐,原生兼容 OpenAI 接口,对接各类办公、开发 Agent 框架。
4. 高阶提示参数优化
复杂代码 / Agent 任务:temperature=1.0、top_p=0.95、开启 reasoning_effort;日常聊天可关闭思考,调低温度减少冗余推理。
四、Qwen3.8 双模型定位区分,普通用户优选 27B
本次开源包含两款超大参数量模型,适用人群完全割裂:
- Qwen3.8-27B(推荐):稠密多模态,支持图文、视频解析,消费级硬件可跑,覆盖个人开发者、小型企业私有化办公开发;
- Qwen3.8-2.4T MoE:2.4 万亿总参数、激活 95B,纯文本无视觉能力,最小量化包仍近 400GB,需数百 GB 内存服务器,仅面向科研机构、大型 AI 厂商做模型训练研究,个人用户无部署价值。 依托 Apache2.0 开源协议,两款模型均可免费商用,Hugging Face、魔搭社区同步开放完整权重,国产本地大模型生态门槛大幅降低。
整体来看,Qwen3.8-27B 补齐中端高性能本地模型空白,不用持续付费调用云端 API,16GB 起普通设备就能运行接近海外旗舰的 AI 能力,是程序员、政企私有化办公、自动化爱好者的最优本地选型。
 AI 速览