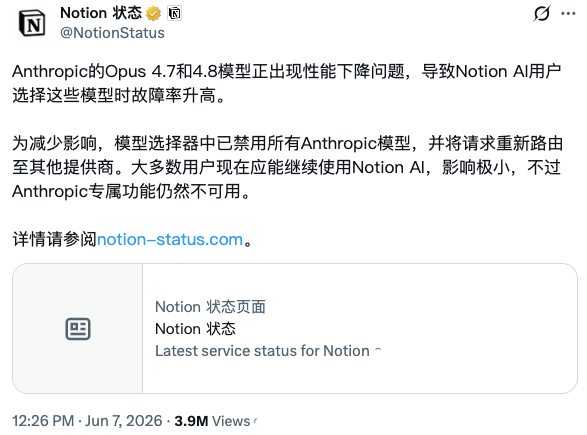
6月8日消息,Notion 官方状态账号发文确认 Anthropic 的 Opus 4.7 和 4.8 模型出现性能下降,导致 Notion AI 中选择这些模型的用户失败率大幅升高,随即宣布在模型选择器中禁用全部 Anthropic 模型,将请求切换至其他供应商。约 12 小时后服务恢复。 12 小时发生了什么
周日早间,Notion 在 X 上发布状态公告,明确指出 Opus 4.7 和 4.8 性能下降是问题根源,并采取了最激进的缓解措施——不是只下线出问题的两个模型,而是禁用全部 Anthropic 模型,请求全部转发到替代供应商。从 Notion 的角度看,这是一个保护用户体验的合理决策:无法确定故障范围是否会扩散到其他 Claude 模型,全部切走是最安全的选项。 这条公告的传播量远超预期。Notion 官方帖子浏览量达 390 万次,被转发约 1200 次。大量用户和开发者将此解读为"Anthropic 模型质量下滑"的信号,引发社交媒体上对 Claude 模型可靠性的广泛讨论。
12 小时后,Notion 产品负责人 Max Schoening 发文确认服务已恢复,同时对外界的解读表示惊讶,强调这是"临时性服务中断"而非模型质量问题,"这种事情常发生,GitHub、AWS 都会遇到。" Anthropic 发言人也发表声明:"一个短暂的基础设施问题导致多个 Claude 模型的错误率短时间内升高,该问题已解决。"
不是孤立事件:近三周至少 7 次故障
单独看这次事件,12 小时中断、快速恢复、根因是基础设施而非模型本身——并不算灾难性。但放在更大的时间线上,问题的性质就不同了。
仅过去三周内,Anthropic 的状态页记录了密集的故障序列:5 月 20 日、22 日、25 日、27 日、28 日 Opus 4.7 分别出现错误率升高;5 月 21 日 Claude.ai 全站报错;6 月 1 日 Sonnet 4.5 和 Opus 4.7 再次中断;6 月 2 日发生大规模宕机,影响 claude.ai、Claude Code 和 API,持续数小时,Downdetector 在英国峰值达 216 条报告;6 月 3 日 Claude Code 部分服务降级超 3 小时;6 月 5 日又一次故障,期间有用户在社交媒体反映收到了疑似其他用户的回复内容,Anthropic 表示正在调查但称"未发现其他数据泄露报告"。 这已经不是"偶发性基础设施抖动"能解释的频率。TechRadar 在 6 月 2 日宕机时评论:"Claude 宕机了。这很好地提醒我们,那些承诺的 10 倍生产力提升仍然有一个单点故障:别人的状态页。"
企业客户的核心焦虑:供应商依赖与切换能力
这次事件真正值得关注的不是宕机本身,而是 Notion 的应对方式。Notion 没有宕机——它切换了模型。这一点暴露了当下企业 AI 集成的关键架构问题:深度绑定单一模型供应商的风险,以及多模型路由层的战略价值。
Notion 能在发现问题后快速将请求路由到替代供应商,说明它的后端架构已经为多模型切换做了准备。对于那些在基础设施层锁死单一供应商的企业来说,同样的中断可能意味着全业务停摆。Anthropic 将自己定位为比 OpenAI"更安全"的替代方案,但企业级可靠性要求的不只是模型能力,还有基础设施的稳定性和 SLA 保障。
竞品方面,OpenAI 的 GPT 系列和 Google 的 Gemini 也并非零故障,但 Anthropic 近期的故障密度在三家中明显偏高。对于正在选型或续约的企业客户来说,这会成为一个实际的评估因素。 更大的背景:IPO 前夕的可靠性考验
这些故障发生在一个敏感时间点。Anthropic 6 月 1 日刚向 SEC 秘密提交 S-1,估值约 9650 亿美元,正准备进入公开市场。Claude Code 和 Claude Cowork 是 Anthropic 向企业市场扩张的两个核心产品,都是高度依赖基础设施稳定性的工具。同时 Anthropic 正在推进模型迭代,Sonnet 4.0 和 Opus 4.0 将在 6 月 15 日正式弃用,要求所有 API 用户迁移到新版本。密集的模型更替叠加频繁的基础设施故障,对企业客户的信心是双重考验。
Notion 产品负责人说"这种事情常发生",技术层面没有错。但当 AI 功能从"附加特性"变成"核心工作流",用户对中断的容忍度会急剧下降——这正是所有以模型能力为卖点的 AI 公司接下来必须解决的基础设施挑战。
 AI 速览