AI 速览
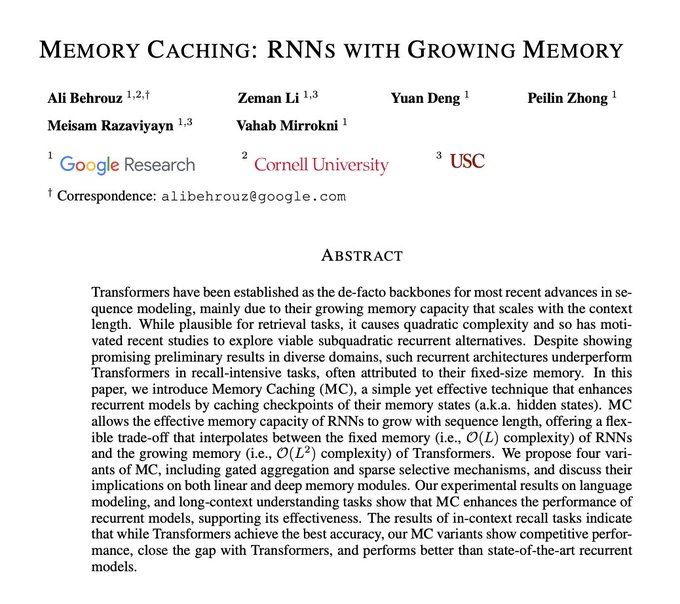
谷歌提出Memory Caching技术,通过定期保存RNN隐藏状态检查点,使循环模型的有效记忆容量随序列长度动态扩展,旨在解决RNN类架构在长序列处理中的遗忘问题。 核心事实 - 技术原理:将输入序列分段,在每个段结束时保存隐藏状态作为检查点,后续生成时回溯查询所有已缓存的历史检查点。 - 四种策略:提出残差记忆、门控残差记忆(GRM)、记忆汤和稀疏选择性缓存(SSC)四种聚合策略,其中GRM表现最优,SSC平衡效率与性能。 - 性能提升:在语言建模和长上下文理解任务中显著缩小了RNN与Transformer的性能差距,同时保持亚二次复杂度。 - 理论价值:论文指出流行的RNN-注意力混合架构可视为Memory Caching的特例,MC将其隐式机制显式化并提供了更灵活的控制。 局限性与挑战 - 参数敏感:段大小选择对性能影响大,缺乏自动化划分策略;缓存淘汰机制缺失,未讨论极长序列下的缓存总量限制。 - 实验规模:目前仅为概念验证,尚未在数十亿参数的大模型上验证效果,高效并行化内核的工程落地仍是挑战。 - 召回瓶颈:在最困难的精确召回任务上,Transformer仍保持领先,MC仅缩小差距未完全消除压缩损失。 价值点 为开发者提供了一条优化RNN及线性注意力模型长上下文能力的有效路径,有助于在保持高吞吐的同时提升长文本处理能力。
# 报错信息分析与调试指南 ## 任务说明 请分析用户提供的报错信息,推测可能的错误原因,并提供系统性的调试步骤。 ## 分析要求 1. **错误类型识别** - 确定是语法错误、运行时错误、逻辑错误还是环境配置错误 - 识别具体的错误类别(如空指针、数组越界、类型不匹配等) 2. **原因推测** - 基于错误信息中的关键线索进行合理推断 - 考虑常见的导致此类错误的编程场景 - 分析可能的代码问题或环境问题 3. **调试步骤** - 提供从简单到复杂的逐步调试方法 - 包括代码检查、日志添加、环境验证等具体操作 - 给出预防类似错误的最佳实践建议 ## 输出格式 - **错误类型**:[具体的错误分类] - **可能原因**: 1. [原因1] 2. [原因2] 3. [原因3] - **调试步骤**: 1. [步骤1] 2. [步骤2] 3. [步骤3] 4. [步骤4] - **解决方案**:[具体的修复建议] ## 示例 **输入**:【报错信息】 ``` TypeError: Cannot read property 'length' of undefined at processData (app.js:25:18) at main (app.js:10:5) ``` **输出**: - **错误类型**:运行时错误 - TypeError - **可能原因**: 1. 变量未正确初始化就被访问其 length 属性 2. 函数参数传递了 undefined 值 3. 异步操作中数据还未加载完成就尝试访问 - **调试步骤**: 1. 检查 app.js 第25行附近的变量声明和赋值 2. 在访问 length 属性前添加类型检查:`if (variable && variable.length)` 3. 使用 console.log() 输出相关变量的值确认其状态 4. 检查函数调用时传入的参数是否正确 - **解决方案**:在访问对象属性前先验证对象是否存在,或确保变量在使用前已被正确初始化。