ILLUME是华为诺亚方舟实验室推出的统一多模态大模型系列,以"连续图像输入+离散图像输出"架构将视觉理解与生成能力融入单一LLM中,仅使用15M图文对完成预训练——数据需求仅为传统方案的四分之一。ILLUME系列已演进至ILLUME+(DualViTok+扩散解码器,3B参数比肩7B模型)和ILLUME-X(自由图文交织生成,ISG-Bench统一模型排名第一)。小编将从定义、技术架构、版本演进、竞品对比等角度为您全面解析。
ILLUME是什么
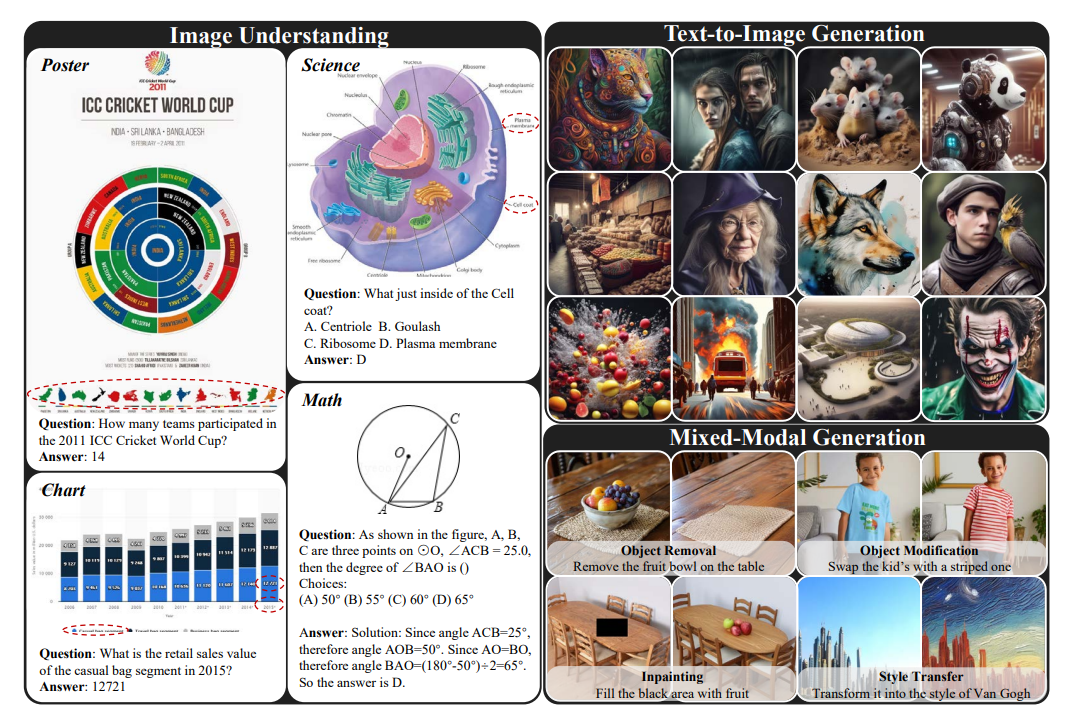
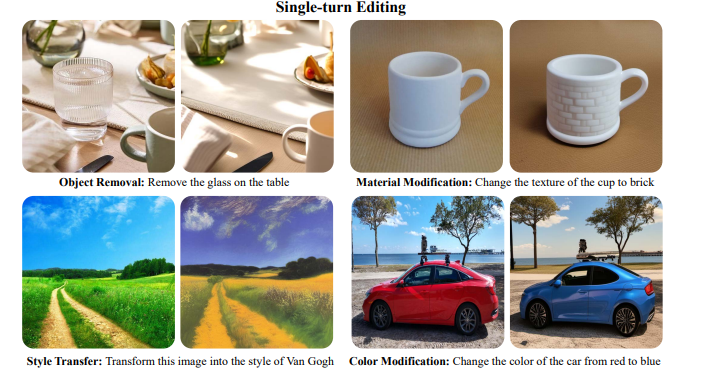
ILLUME(全称Illuminating Your LLMs to See, Draw, and Self-Enhance)是华为诺亚方舟实验室于2024年12月提出的统一多模态大模型(Multimodal Large Language Model, MLLM)。其核心设计理念是将视觉理解(看图说话、文档分析、图表解读)与视觉生成(文生图、图像编辑、风格迁移)两大能力无缝整合到同一个大型语言模型中,通过统一的"下一个token预测"(next-token prediction)公式驱动所有任务。
ILLUME的研究动机源于一个行业痛点:大多数现有AI系统将"理解"和"生成"分为两套独立模型——理解型模型(如LLaVA系列)擅长描述图像内容,生成型模型(如Stable Diffusion)擅长从文字创作图像,但两者之间缺乏深层语义联动。ILLUME的目标是打破这道墙,让同一个模型既能"看懂"图像,又能"画出"图像,并且两项能力相互促进、协同增强。
ILLUME由华为诺亚方舟实验室盘古研究团队主导研发,核心作者包括王春伟、卢冠松、杨俊伟等,论文(arXiv: 2412.06673)于2024年12月发布。项目官方页面为 illume-unified-mllm.github.io
ILLUME的核心设计原则包括:
- LLM为核心引擎:以大型语言模型作为统一的推理和生成主体,所有多模态信息最终都转化为LLM可以处理的token序列
- 连续输入+离散输出:输入侧使用连续特征保持图像信息的完整性,输出侧使用离散token实现与文本生成的一致性
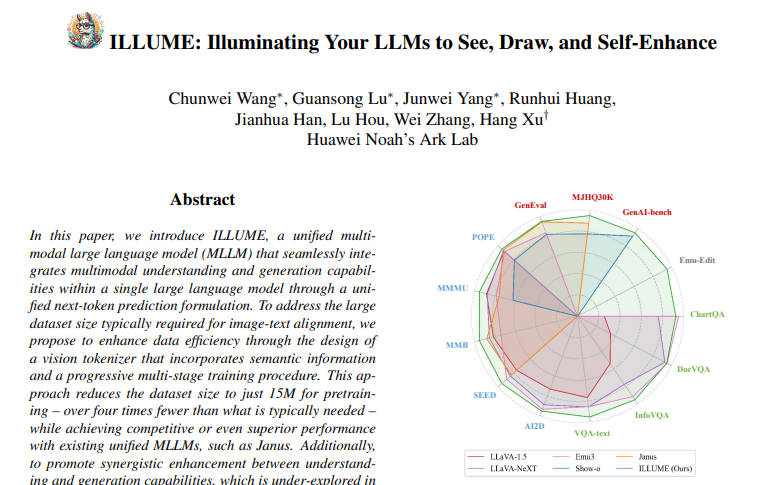
- 高效数据利用:通过语义视觉分词器和三阶段训练策略,仅需15M图文对即可完成预训练——相比Janus等模型通常需要的60M+数据量,减少了75%以上
- 自增强对齐:让模型自我评估生成图像与文本描述的一致性,通过内省式学习实现理解与生成能力的协同进化
ILLUME的核心功能与技术架构
ILLUME的技术架构由三大核心组件构成,围绕LLM形成完整的"输入-推理-输出"闭环。
语义视觉分词器(Semantic Vision Tokenizer)
传统的统一多模态模型(如Chameleon、Emu3)通常采用VQGAN等基于像素重建的视觉分词器,将图像压缩为离散token后输入LLM。这种方法的缺点是:VQGAN的量化过程只关注像素层面的重建质量,缺少高层语义信息,导致图像和文本之间的对齐效率低下,需要海量数据才能建立有效的跨模态关联。
ILLUME的语义视觉分词器打破了这一范式。它在视觉编码阶段直接融入语义特征重建目标,使图像token天然携带文本对齐的语义信息。据华为诺亚方舟实验室论文数据,这一设计使图文对齐阶段的预训练数据需求从传统的60M+级别大幅压缩至15M,同时保持了模型在视觉理解任务上的竞争力。
三阶段训练流程
ILLUME采用渐进式三阶段训练策略,确保模型在有限数据下高效学习:
- 阶段一:视觉嵌入初始化——训练视觉编码器和解码器,对齐输入和输出图像空间的表示模式,固定分辨率为256×256
- 阶段二:统一图文对齐预训练——使用15M图文对数据,打开视觉适配器和语言模型参数,将图像表征与LLM的语义空间深度对齐,分辨率从256×256逐步提升至512×512
- 阶段三:有监督微调——使用多任务高质量数据(包括理解、生成、编辑三类任务),支持任意分辨率输入,图像生成最高分辨率可达1024×1024
自增强多模态对齐策略(Self-Enhancing Multimodal Alignment)
这是ILLUME最具原创性的贡献之一。传统统一模型的理解和生成能力各自独立训练,缺乏内在联动。ILLUME提出了一种"自我纠错"机制:
- 多维度评估:对生成图像进行物体、数量、颜色、空间关系等多维度的自动评估,识别出"图文不一致"的负样本
- 内省式学习:将评估结果重新格式化并加入第三阶段训练,让模型学会主动避免生成与文本不匹配的图像
这一策略的效果体现在两个方向:更强的理解能力帮助模型更准确地判断"这张图哪里画错了",而这种判断能力又反过来约束生成过程,减少不现实和不正确的预测。据论文数据,加入自增强对齐后,模型在视觉理解和生成任务上均获得显著提升。
多任务处理能力概览
| | |
|---|
| POPE、MMBench、SEED、MME-P、MM-Vet、MMMU、AI2D | 与专用理解模型LLaVA-1.5相当,优于Chameleon、Show-O等统一模型 |
| VQA-text、ChartQA、DocVQA、InfoVQA、OCRBench | 在OCRBench上表现突出,显著优于Janus等同代统一模型 |
| | |
| | |
ILLUME系列版本演进
ILLUME并非单一模型,而是一个持续迭代的模型家族。从2024年底至今,华为诺亚方舟实验室已陆续推出三个重要版本:
ILLUME(2024年12月)——开篇之作
原版ILLUME以Vicuna-7B为基础LLM,核心贡献在于首次系统性地验证了"理解与生成协同增强"的可行性。其15M数据高效训练方法论和自增强对齐策略为后续版本奠定了理论基础。论文发表于arXiv: 2412.06673。
ILLUME+(2025年4月)——双重视觉词表与扩散解码器
ILLUME+是该系列的重大架构升级,论文发表于arXiv: 2504.01934。核心创新包括:
- DualViTok(双重视觉联合词表):将图像编码拆分为语义分支(使用预训练QwenViT提取高层语义,词表大小32,768)和像素分支(使用MoVQGAN架构保留纹理细节,词表大小98,304),两条分支协同工作,从根本上解决了前代模型"保留语义就丢纹理、保留纹理就丢语义"的二难困境。训练时引入随机噪声扰动视觉token,增强生成鲁棒性
- 扩散解码器(Diffusion Decoder):在LLM输出离散token后,额外接入一个扩散模型进行图像去噪和超分辨率,有效解决了自回归方法在高分辨率生成时的token爆炸问题(例如1024×1024的图像如果全部用离散token表示,序列长度将达到数十万级别)。扩散解码器支持将图像从低分辨率高效上采样至1024×1024
- 从粗到细的图像表示:先生成语义token(确定"画什么"),再生成像素token(确定"怎么画"),语义token作为桥梁增强文本与视觉纹理之间的对齐
- 昇腾NPU全栈训练:ILLUME+使用256张华为昇腾NPU完成训练,DualViTok和扩散解码器各需约3天,3B MLLM三阶段训练共需约13天,打通了从训练到推理的全国产算力链路
ILLUME+以Qwen2.5-3B为基础LLM,3B参数的模型在理解、生成和编辑三大基准上全面达到甚至超越7B级别的统一模型(如Janus-Pro-7B、原版ILLUME-7B),在文档相关任务上的优势尤为突出。在MJHQ-30K图像生成质量评估中,ILLUME+取得了FID=6.00的成绩。此外,ILLUME+展现出多项"涌现能力"——在未专门训练吉卜力风格和身份保持编辑数据的情况下,模型自动泛化出了这些能力。
ILLUME-X(2026年6月)——自由图文交织生成
ILLUME-X由哈尔滨工业大学、华为诺亚方舟实验室和南开大学联合研发,于2026年6月以预印本形式发布(arXiv: 2606.30054)。如果说ILLUME和ILLUME+解决的是"能看懂也能画"的问题,ILLUME-X解决的则是"图文同时创作且保持叙事连贯性"的问题。
ILLUME-X的核心能力是"自由形式的图文交织生成"——不限定输入或输出的顺序,无论是先文后图、先图后文,还是图文随意穿插,模型都能理解并生成,且在多幅图像之间保持人物形象一致性和故事情节连贯性。
ILLUME-X采用7B+7B的参数架构(共约140亿参数),在多个基准测试中表现亮眼:
- ISG-Bench(业界标准交织生成基准):平均分6.26,在所有统一模型中排名第一,大幅领先Show-o(2.33)、Anole(2.81)、MiniGPT-5(2.79),与需要多个专用组件协同工作的非统一智能体系统ISG-AGENT持平
- ILScore(自建评测):总分5.34,微弱领先于开源模型Emu 3.5(5.33),显著超过商业闭源模型Gemini 3 Pro(4.84)
- 效率优势:Emu 3.5拥有340亿参数,每张图生成约需410秒;ILLUME-X共140亿参数,每张图仅需约81秒——参数量不到一半,速度提升5倍,质量更高
- GenEval(语义对齐基准):总分0.85,颜色识别0.92、计数准确性0.81,均居首位
- DPG-Bench(复杂场景合成):总分86.38,属性准确性94.08、实体识别91.80,全部领先
ILLUME-X还验证了思维链(Chain of Thought)在图像生成中的有效性——让模型在生成图像前先用自然语言"想清楚"场景、人物状态和光线氛围,再着手生成,显著提升了生成质量。
| | | | | |
|---|
| | | | | |
| | | DualViTok、扩散解码器、昇腾NPU全栈训练 | | |
| | | | | ISG-Bench 6.26(#1),速度5倍于Emu 3.5 |
ILLUME与其他多模态模型的对比
ILLUME系列的定位是统一多模态大模型——在同一模型中同时具备理解、生成和编辑三大能力。这一赛道近年来竞争激烈,主要参与者和ILLUME的差异如下:
| | | | |
|---|
| 连续输入+离散输出,DualViTok语义+像素双分支 | | | |
| 语义特征重建(ILLUME)→ DualViTok语义+像素双分支(ILLUME+) | | | |
| ILLUME+ 3B文档理解超越Janus-Pro-7B,OCRBench表现突出 | 1.3B/7B参数,理解能力优秀但文档任务略逊ILLUME+ | | |
| ILLUME+ FID=6.00(MJHQ-30K),扩散解码器提升细节 | | | |
| DualViTok保留纹理,编辑精度高;涌现吉卜力风格等能力 | | | |
| | | | |
| | | | |
| 论文开源(arXiv),ILLUME+代码/模型部分开源 | | | |
| 15M数据高效训练+自增强对齐+昇腾国产算力+LLUME-X图文交织 | | | |
从对比可以看出,ILLUME系列的核心差异化优势在于"数据效率"和"协同增强机制"——别人需要60M+数据做到的,ILLUME用15M就能做到;别人把理解和生成当作独立能力各自优化,ILLUME让它们互相促进。此外,ILLUME+在国产昇腾NPU上完成全栈训练,这在当前AI算力自主可控背景下具有特殊意义。
ILLUME的使用注意事项与局限性
使用注意事项
- 模型定位为研究原型:ILLUME系列目前仍是学术研究项目,主要面向多模态AI研究者。普通用户无法像使用ChatGPT或MidJourney那样直接通过Web界面访问。如果希望使用,需要具备一定的深度学习工程能力,自行部署模型权重或复现训练流程
- ILLUME-X分辨率限制:ILLUME-X目前训练和评测分辨率固定在512像素,受限于模型架构和上下文长度,扩展到1024像素及以上的高分辨率图文交织生成仍是一个待解难题
- 部分版本未完全开源:原版ILLUME和ILLUME+的论文和技术细节已公开,但并非所有版本都提供了可直接下载的预训练权重。使用前需确认目标版本的开源状态
- 硬件要求较高:即使是3B参数的ILLUME+,完整训练也需要256张昇腾NPU运行约13天;推理阶段3B模型可在单卡上运行,但7B和14B版本(ILLUME-X)需要较高显存配置
- 中文场景适配有限:ILLUME系列基于英文技术论文和英文基准测试开发,中文场景下的理解和生成质量可能弱于英文场景,实际使用前建议进行中文适配评估
- 商用授权需确认:ILLUME系列作为研究项目发布,具体商用授权条款需查阅对应论文和开源仓库的许可证声明。特别是在商业产品中集成时,需确认版权和专利合规性
- 与闭源商业模型存在差距:虽然ILLUME系列在开源/学术基准中表现优秀,但与GPT-4o、Gemini等商业闭源多模态模型在通用能力、多语言支持和工程成熟度上仍有距离
以上内容基于截至2026年7月的公开论文和官方信息整理,仅供技术参考。ILLUME系列仍在快速迭代中,具体功能、性能和开源状态以华为诺亚方舟实验室官方发布和项目页面(illume-unified-mllm.github.io)为准。
 AI 速览