一、测评概况:集结主流模型,专业团队参与阅卷
2026 年高考季,本次 AI 测评迎来全面升级,不再局限单一科目,集结12 款海内外顶级旗舰大模型同步应战全国一卷语文、数学试题。参赛阵容阵容完整,海外代表有 Claude Opus 4.8、GPT-5.5、Gemini 3.1 Pro 三大主流模型; 国内则涵盖千问、文心、星火、智谱 GLM、Kimi、MiniMax、DeepSeek、小米 MiMo 等多款热门国产大模型。 为保证评分严谨性,主办方特邀 4 位具备高考阅卷经验的教师参与批改,3 名教师负责语文主观题评分,1 名教师专职批改数学试卷,全程保障测评专业度。
二、多重管控,打造公平测评环境
为规避作弊、评分偏差等问题,本次测评制定了一套完整公平规则。
功能层面,统一关闭网页搜索、代码推理等辅助工具,杜绝 AI 借助外挂答题;
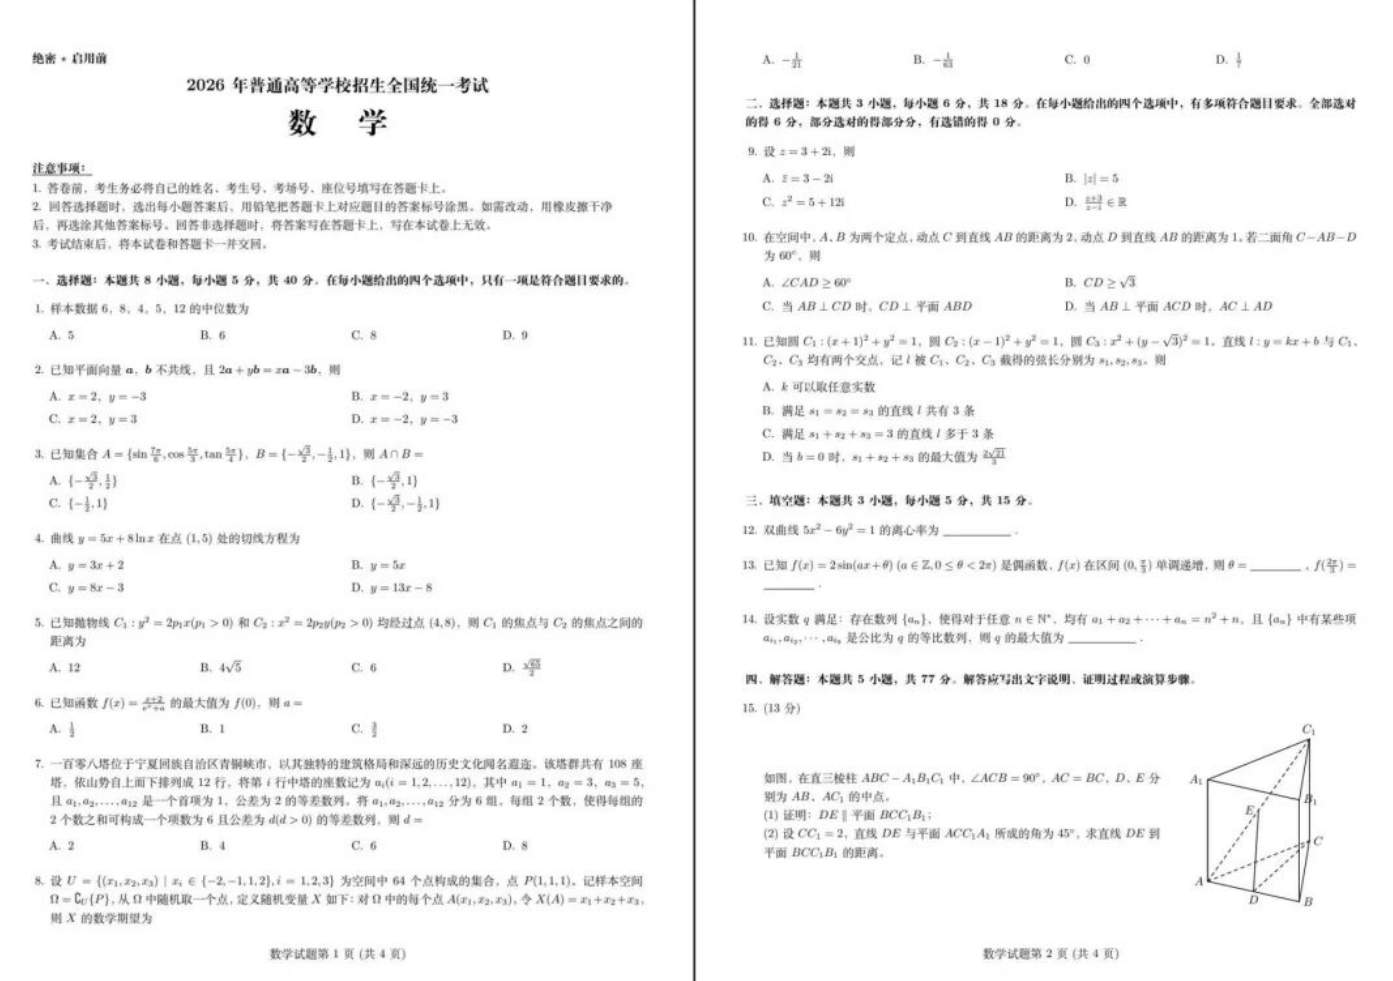
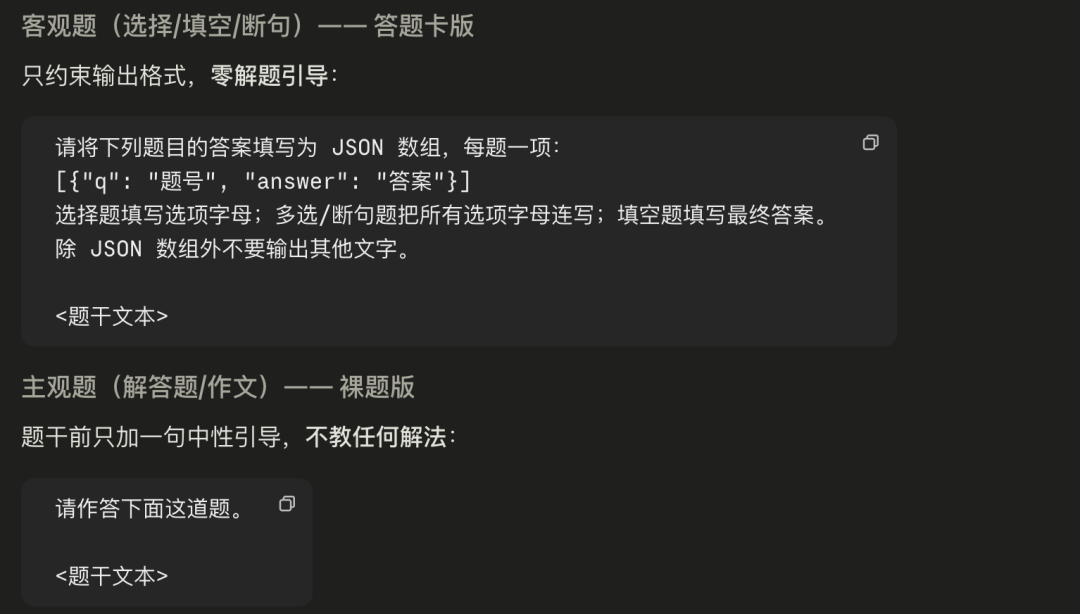
格式方面,所有试题转为 LaTeX 纯文本,并配备专用脚本校验内容准确性。
同时团队自研自动化考试系统与匿名阅卷平台,客观题由系统自动判分,主观题实行盲评,阅卷老师无法看到模型名称。
语文因未拿到完整试卷,采用官方部分试题折算为 150 分制,数学使用完整真题,还特意适配数学答案多种写法,进一步降低评分误差。
三、实测成绩:头部模型分差微弱,偏科现象普遍
经过 12 小时阅卷,最终成绩出炉。
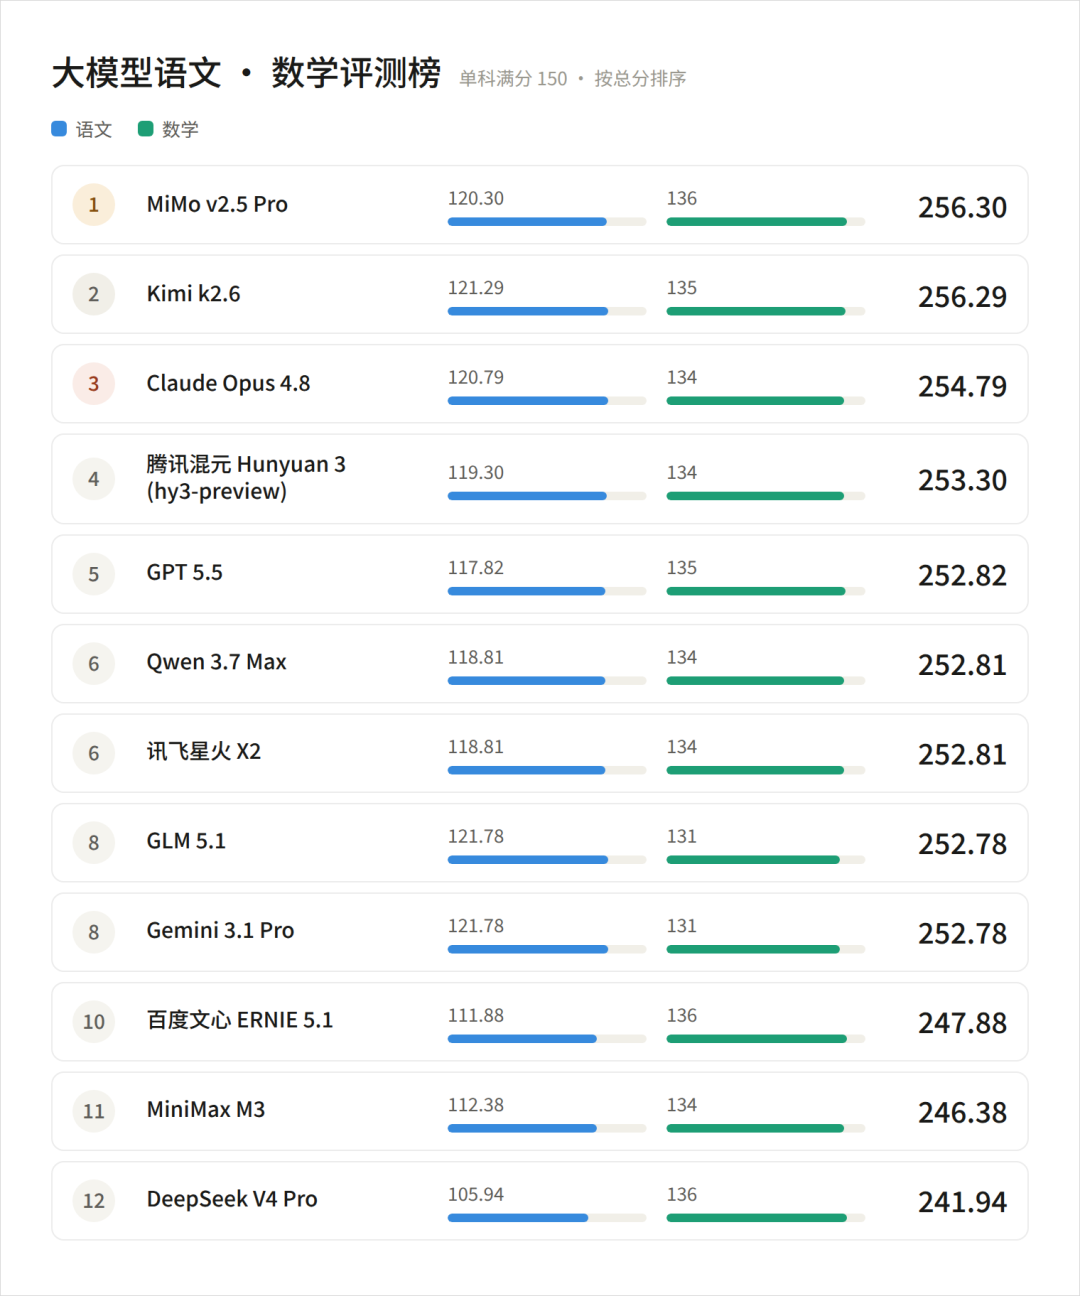
综合总分竞争异常激烈,小米 MiMo v2.5 Pro 以 256.3 分排名第一,Kimi k2.6 仅以 0.01 分之差位列第二,第三名至第九名的七款模型总分差距不足 2 分,头部大模型应试能力旗鼓相当。 单科表现分化显著:
GLM5.1、Gemini 3.1 Pro 并列语文榜首;
DeepSeek V4 Pro、MiMo、文心 ERNIE 5.1 拿下数学最高分,但 DeepSeek 作文短板突出。
数学整体答题正确率较高,仅最后一道填空题全员答错,Claude 解答压轴题时反复重试,消耗大量 Token;多款 AI 作文普遍存在结构模糊、论证不充分等问题。
四、历年复盘与行业总结
回顾四年 AI 高考测评历程,从最初仅测试高考作文、手动录入题目,到如今自动化脚本、专业阅卷平台全流程落地,清晰见证国产大模型的崛起速度。
需要注意的是,本次结果仅代表应试答题水平,不反映代码、Agent 等核心能力。现阶段顶级大模型应对标准化数理题目表现优异,但语文主观创作、超高难度压轴题仍是普遍短板,这也将成为各大模型后续迭代优化的重要方向。
 AI 速览