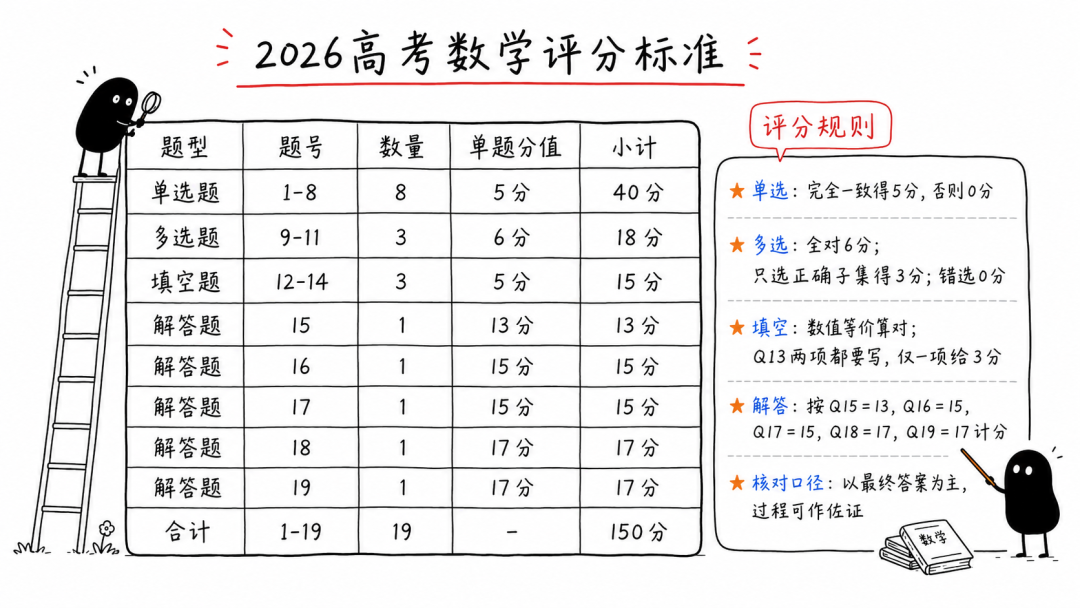
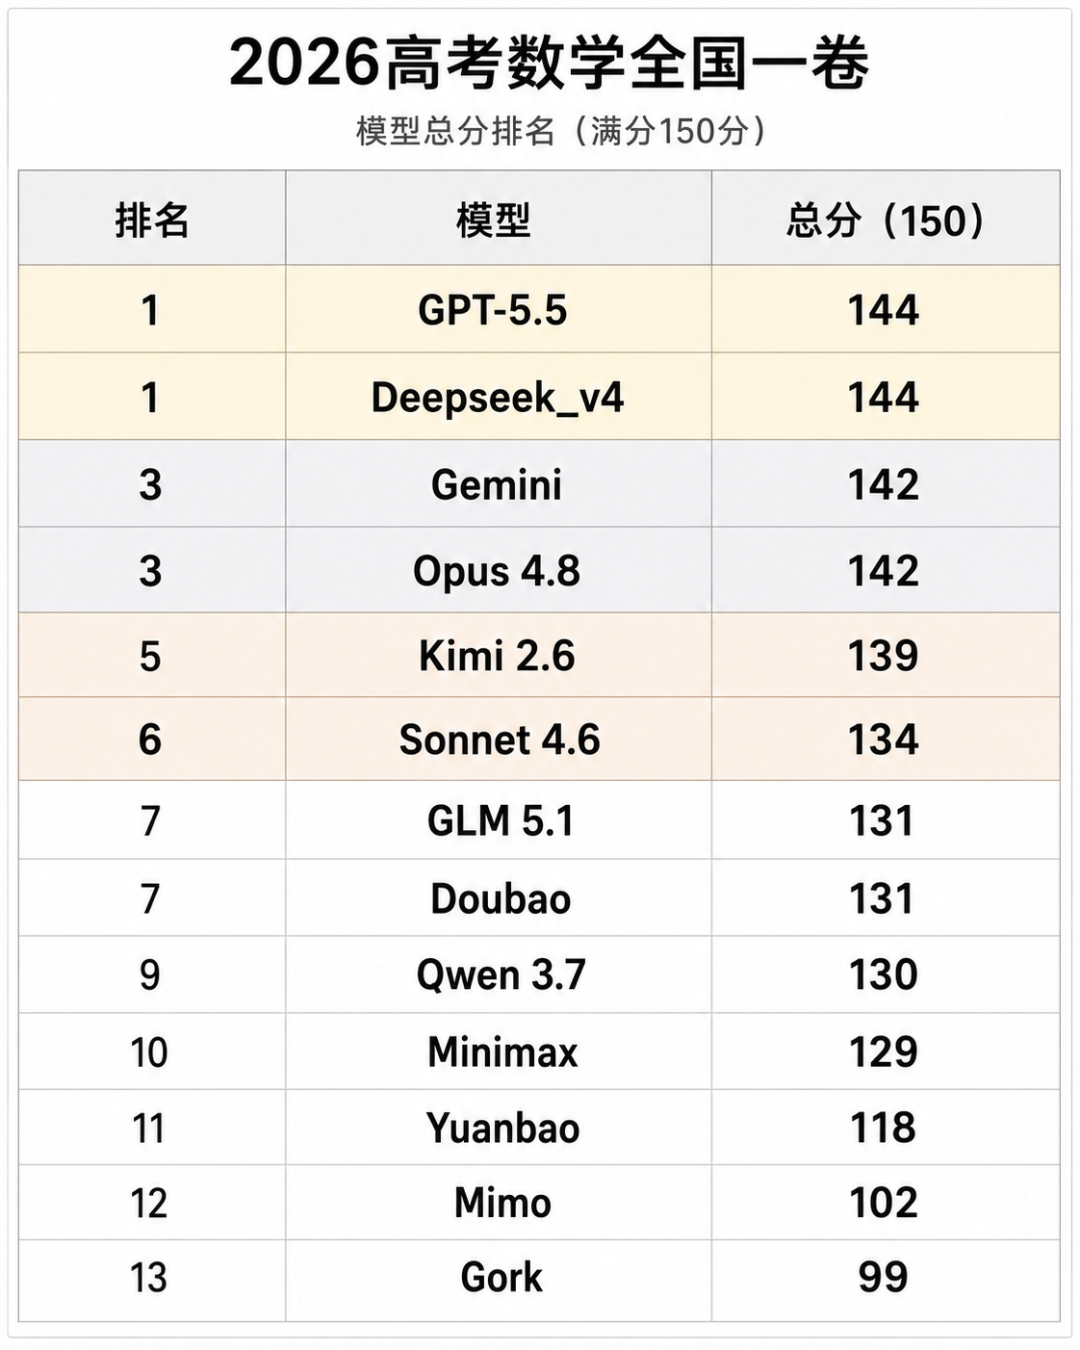
2026 年高考数学全国一卷因难度偏高引发全网热议,博主集结13 款海内外主流顶级大模型开展全真答题测试,模拟高考规则完成整套试卷作答。
本次实测直观展现了各大模型数理推理实力的差距,也暴露出当前 AI 在严谨解题、细节把控上的诸多短板。
一、测试背景与公平规则设置
本次参赛阵容十分全面,包含 Claude 系列、GPT 5.5、Gemini 3.1 Pro、千问、Kimi、MiniMax、Deepseek、豆包等主流模型。 为保证测评公平,团队制定严格答题规范:统一将试卷 PDF 转换为 LaTeX 格式,规避图像、格式识别误差;全程关闭网络、代码及外部工具调用,模拟考场环境。所有模型独立开启会话,严格按照高考标准书写解题步骤、推理过程,禁止跳题、敷衍作答,最大程度还原真实考试场景。
二、模型得分四大实力梯队
根据最终得分与答题表现,13 款 AI 被划分为四个梯队。
第一梯队由 GPT 5.5、Deepseek-v4 Pro、Gemini 3.1 Pro、Claude Opus 4.8 并列组成,整体答题稳定,难题也可完整拆解,达到顶尖应试水平; 第二梯队为 Kimi 2.6,大题解答能力突出,但常在选择题、填空题等细节处失分; 第三梯队是多数主流模型,涵盖 Claude Sonnet 4.6、GLM 5.1、豆包、千问、MiniMax M3,发挥平稳,常因疏漏丢失分数;
元宝、Mimo、Grok 位列最后一档,仅能稳定解答基础题型,高阶题目失分严重。 三、实测暴露共性问题
本次测试暴露了大模型的多重短板。
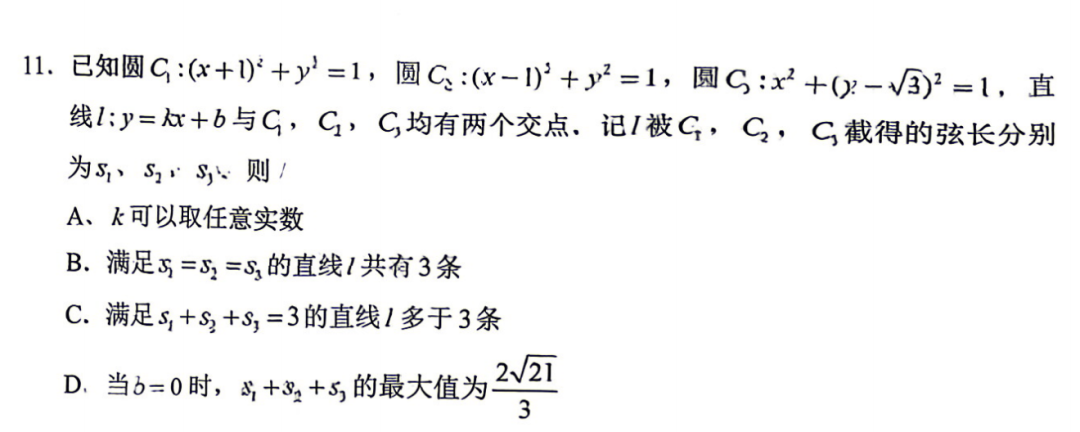
题型层面,第 11 道多选题成为 “全员难题”,模型易误判边界条件,过度选择干扰项;
第 6 题因题目版本差异、格式识别失误,半数模型答错。
技术层面,部分模型作答后半段遗忘题干条件,Claude 等出现思考超时、上下文截断问题。此外还出现特殊情况,Claude Sonnet 4.6 试图搜题,Deepseek 直接拒绝作答。
长解答题中,多数 AI 存在步骤缺失、论证不完整等问题。
四、实测总结与行业启示
头部大模型的数理推理能力已比肩顶尖考生,能够应对高难度高考数学试卷,但严谨性、长文本记忆、逻辑边界判断仍是普遍短板。
AI 可以梳理解题思路,却难以像人类一样精细把控题目条件、甄别诱导选项。本次娱乐向测试,清晰划分了不同模型的数理能力差距,也为大模型迭代指明方向。未来,除强化推理能力外,优化读题精度、长上下文记忆与细节把控,将是 AI 提升综合应试与专业解题能力的关键。
 AI 速览