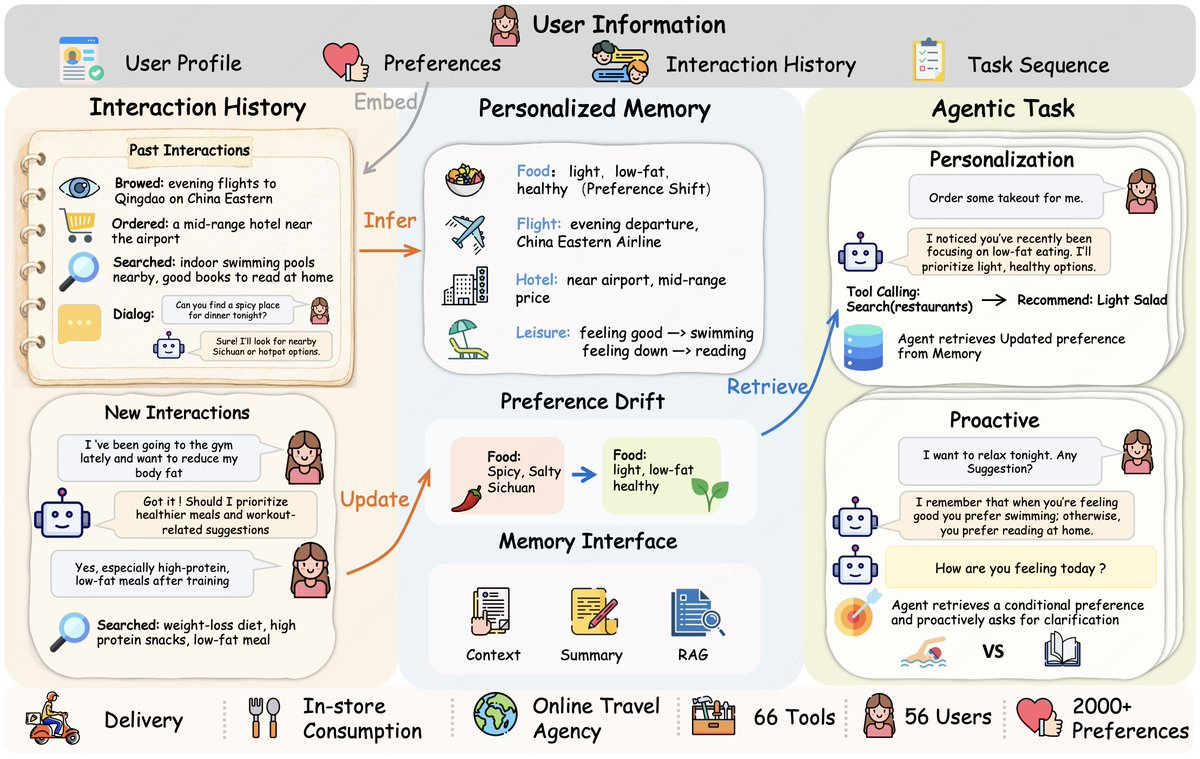
美团 LongCat 团队联合新加坡国立大学、中国科大发布 VitaBench 2.0,这是目前唯一针对长期用户交互场景的个性化 Agent 基准测试,覆盖 56 名真实用户画像、819 个子任务、2000+ 条动态偏好和 66 个可执行工具。结论简洁但刺痛行业:即便把用户完整交互记录全部塞进上下文,排名第一的 Claude Opus 4.6 综合得分也只有 0.503;开启记忆模块后,多数模型成绩不升反降。 这套测试到底测了什么
VitaBench 1.0 在 2025 年 10 月上线,聚焦外卖、到店消费和在线旅行三大场景下的跨场景工具调用,当时最强模型的跨场景成功率仅 32.5%。2.0 版本保留了同一套工具体系,但核心评估维度从「能不能完成任务」转向「能不能理解你」。具体拆成四层能力:偏好提取(从碎片化对话和行为日志中推断隐性偏好)、偏好利用(将偏好落实到多步决策中)、偏好更新(捕捉偏好漂移并修正认知),以及主动交互(发现信息缺失时主动向用户提问而非盲目执行)。
数据构造上,每个用户平均有 2093 次交互事件,时间跨度约 1580 天(近 4.3 年),交互类型涵盖浏览、下单、评价、搜索等异构行为。偏好并不直接暴露给模型,而是嵌入在碎片化历史中,混杂大量噪声信号。这种设计直接命中当前 AI 助手产品的核心场景——你不会告诉 Siri 或 Claude 你所有的喜好,它得自己从日常使用中学会。
排行榜拆解:谁的得分最高,差距有多大
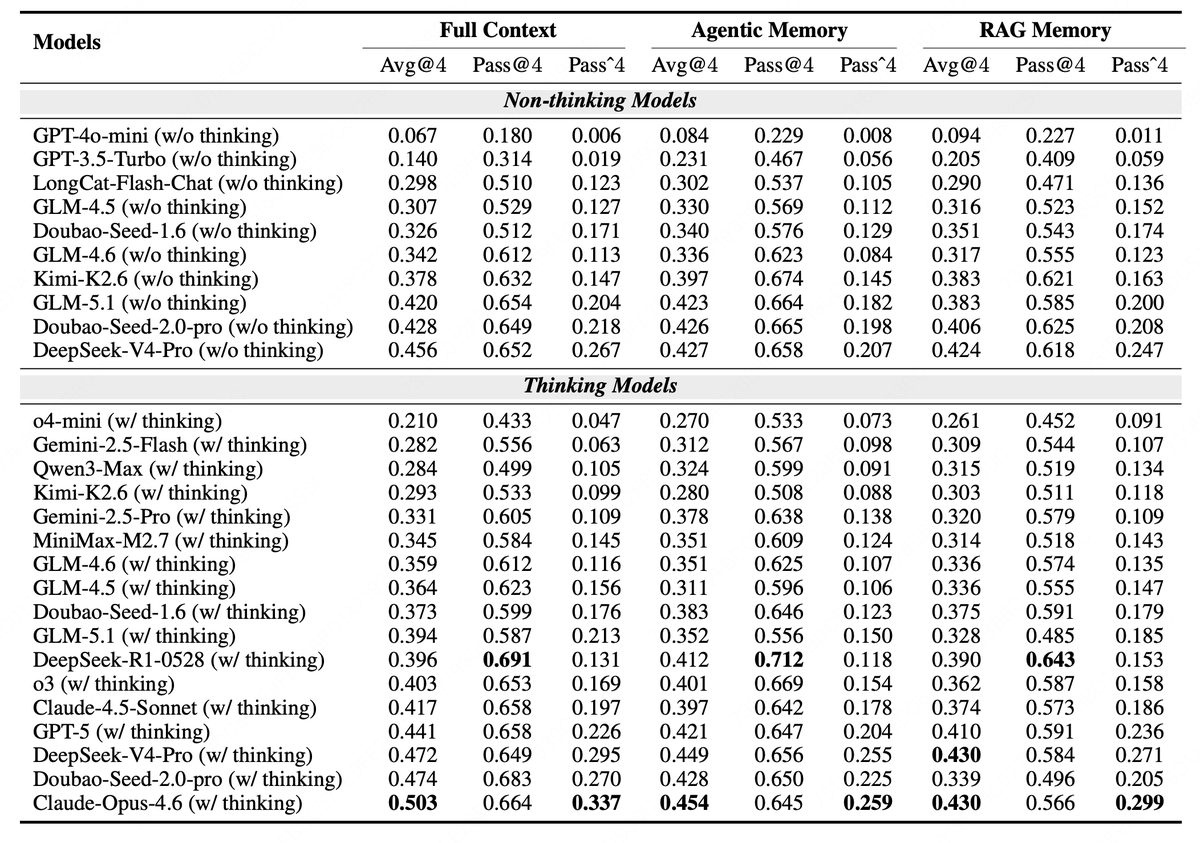
VitaBench 2.0 设置了三种记忆模式进行对照:Full Context(完整上下文直接输入)、Agentic Memory(模型自主管理的结构化记忆)和 RAG Memory(向量检索记忆)。评测覆盖 17 款思维链模型和 10 款非思维链模型,每个结果取四次独立运行的平均值。
思维链模型中,Claude Opus 4.6 在 Full Context 下以 0.503 的 Avg@4 排名第一,豆包 Seed 2.0 Pro 紧随其后拿到 0.474,DeepSeek V4 Pro 得分 0.472,GPT-5 为 0.441。注意这个天花板——0.503 意味着即使给了全部历史信息,模型仍有近一半的偏好无法正确识别和执行。更值得关注的是底部:Gemini 2.5 Pro 仅 0.331,o4-mini 只有 0.210,推理能力强不代表个性化能力强。 非思维链模型的排名格局不同。DeepSeek V4 Pro(非思维链版本)以 0.456 领跑,豆包 Seed 2.0 Pro 和 GLM-5.1 分别拿到 0.428 和 0.420。Kimi K2.6 得分 0.378,GPT-4o-mini 则仅有 0.067,几乎不具备个性化能力。一个有意思的对比:Claude Opus 4.6(思维链)拿到 0.503,而 GPT-5(思维链)只有 0.441,两者在通用推理榜单上差距并不大,但个性化任务把能力差距放大了。 三个反直觉发现
第一,开记忆反而变差。多数模型从 Full Context 切换到 Agentic Memory 后,Avg@4 出现下降。Claude Opus 4.6 从 0.503 降至 0.454,GPT-5 从 0.441 降至 0.421,GLM-5.1 从 0.394 降至 0.352。RAG Memory 的下降幅度更大,Claude 降到 0.430,豆包降到 0.339。原因在于:Agentic Memory 在反复更新和检索的过程中引入信息丢失和错误累积,早期的偏差会传导到后续所有任务;RAG Memory 则容易检索到表面匹配但实际不相关的内容。少数例外是 Gemini 2.5 Pro,它在 Agentic Memory 下反而从 0.331 升至 0.378,说明某些模型在结构化记忆管理上有独特优势。
第二,思维链对个性化几乎无帮助。论文直接给出了散点图:思维链模型和非思维链模型在 Avg@4 和交互轮次两个维度上完全重叠,没有系统性优势。推理链条可以帮模型解数学题、写代码,但对「你喜欢辣还是不辣」「你上次出差订了什么类型的酒店」这类偏好推断几乎不产生增益。个性化需要的是偏好抽取、噪声过滤和漂移检测,而非逐步推理。
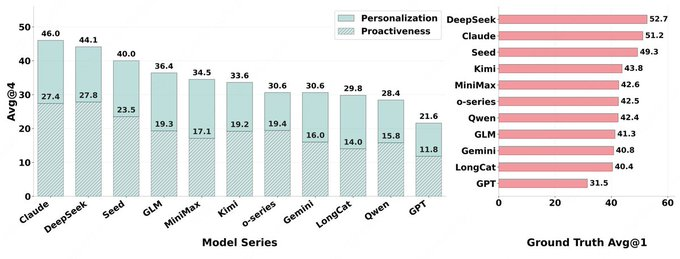
第三,模型不知道自己不知道什么。主动交互得分全面低于个性化得分,Claude 从 46.0 暴跌至 27.4,DeepSeek 从 44.1 跌至更低水平。面对关键信息缺失,绝大多数模型选择直接执行而非向用户确认,哪怕错误概率很高。这在实际产品场景中意味着:你的 AI 助手大概率会帮你点一份你过敏的菜,而不是先问一句。
给了正确答案还是做不对
VitaBench 2.0 做了一组更极端的实验:直接把用户的真实偏好作为 ground truth 喂给模型,绕过提取环节,只测「能不能用好偏好」。结果同样令人失望——头部模型在这种理想条件下仍然只能达到中等水平。这说明个性化的瓶颈不仅在于「记不住」,更在于「用不好」:偏好之间存在优先级冲突、条件依赖和场景切换,模型无法有效排序和组合。
论文对 DeepSeek R1 和 DeepSeek V4 Pro 的失败模式做了对比分析。随着模型能力从 R1 提升到 V4 Pro,工具调用类错误(参数错误、调用失败、执行遗漏)显著减少,但偏好类错误(偏好遗漏、偏好冲突、偏好过时、条件偏好忽略)反而占比上升,成为失败的绝对主因。工具调用在变简单,偏好理解在变成新的硬上限。
对行业意味着什么
VitaBench 2.0 的数据指向一个清晰结论:当前所有主流大模型,无论是 Claude、GPT、DeepSeek 还是国内的豆包、GLM、Kimi,在真实长期用户个性化这件事上都处于早期阶段。0.5 分的天花板意味着这些模型对你的了解还不到一半。
但也要注意这套测试的局限。一是用户画像和偏好由模型合成,而非真正来自线上用户的行为数据,仿真程度与真实世界存在差距。二是评估场景集中在生活服务领域(外卖、酒店、旅行),对知识工作、创作辅助等场景的覆盖有限。三是记忆接口虽然设计了统一框架,但实际产品中的记忆系统远比这复杂——Claude 的 Memory、ChatGPT 的 Memory、Kimi 的长期记忆各自有不同的工程实现和产品策略,统一测试框架可能无法反映这些差异。
对于 AI 产品团队而言,这份数据是一个有价值的校准信号。推理能力的军备竞赛已经进入收益递减阶段,个性化和主动服务将是下一轮竞争的主战场。谁先在偏好建模和长期记忆上取得实质突破,谁就能在 AI 助手的体验层面拉开差距。VitaBench 2.0 的 GitHub 仓库和 HuggingFace 数据集已全部开源,值得跟进。
主页:https://vitabench2.github.io
GitHub:https://github.com/meituan-longcat/vitabench-2.0
数据集:https://huggingface.co/datasets/meituan-longcat/VitaBench-2.0
 AI 速览