随着大模型 API 服务的普及,第三方中转商 “挂羊头卖狗肉” 的乱象持续存在:用低成本小模型或量化版本冒充高端模型赚取差价,普通用户在日常场景中几乎无法分辨。
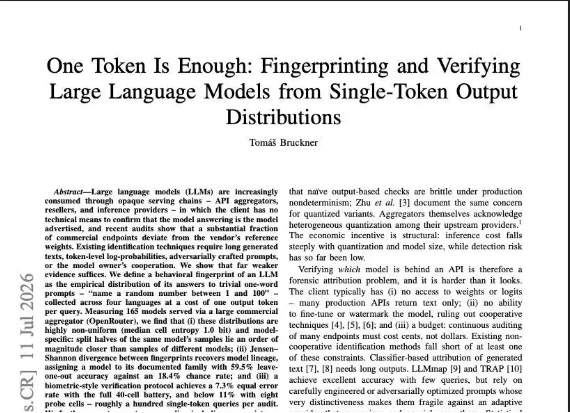
近期发表在 arXiv 的论文《One Token Is Enough》提出了一种极简的模型鉴别方案:仅通过 “说出 1 到 100 之间的随机数” 这类单 Token 问题,利用模型独有的输出概率分布(即行为指纹),就能精准识别模型真实身份,成为检测套壳大模型的低成本 “照妖镜”。
一、套壳乱象与传统鉴别方案的现实困境
大模型的推理成本与参数规模近乎线性相关,百亿级与千亿级模型的单次调用成本可相差 5 到 10 倍。
巨大的价差催生了套利空间:部分中转服务商将用户付费的高端模型偷偷替换为小模型或极致量化版本,在日常对话、信息查询、简单翻译等场景下,两者的输出差异极难被用户感知,仅在复杂推理、长代码开发等深度任务中才会暴露短板。
传统的模型鉴别方法存在明显局限:要么需要构造特殊的对抗性提示词、采集长文本输出并训练分类器,技术门槛高、检测成本高;要么探测 Prompt 特征过于明显,中转商可轻易识别审计请求,临时切换为真实模型规避检测。
普通企业与个人用户几乎没有可行的手段核验 API 真伪,只能被动承担被降质的风险。
二、行为指纹:单 Token 输出构成的独特身份标识
布拉格经济大学研究员托马什・布鲁克纳提出的 “行为指纹” 技术,核心逻辑十分简洁:每款大模型对 “随机数”“随机颜色” 等简单问题的输出概率分布都具有唯一性,如同人类的指纹,无法被轻易抹除。
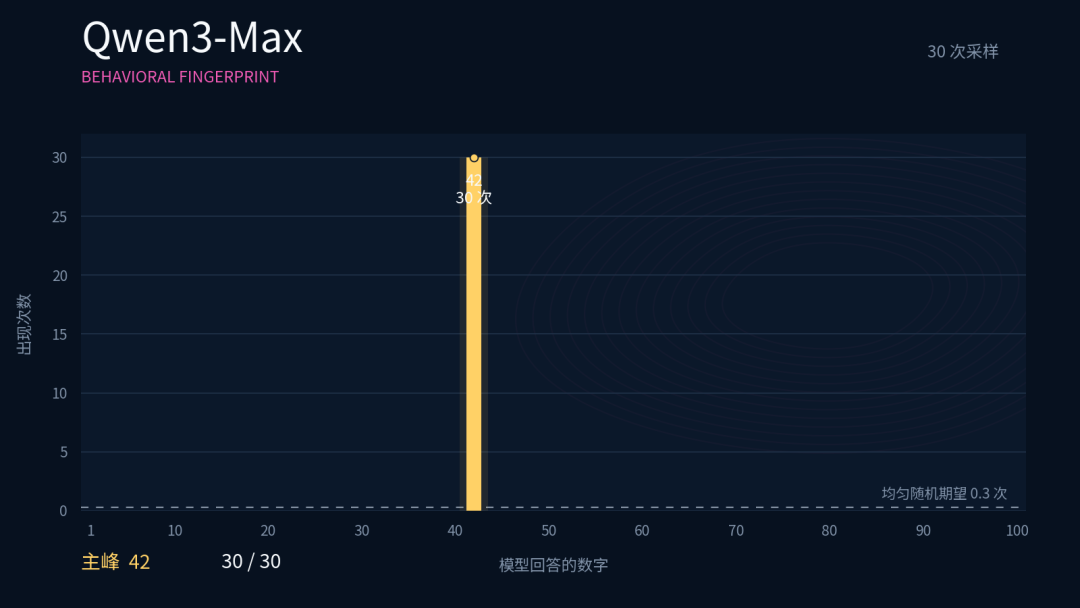
研究团队针对 OpenRouter 平台的 165 款模型展开测试,对每个模型重复提问数十次 “给出 1 到 100 的随机数”,统计结果显示所有模型的输出都远非均匀分布,且各有稳定的数字偏好:GPT-4o 高频输出 42、37,Claude Sonnet 5 集中输出 47,Llama 3.3 偏好 53,Qwen3-Max 则 30 次测试全部输出 42,无一例外。 数据证明,同一模型的两组样本分布差异,比不同模型的差异小一个数量级。通过计算两组分布的 Jensen-Shannon 散度,即可判断两端是否为同一款模型。该方法可扩展到随机动物、随机城市、抛硬币等十类任务,形成多维度指纹组合,进一步提升鉴别精度。
三、技术优势:低成本、高隐蔽、落地门槛极低
这套鉴别方案之所以具备实用价值,在于它同时解决了成本、隐蔽性与准确率三大核心问题。
一是成本极低,单次查询仅输出一个 Token,百次测试的成本仅需几分钱,支持对 API 端点进行常态化批量审计;
二是隐蔽性极强,“说一个随机数” 属于极常见的日常对话,完全融入正常业务流量,中转商无法通过 Prompt 特征识别探测请求,也就无法临时切换模型作弊;
三是准确率达标,使用 40 个探测单元时的等错误率仅 7.3%,仅用 8 个探测单元也能控制在 11% 以内,效果接近专业级鉴别方案,但落地门槛几乎为零。
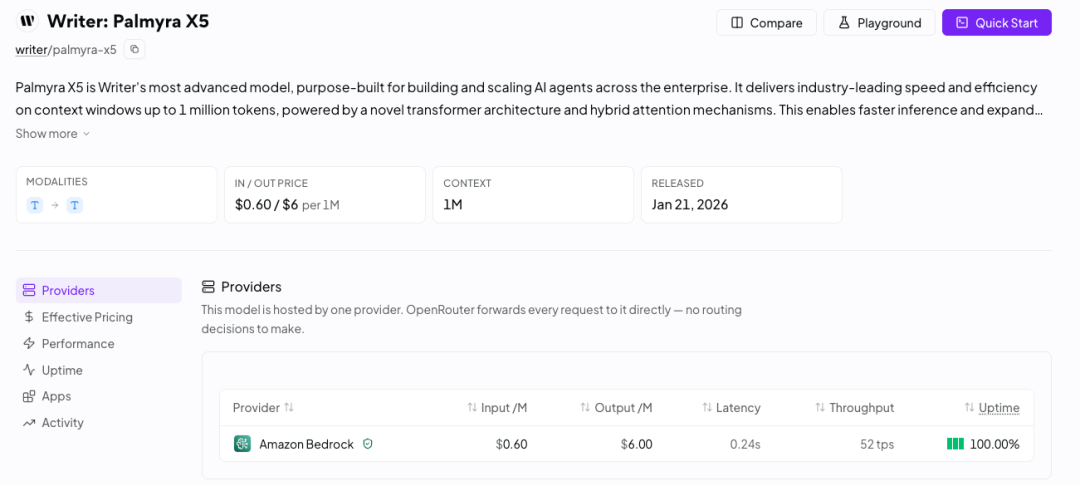
研究团队还通过该方法发现了典型案例:OpenRouter 平台上标称自研旗舰的 Palmyra X5,其行为指纹与通义千问 Qwen3-235B 几乎完全重合,相似度处于同一模型不同部署环境的正常波动范围内,疑似直接套壳开源模型。 四、底层逻辑:刻在权重里的偏好无法被抹除
所有大模型都无法生成真正均匀的随机数,本质源于其运行机制:大模型基于海量训练数据的统计规律生成内容,本身不具备真随机生成能力,所谓的 “随机输出”,只是从语料中挑选最符合 “随机感” 的答案。
这一现象与人类生成随机数的心理偏好高度同源:人类会本能认为质数、非规整数字更 “随机”,文化符号(如《银河系漫游指南》中代表终极答案的 42)也会强化特定数字的出现频率;大模型则将人类语料中的集体偏见压缩、放大,固化为自身的输出概率分布。正是这种刻在模型权重里的深层习惯,成为了无法抹除的身份标识。
哪怕更换产品名称、修改系统提示词、套上全新的交互外壳,底层的概率偏好依然会从单个 Token 的输出中泄露出来,成为模型最真实的 “身份证”。整体而言,行为指纹技术为 AI 服务市场的信任问题提供了极简的解决方案,既可以帮助普通用户低成本核验 API 真伪,也能为行业合规审计提供轻量化工具。
随着技术持续完善,这套方法还可拓展到模型版本核验、降智检测、溯源追踪等场景,推动大模型服务市场走向更透明、更规范的发展方向。
 AI 速览