用 WorkBuddy 接入 DeepSeek V4 Pro,花了 15 小时、5 个开发会话,写完 8660 行代码、搭起一套完整的全栈 Skill 工具市场——答案是:能替代。而且不只是实验室跑通,是真项目跑通的。如果你也在纠结这个组合到底靠不靠谱,这篇可能正好回答你的问题。 为什么要自己造一个 SkillHub
背景是这样的:团队里 Skill 越积越多,但散在每个人的本地机器上,根本管不住。需要一个能私有部署的平台——上传、下载、更新、共享,不连外网,不注册第三方服务,docker-compose up 直接跑起来。
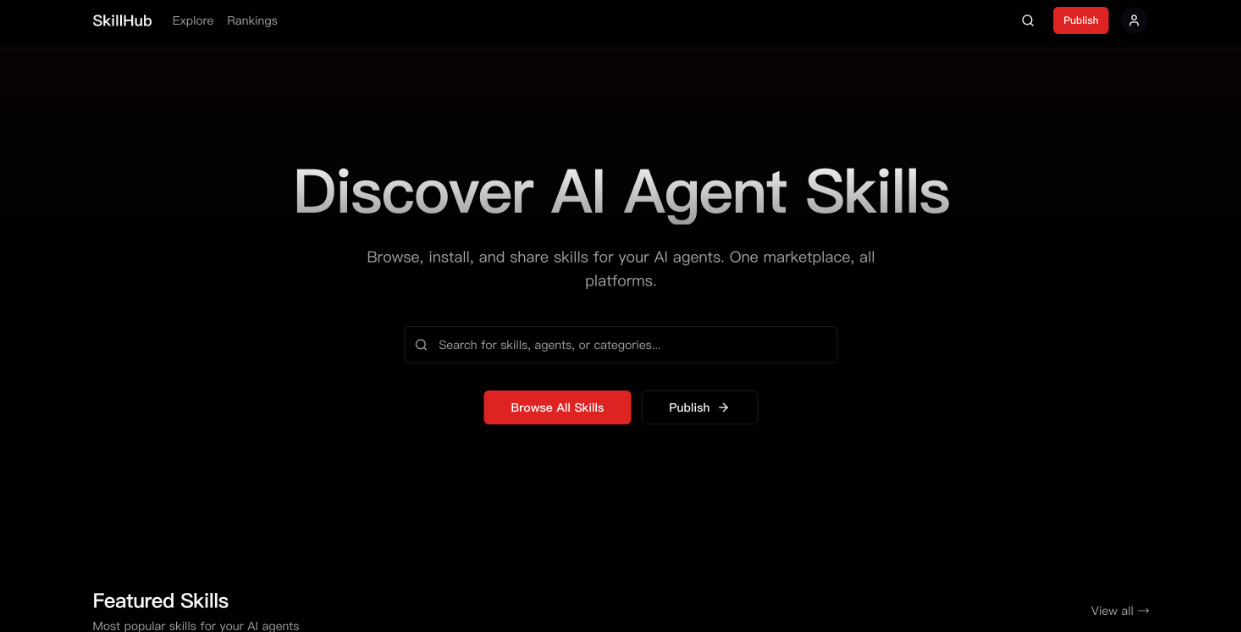
盯上过 ClawHub,它的产品设计很成熟:Skill 发布、浏览、安装、版本管理、排行榜。但架构一看,Convex 后端 + Convex Cloud 部署,对云服务依赖太深,没办法直接私有化。
所以只能自己造,项目命名 SkillHub。
架构分四层:Next.js 前端 → REST API(20个接口)→ Prisma + PostgreSQL(带 pgvector)→ 存储后端(GitLab / GitHub / S3 / OBS)。前端保留 ClawHub 的交互范式,后端全部换掉。
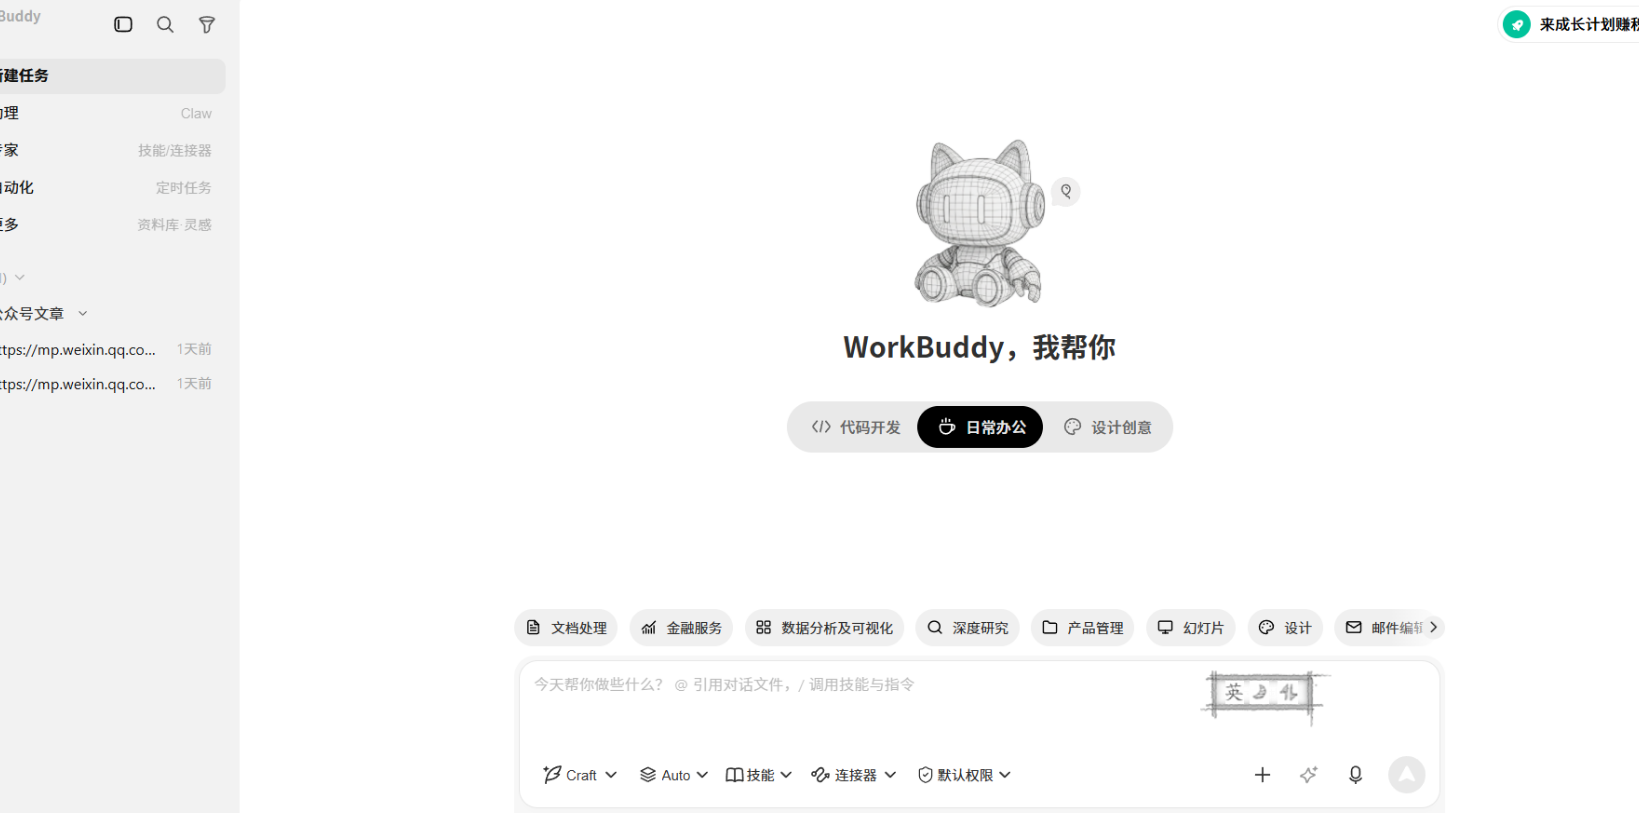
WorkBuddy 在这个项目里扮演什么角色
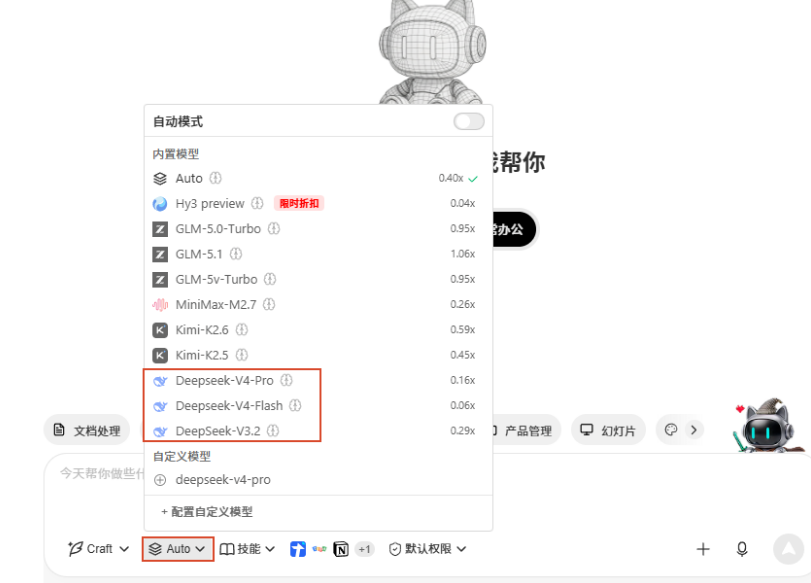
把 WorkBuddy 当 IDE 用——对话驱动开发,描述需求,它写代码,你验收。模型换成 DeepSeek V4 Pro,后者是 2026 年 4 月刚发布的 MoE 架构大模型,1.6T 总参数、49B 激活参数,支持 100 万 token 上下文,定价比 Claude 便宜一个量级。 实际体验下来,WorkBuddy 的几个能力很扎实:
说"加一个安全扫描模块",它自己分析现有代码结构,决定放在 lib/security.ts,写出 15 种检测模式,连风险分级都一起带上了;
描述"Skill 包存储要支持 GitLab API",它主动查阅 GitLab REST API 文档,设计了 SigV4 签名 + 代理下载的完整链路;
加一个数据库字段,它自动同步更新 Prisma schema、API 路由、类型定义、前端组件——10 个字的指令,改了 6 个文件;
prisma db push 报错,它读日志、定位原因、修复代码、重跑——全程不需要你介入。
5 个会话里,没有一次因为模型能力不足需要回退。
真实产出数据
项目总行数 8660 行(TypeScript + TSX + CSS + Prisma + JSON + YAML + Shell + Docker + Nginx),源文件 98 个,15 个数据库模型,20 个 API 路由,14 个前端页面,5 个核心模块:语义搜索、安全扫描、版本管理、多存储后端、ClawHub 导入工具。
安全扫描器检测 15 种恶意模式;搜索层 pgvector 语义向量搜索和关键词回退并存。ClawHub 能实现的功能,SkillHub 做到了对等,甚至依赖更少、成本更低。
这次跟 Claude Code 的体感有什么不同
用 Claude Code 的节奏是:你告诉它怎么做——用什么库、调什么 API、放在哪个文件。你是副驾驶,架构图在脑子里,让 AI 帮你敲键盘。
WorkBuddy 这次不一样。你只描述现象和要求,它自己读文档、自己选方案、自己决定文件结构。没说过"用正则",没指定"放在 lib 目录",没提"返回值类型"——它自己决定的。
这种模式下,你的角色变了:从"指挥 AI 干活"变成"提需求、审输出"。以前 80% 时间写代码、20% 时间审代码;现在 20% 时间描述需求、80% 时间审代码。注意力反而集中在更高杠杆的事上——代码逻辑对不对、架构选择是否合理、边界条件有没有兜住。
Claude Code 让你写代码更快,WorkBuddy 让你不写代码也能交付项目。
WorkBuddy + DeepSeek V4 Pro的几个真实的卡点
Debug 跨三个以上模块时,诊断能力会变弱——能看到问题在哪,但跨模块追踪需要手动引导,告诉它"问题在存储层,查 lib/skill-package-storage.ts"这类指令。
前端组件略偏样板化,Radix UI + Tailwind 的组合用得还行,但布局少了点设计感。根源是需求描述太笼统,给出具体布局参考后输出质量会好很多。
DeepSeek V4 Pro 跟 Claude Opus 最大的差距在"读心术"。Claude Opus 你说半句它能猜到你要干什么,DeepSeek 不行——你说"加个搜索功能",它可能给你全量匹配的 SQL,而你想要的是 pgvector 语义搜索。解决办法就是把需求说细。
长任务链跑久了,DeepSeek 偶尔会"忘记"早期设定的约束,需要偶尔拉一下。
真正重要的结论
代码生成已经商品化了。如果你还在纠结"用哪家模型写代码",关注点其实已经偏了。
这个项目换 Claude Opus + Claude Code 来做,结果不会有本质差别。
真正决定你能不能把事干成的,是:需求能不能说清楚、能不能持续迭代、AI 写了 8000 行代码之后你还知不知道自己在做什么。
AI 编程的下半场,拼的不是模型,是工程纪律。
WorkBuddy 提供了对话驱动的结构化开发框架,DeepSeek V4 Pro 提供了足够的推理和 Agent 执行能力。两者加在一起,在真项目上跑通了。最终结果:PostgreSQL 和 Redis 跑在 Docker 里,Skill 包存到 GitLab,curl -sS hub/i/slug | sh 一键安装,版本管理、一键分发,完全自主可控。
WorkBuddy 用着还不错,首 Token 响应快,没有异常中断。但每个 Agent 都有自己的脾气,偏好记忆上需要磨合一段时间,这个绕不开。
 AI 速览