一个写得工整的 Agent,上线第一天就开始乱调 API——这是做多智能体应用的人都踩过的坑。不懂行业黑话、漏掉业务规则、工具参数填错、规划步骤绕远路,每次修一个问题都得回头改 Prompt、换模型、重新跑数据、再部署一遍。真正头疼的不是 Agent 第一版跑不起来,而是它跑起来之后没法持续变好。
阿里通义实验室最近把 AgentScope 框架里的 Tuner 模块推到了台前。核心思路一句话:不要再把「写 Agent」和「调 Agent」当成两件事。写完 Agent 工作流,加几行配置,就能直接进入提示词优化、模型选型或者强化微调,指标和线上效果走同一条链路。这在 DSPy、Agent Lightning、LangSmith 各自占着一段能力的 Agent 优化市场里,算是第一个把三层调优封装进同一套 API 的开源方案。
阿里通义实验室把 Agent 的下半场写进了一个 Tuner 里
AgentScope 本身不是新东西。它是阿里通义实验室 2024 年 2 月就对外的多智能体开发框架,2025 年 9 月发布 1.0,定位是「以开发者为中心的企业级多智能体框架」,支持 ReAct 范式、MCP 协议、A2A 智能体通信,并集成了 AgentScope Studio 可视化监控和 AgentScope Runtime 沙盒部署。到 2025 年 11 月,AgentScope 集成了同门的 Trinity-RFT 库打通智能体强化学习;2026 年 1 月又继续扩展了记忆压缩、双周社区会议等一系列功能更新。
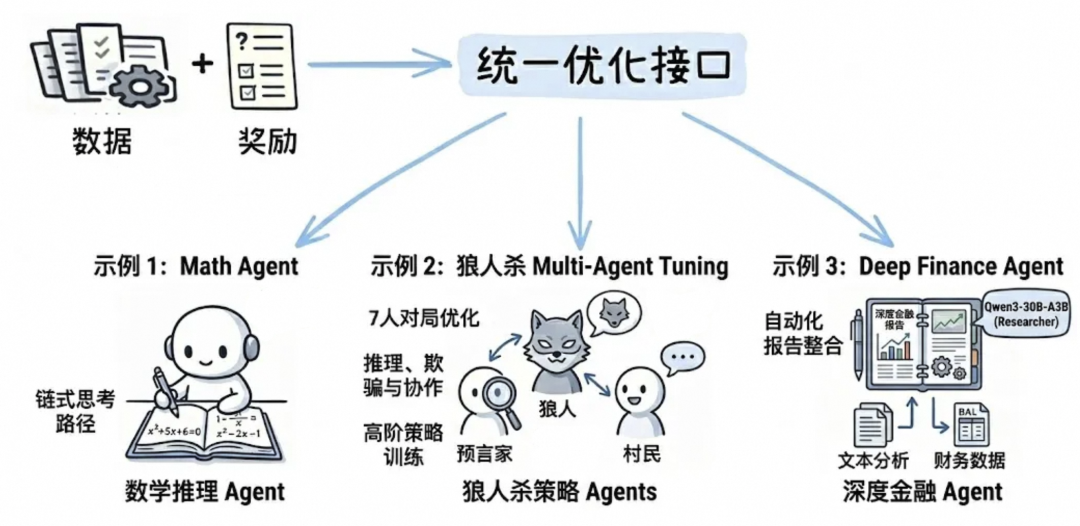
Tuner 是这一轮更新里最关键的一块拼图。它把 Agent 优化拆成三种能力——Prompt Tuning、Model Selection、RFT(强化微调)——并共用一套 tune_prompt / tune 风格的 API 和同一个 workflow / judge_func 抽象,用户不用学三套概念,也不用导出数据再切换框架。
这件事同行早就在做,但路径不一样。Stanford 的 DSPy 在 Prompt 层做得最深,MIPROv2 用贝叶斯优化同时搜索指令和 few-shot 示例;微软的 Agent Lightning 则把 RL 训练和 agent 执行完全解耦,主打「任何框架写的 Agent 都能零改动接进来训练」;LangChain 的 LangSmith 主要做 trace、eval 和 prompt 版本管理,不负责训练闭环。Tuner 的差异点在于:它是 AgentScope 亲儿子,Prompt 优化、模型选型、RFT 共享同一个工作流定义,训练指标和上线效果能直接对齐,这是 AgentScope Tuner 拿出来和上面几个通用方案竞争的核心理由。
底层分工也比较清楚。Prompt Tuning 这一层 Tuner 沿用了和 DSPy MIPROv2 同源的算法思路(素材里明确点名 MIPROv2),Model Selection 是内部自评测模块,RFT 则是调用同一组织开源的 Trinity-RFT——后者是一个通用 RL 微调框架,按 Explorer(产生轨迹)、Trainer(更新权重)、Buffer(经验管理)三段式解耦,支持 GRPO、Multi-Step GRPO、CHORD 等多种算法,并且能直接训练 AgentScope 写的 ReAct Agent。
三组场景跑出来的数据:从数学 Agent 到金融研究 Agent
判断一个调优框架够不够硬,看 Benchmark 比看架构图更直接。官方放出了三组真实场景的完整对比。
Math Agent:Prompt Tuning + Model Selection + RFT 三层叠加。 起点是一个处理小学到初中应用题的 ReAct Agent,初始 Prompt 只有一句「You are an agent. Please solve the math problem given to you.」。第一步用 tune_prompt 接口在 Qwen-Plus 上自动搜索,优化出的新 Prompt 明确拆成三步——先推理读题识别变量、再写整数运算的 Python 代码、最后用 \boxed{answer} 格式输出并自检,结构化程度显著提升。第二步做 Model Selection,跑完评测后系统把基座从 Qwen-Max 换成 Qwen-Turbo,准确率保持高位的同时,平均每次推理省下约 20.6% 的 token。第三步放上 RFT 深度微调,经过 Multi-Step GRPO 训练后的 Qwen3-0.6B 小模型准确率提升约 10%,达到和闭源商业模型同一水平。
狼人杀:多智能体博弈的 RL 训练。 这是个信息不完全的对抗场景,Agent 要扮演狼人、村民、预言家、女巫四种角色,涉及夜间协商、白天发言、投票。训练设置有两路:狼人阵营用 Qwen2.5-7B-Instruct 作为可训练模型对抗 Qwen3-30B-A3B-Instruct,奖励函数是「狼人胜 +1.0 / 村民胜 0.0 / 执行错误 -0.1」;好人阵营则用 Qwen3-4B-Instruct 训练预言家、女巫、村民三类角色。训练前狼人经常随机行动、直接自我暴露,训练后收敛到「潜伏伪装、牺牲队友换信任」的高级欺骗策略;好人三角色也分别学到了身份隐藏、药水规划、协作分析等专项能力。最值得看的是 4B 小模型经 RL 训练后能稳定对抗 30B 强模型——参数量差了近 8 倍,靠 RFT 补了回来。
DeepFinance:企业级金融研究 Agent。 这个任务最接近真实业务:Agent 要自主调用 19 个 MCP 协议金融工具(上市公司财报、股东结构、行业对比、股价计算等),做多源数据交叉验证,最后输出完整金融研究报告。评测接入 OpenJudge,从充分性、规范性、真实性、客观性、表达质量五维度打分。在 DeepResearch Bench 的 Finance 子集上,训练后的 Qwen3-30B-A3B ReAct Agent 报告评分从 18.4 提升到 47.9,数据真实性单项提升 8.0%,整体表现和参数量更大的 Claude 3.7 闭源商业模型持平。 把这三组场景横着看:Prompt Tuning 最便宜最快,Model Selection 主要解决成本问题,RFT 是真正能打破天花板的那一层。这也对应了 DSPy 单独用 MIPROv2 能解决的问题范围——到了狼人杀和 DeepFinance 这种复杂工具链,光调 Prompt 已经动不了了,必须动到模型参数层面。
Prompt Tuning、Model Selection、RFT:三层优化是怎么串起来的
技术栈这一层,Tuner 的三个模块各自对标不同的外部生态。
第一层 Prompt Tuning,算法上和 DSPy 的 MIPROv2 同源——通过贝叶斯优化在「指令候选 × few-shot 示例」的组合空间里搜索,每一轮用小批量验证集评估,最后在完整验证集上挑最优程序返回。它和 DSPy 的差别主要在集成度:DSPy 要求把 Agent 改写成 Signature + Module 的 DSPy 程序,而 Tuner 直接接收原生 AgentScope 的 workflow 函数,改动几行代码就能启动优化。对于已经在 AgentScope 里写好 ReAct Agent 的团队,这个迁移成本差距就是关键决策点。
第二层 Model Selection,按准确率、响应速度、Token 消耗等多维权重给候选模型自动评测,输出性价比最优的组合。这层能力在 DSPy 和 Agent Lightning 里基本是缺位的——这两个框架都假设模型是外生的,要换模型得人工改配置重跑一轮。Tuner 把模型评测封装成和 Prompt Tuning 一样的接口,意义在于:当你 95% 的请求其实用不上 Qwen-Max 或 GPT-4 这种顶级模型时,Model Selection 能把账真的算出来。
第三层 RFT,底层跑的是 Trinity-RFT,这也是 AgentScope 同门出品的开源 RL 微调框架。Trinity-RFT 的架构类似微软的 Agent Lightning——都是把 agent 执行(Explorer)和训练(Trainer)解耦,通过 Buffer 传递经验数据,避免把训练流程和 agent 代码绑死。区别在于 Agent Lightning 强调跨框架兼容(LangChain、OpenAI Agents SDK、AutoGen 都能接),Trinity-RFT 则专注打磨和 AgentScope 的原生配合,支持 Multi-Step GRPO、CHORD 等最新算法,能训练真正的多轮工具调用轨迹而不是拼接式 prompt。对中文生态里大量已经在用 Qwen 和 AgentScope 的团队来说,后者的工程连贯性更重要。
三层能力之间的接口设计是关键。Tuner 要求用户用同样的 workflow 函数(定义 Agent 交互逻辑)+ judge_func(定义评分)+ dataset 三件套描述任务,这三件套在 Prompt Tuning、Model Selection、RFT 三层里复用同一份定义,不用为不同优化阶段写不同的数据适配层。这也是 Tuner 比 LangSmith 之类只做 trace + eval 的工具多走的一步——LangSmith 能告诉你 Agent 哪里错了,但改不动它;Tuner 则把评测闭环直接对接到优化算法。
Agent 研发生命周期的阶梯式选型路径
三层能力不是让人同时全部用上。官方给出的路径是按研发阶段分的,落到实际团队决策上大致是这样:
项目早期——先跑 Prompt Tuning。 门槛最低,不用 GPU,不需要大量训练数据,几十到几百条验证样本就能启动。适合场景是「Agent 基础能力到位,但在特定任务上差一口气」——比如工具调用参数描述不精准、规划步骤表述不清晰、输出格式不稳定。从 Math Agent 那个例子看,单单一轮 Prompt Tuning 就把角色定位、解题步骤、输出规范全都结构化了,这种收益在很多场景里已经够用。
项目中期——跑 Model Selection 算成本账。 当 Prompt 层已经调得不错,接下来值得做的是用小模型替换大模型。Qwen-Turbo 省 20.6% token 的数据在长期运行中就是真金白银,尤其对日请求量上万的 Agent 服务更明显。如果产品还在早期、请求量不大,这一步可以先跳过。
项目后期——到 RFT。 只有在 Prompt Tuning 和 Model Selection 都摸到天花板,并且任务复杂到只有模型参数层面才能解决时,RFT 才值得投入。典型信号是:工具链长(像 DeepFinance 那样调用十几个 MCP 工具)、规划步骤多、多智能体协作、任务完成率卡在某个百分比上不去。这一层需要 GPU 集群、需要轨迹数据、需要设计合理的奖励函数,投入比前两层高一个数量级,回报也是最大的——狼人杀里 4B 打 30B、DeepFinance 里 Qwen3-30B-A3B 追平 Claude 3.7,都出现在这一层。
如果你团队刚开始选型,又不确定到底要哪一层,合理的起点是:Prompt Tuning 先跑一轮看看能拿回多少分,再决定要不要往下一层推。跳过前两层直接上 RFT 是很多团队踩过的坑——很多时候问题只是 Prompt 写得不够结构化,根本轮不到调模型。
上手之前,要先算清楚的几个风险
Tuner 的三层能力并不是零风险的工具,落地之前有几件事要提前想好。
训练数据质量是 RFT 的最大变量。 狼人杀和 DeepFinance 的成绩好看,但这俩场景的评测标准都做了不少工程——狼人杀的奖励设计本身就是一个小研究课题,DeepFinance 接的是五维 OpenJudge 评分器。如果你的业务场景还没有能打的评测集和奖励函数,RFT 训出来的模型可能比 Prompt Tuning 的版本还糟,因为它会拟合到错的指标上。
计算成本不是线性的。 Prompt Tuning 跑一轮用 GPT-4 或 Qwen-Max 做 prompt_model,成本从几美元到几十美元不等(DSPy 官方文档的典型范围);Model Selection 的候选模型评测也要花 API 费用;到了 RFT,Trinity-RFT 建议的配置已经是 Ray 集群级的多 GPU 环境,训练一个 Qwen3-30B-A3B 的开销和周期都不是一张 H100 能搞定的。小团队想试 RFT,从 0.6B / 4B 小模型起步更现实。
过拟合单一业务场景。 Tuner 的三层优化目标都是你给的 judge_func,它会忠实地优化这个指标。问题在于 Agent 上线后遇到的真实用户请求分布往往比训练集更多样,一个在训练集上 95% 准确率的 Agent,在真实场景可能只有 70%。官方案例里狼人杀和 DeepFinance 都做了跨阵营、跨话题的多样化评测,自家团队上手时也需要预留一部分独立测试集做泛化验证,不能光看训练指标。
评测信号的可靠性。 LLM-as-a-Judge 已经是业界常规操作,Tuner 的 judge_func 也多半会用大模型当裁判。这里的坑是裁判模型本身可能比被评测的 Agent 还弱——尤其是 RFT 训练到后期,Agent 可能「学会」讨好裁判而不是真正变好。DeepFinance 用了五维正交评分器就是为了降低这种风险,但对普通团队来说,至少需要人工抽检一定比例的训练轨迹。
和已有技术栈的耦合度。 Tuner 最大价值来自和 AgentScope 工作流的无缝衔接。如果你的 Agent 是用 LangChain、LangGraph 或 CrewAI 写的,要切到 Tuner 就涉及框架迁移。这种情况下,微软的 Agent Lightning 可能是更好的选择——它主打「任何框架写的 Agent 零改动接入 RL 训练」,是目前在跨框架兼容这条路径上走得最远的方案。
 AI 速览