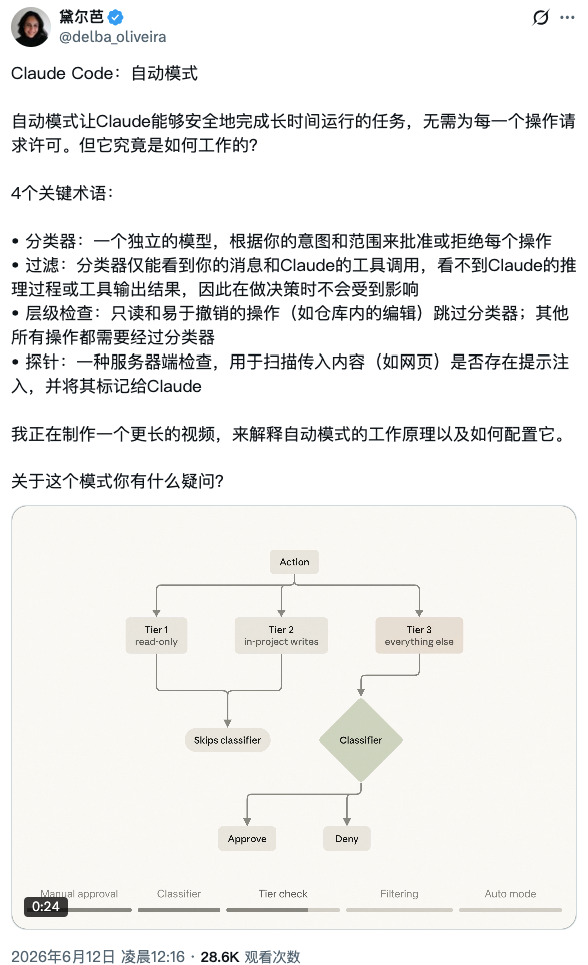
Anthropic 推出 Claude Code Auto mode,让 AI 安全自主完成多步任务,无需每次操作手动批准——不是简单的「跳过权限」核心安全架构四层:分类器(独立模型裁决操作是否合规)、过滤(分类器只看指令和动作,不看推理过程)、层级检查(低风险操作免审)、探测器(服务端扫描网页防止提示注入)。 分类器每次裁决都引用完整对话历史而非仅当前消息,你说过的约束(如「先别推」)会一直生效直到你明确解除。你的自定义安全规则(Deny/Allow hooks、Sandbox)优先级高于分类器——先跑你的硬规则,分类器只处理剩余部分。
开启方法:claude --enable-auto-mode 或在应用内按 Shift + Tab 切换。配置后可用 claude auto-mode critique 验证规则 从「每步批准」到「信任但不盲信」
用过 AI 编程工具的开发者都遇到过这个两难:每步手动批准,打断了流畅感;全部跳过权限(--dangerously-skip-permissions),又像在悬崖边走路。
2026 年 3 月,Anthropic 在 Claude Code 中推出了 Auto mode(自动模式),试图解决这个矛盾。它不是简单的「不让问」,而是一套精心设计的安全机制——让 AI 自主行动,但始终在可控范围内。 一位用户在社区分享了自己的对比数据:
一个涉及 12 个文件的重构任务,手动审批模式跑完要 47 分钟;切换到 Auto mode,11 分钟完成。而且分类器在过程中拦截了一次有风险的删除操作——他说,「如果是我自己审批,可能就随手批准了」。
这不是个例。Claude Code 的开发者之一 _catwu
透露,团队内部几乎所有人都把 Auto mode 作为日常默认模式。社区里甚至有用户说:「没有 Auto mode,你只用了 Claude Code 20% 的能力。」 四层安全机制:
Auto mode 的安全设计像一座金字塔,从底层到顶层层层筛选:
层级检查(Tier Check)——第一道关卡
不是所有操作都需要经过分类器裁决。低风险操作直接跳过:
免审操作:只读操作(查看文件)、仓库内编辑、文件修改——这些容易撤销的动作直接放行
需审操作:外部 API 调用、文件删除、权限修改、超出项目范围的写入——这些才走分类器
这套分级和 Git 的 staged/unstaged 逻辑类似:改动本地的 README 不需要审核,但执行 DROP TABLE 就需要。
过滤(Filtering)——防止 AI「说服」安全层
这是整个设计中最巧妙的一层。分类器能看到的信息非常有限:
能看到:你的消息、Claude 准备执行的工具调用
看不到:Claude 的推理过程、思考链、工具的执行结果
为什么这样设计?因为如果分类器看到 Claude 的推理过程,Claude 可以用「巧妙的话术」说服分类器批准一个危险操作。通过信息隔离,分类器只能基于「用户说了什么」和「Claude 想做什么」这两样东西做判断——干净,直接,无法被操控。
分类器(Classifier)——核心裁决者
分类器是一个完全独立的模型(不是运行 Claude Code 的那个模型),它的唯一职责就是判断每个操作是否合规。
它的判断依据有三样东西:
- 你说过的每一句话(包括像「先别推」「只在这个仓库内」这类约束)
关键的逻辑是:意图不是在一开始就定死的,而是随着对话不断更新。你在第 10 步说了一句「千万别动生产数据库」,分类器会记住,一直到第 50 步仍然有效。只有你明确说「现在可以推了」的时候,那个约束才解除。
探测器(Probe)——外部威胁扫描
当 Claude 需要浏览外部网页(比如读取某个 API 文档)时,探测器会在服务端扫描页面内容,检测是否存在提示注入(Prompt Injection)攻击。一旦发现恶意内容,它会标记给 Claude,而不是直接阻断。
这一层的作用类似于浏览器的 XSS 过滤器——你在页面上看不到它工作,但它一直在保卫你。
如何开启和配置 Auto mode
开启非常简单,有两种方式:
方式一:命令行
或
方式二:应用内
在 Claude Code 界面中按 Shift + Tab,切换到 Auto mode。
目前该功能在 Pro 套餐上可用(2026 年 5 月从 Team/Max 下放),支持的模型包括 Sonnet 4.6+ 和 Opus。
配置你的安全边界
Auto mode 的核心在于让分类器理解你的工作环境。推荐的配置流程:
了解分类器默认认为「安全」的操作范围。
- 定义你的环境
帮分类器建立你的工作环境画像:哪些仓库是安全的、哪些内部域名可以访问、使用了哪些云服务。最关键的是明确列出禁止事项——比如「不操作生产数据库」「不执行收费 API」「不删除 /temp 之外的文件」。
critique 命令非常实用——它能帮你发现那些「好像说了但又没说清楚」的规则,避免因为规则模糊导致误放行或误拦截。
- 在项目根目录创建 CLAUDE.md
写入长期有效的约束和编码规范,这些会注入每次对话的上下文中。
子代理场景:意图如何传递
当 Claude Code 把一个复杂任务拆成多个并行子代理(Subagents)时,分类器会怎么处理?
Delba 在评论区回答了这个问题:
如果子代理收到的指令已经偏离了你的原始目标,它在启动前就会被拦截
每个子代理的每个操作都走统一分类器规则,不因为是「子代理」就降低标准
当子代理返回结果时,分类器会回顾整个子代理的操作历史,标记可疑行为
这意味着你不用担心子代理「玩脱了」——安全模型是统一的,不是层层外包的。
拒绝之后发生什么
当分类器拒绝一个操作,Claude 不会直接退出罢工。它做了两件事:
- 尝试替代路径——比如分类器拒绝了「直接删除文件」,Claude 可能会尝试「先移动到临时目录」
- 多次拒绝后主动退出——如果连续被拒,Auto mode 会退出并提示你手动接管
这种设计避免了「一次拒绝就全盘失败」的极端情况,同时防止在错误方向上持续消耗算力。
真实用户反馈:效果和边界
正面体验
除了前面提到的 47 到 11 分钟案例,社区中还出现了大量类似反馈。有用户说 Auto mode 让他能「连续数小时将高度复杂的计划交给 Claude 执行,中间不需要停下操作」。多会话并行(社区称之为 "multi-clauding")被认为是最能提升生产力的工作流——启动一个 Auto mode 会话在后台运行,同时开另一个会话做别的事。
需要注意的地方
开发者 Gregor 分享了一个真实教训:在 Supabase 迁移任务中,Auto mode 在第 20 步批准了未在初始范围内明确指定的表结构修改。虽然分类器每次都会引用完整对话历史,但在迁移这类高风险操作面前,Delba 的建议很直接:关闭 Auto mode,手动审核。
换句话说,Auto mode 不是银弹。你需要知道什么时候信任它(日常开发、重构、调试),什么时候自己把关(数据库迁移、生产部署、财务相关操作)。
整体社区评价
安全设计:比 --dangerously-skip-permissions 安全很多,四层机制逻辑自洽
使用体验:大幅减少交互打断,融入心流
配置门槛:需要初始设定环境和禁止规则,但一次配好长期受益
适用场景:日常开发首选;迁移和敏感操作建议手动
同类对比:目前同类工具中最成熟的自主安全方案
使用 Auto mode 的最佳实践
基于社区经验,总结几条实用建议:
- 一开始就把边界说清楚。不要指望分类器猜你的意图。在第一条消息中就写明:「只在这个仓库内工作。不碰生产数据库。不执行部署。不删除 /temp 之外的文件。」
- 用 CLAUDE.md 锁定长期规则。项目根目录的 CLAUDE.md 文件会注入每次对话,适合写编码规范、架构偏好、安全约束。
- 先保守,后放开。刚开始用 Auto mode 时,设定较窄的范围;随着对分类器行为的了解,逐步扩大授权。
- 迁移和部署操作保持手动。这些场景中的隐性范围扩展很难被分类器完全预测,手动审批是保险的选择。
- 善用 multi-clauding。一个 Auto mode 会话处理后台任务(比如大规模重构),另一个会话做手动设计和代码审查,效率翻倍。
 AI 速览