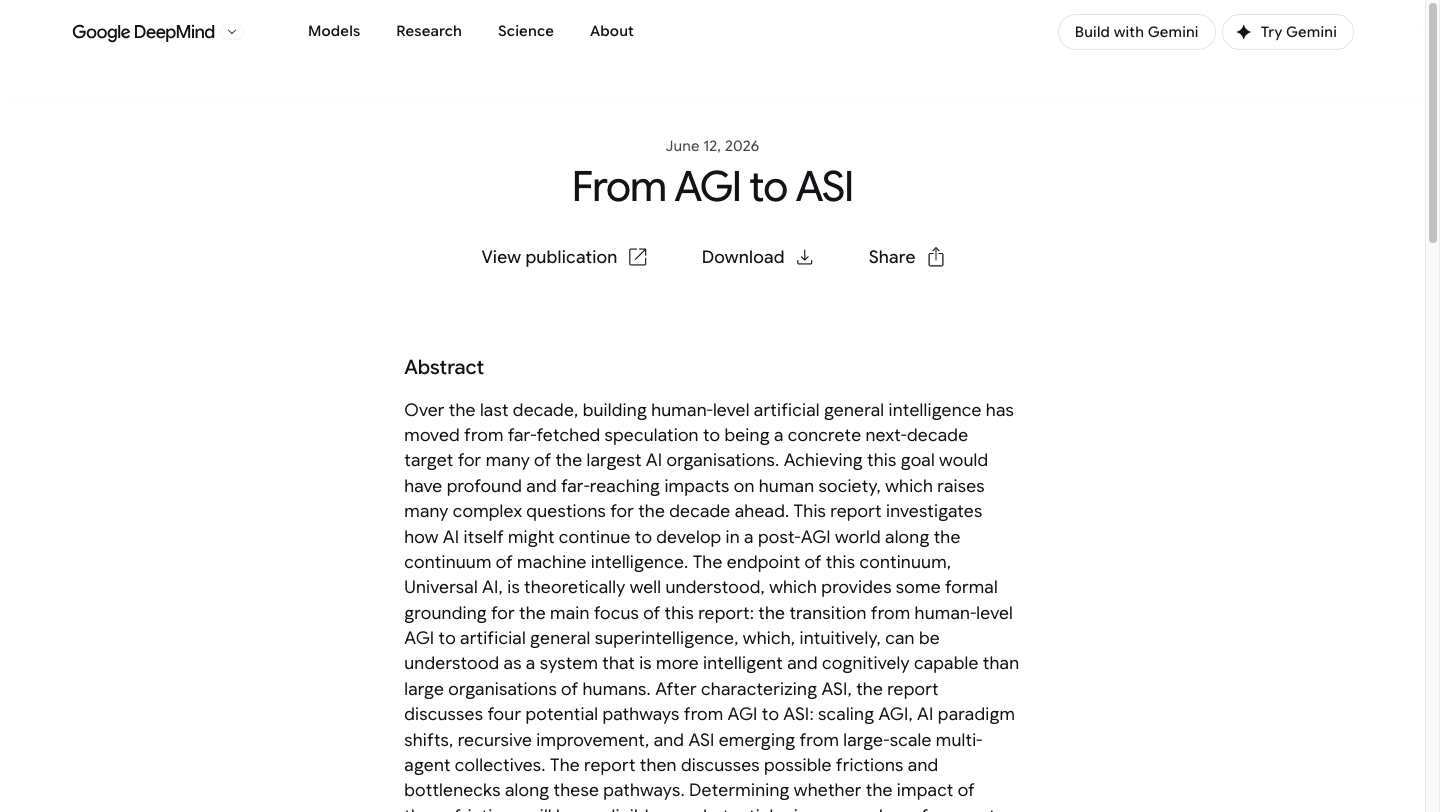
- Google DeepMind 14位作者(含Shane Legg、Marcus Hutter等核心成员)于2026年6月10日发布57页报告《From AGI to ASI》,系统性分析AGI之后的人工智能演进
- 报告将ASI定义为「超越大型人类专家集体」的系统,门槛显著高于普通"超人类智能",排除单一领域超人的狭义AI
- 提出四条从AGI通往ASI的路径:持续缩放、算法范式转变、递归自我改进、多智能体集体智能,且四者不互斥
- 数字智能拥有生物智能无法比拟的六大优势:完美复制、瞬时部署、加速运行、即时知识共享、大规模并行与I/O带宽独立
- 识别六大潜在瓶颈:数据墙、经济与资源约束、神经范式局限、研究难度递增、抽象屏障、人为放缓
- 报告末尾列出37项开放研究课题,覆盖瓶颈验证、量化预测、ASI基准测试、递归改进动力学、多智能体缩放与ASI理论基础
一句话说清楚:这论文在解决什么问题
想象一下:某天人类真正造出了通用人工智能——一个能在大多数认知任务上达到普通人水平的系统。然后呢?AGI是终点吗?
过去两年的讨论大多集中在"什么时候AGI会来"以及"AGI会带来什么后果"上,很少有人系统性地思考:AGI之后的AI会往什么方向走?通往真正超级智能的路有几条?每条路上又有哪些可能卡住我们的瓶颈?
DeepMind这篇报告就是来填这个空白的。它不纠结于AGI何时到来(作者称之为"不依赖这个里程碑的时间"),而是把AGI当作一个起点,画出从AGI到ASI(Artificial General Superintelligence)的全景地图。报告由Tim Genewein、Shane Legg、Marcus Hutter等14位DeepMind研究人员联合撰写,融合了机器学习、博弈论、经济学、复杂系统理论等多个学科视角。
论文对ASI的定义比常见的"超人智能"要高得多——它不只是比单个人类聪明,而是能超越数万名专家组成的大型集体,在几乎所有人类活动领域上都做得更好。这个门槛排除了类似AlphaFold那种"在单一领域超神但其他领域不行"的狭义超智能。
核心方法:DeepMind如何拆解超级智能的路径
数字智能的底层优势
报告花了不少篇幅来讨论一个被很多人忽视的前提:数字智能与生物智能之间存在本质差异,而且这些差异会随着算力增长而不断放大。
数字智能可以完美复制——把整个AI的状态包括"一生经验"完整克隆到新实例上,人类做不到。它可以加速运行或暂停任意时长,而人类的思考速度受制于生物学上限。知识可以瞬时共享,每个新实例不用从头学起。大规模并行不睡觉、不受生物学疲劳限制。
这些优势不是静态的——随着有效算力每年约10倍的增长,数字智能相对于人类的优势差距会越来越大。哪怕单个AGI只达到人类水平,当你可以运行数百万个这样的人类水平AGI副本而且每个都比人快10倍时,量变就可能引发质变。
四条通往ASI的技术路径
路径一:持续缩放(Scaling AGI)
最直观的路径——把今天的方向推到极致。更大模型、更多数据、更多推理计算。即便单个模型在某个点遭遇收益递减,但想象一下:数百万个人类水平的AGI并行工作,每个运行速度比人快数十倍,24×7不停歇。"你不能说几百万个超人水平的智能体并行运行还不算质变。"报告认为这条路径的核心问题不是"缩放是否够用",而是"经济、能源和资源能否支持这种量级的持续投入"。
最大的潜在摩擦是数据墙——高质量人类文本预计在本十年内耗尽。但报告指出,AGI级模型可能通过高保真仿真、搜索增强蒸馏和交互环境自行产生高质量训练数据,打破这一瓶颈。
路径二:算法范式转变(Algorithmic Paradigm Shifts)
当前范式(大规模预训练Transformer + 后训练微调 + 测试时缩放)被广泛认为不足以达到人类级AGI,更不用说ASI。社区正在积极补充缺失组件:接近无限的上下文窗口、持续学习能力、稳健的交互决策能力。
更深层的范式转变可能包括:彻底的新架构或优化方法、脉冲神经网络与神经形态硬件、模拟计算、基于强化学习的预训练、显式世界模型表示。这些转变往往是遇到天花板后的产物,因此本质上无法预测——但报告强调"不能因为不可预测就忽视这个方向"。
其中一个重要的局部趋势是测试时缩放的兴起:能力增长不再只靠模型规模,推理计算成了正交的扩展维度。一个AGI系统可以调用代码解释器、仿真环境、搜索引擎等外部工具来解决需要超人精度的子任务。
路径三:递归自我改进(Recursive Self-Improvement)
这是最可能引发"爆炸性"转变的路径。AI辅助或自主进行AI研发,改进后的AI系统又能更好地加速研发,形成正反馈循环。
报告识别了三种递归改进形式:
- 数据型改进:AI通过仿真、自我对弈、测试时搜索生成更高质量的训练数据(类似AlphaZero将推理改进蒸馏回模型的循环)
- 硬件型改进:AI设计更快的芯片、更优的制造工艺和更高效的供应链
真正自主的递归改进可能导致超指数增长,但即使是非自主的形式(如AI辅助编写研究代码、超参数优化、神经架构搜索)已经在大规模使用。报告诚实指出:递归改进可能在初期就快速衰减——保持改进循环所需的经济投入同样会指数级增长。
路径四:多智能体协调与集体智能(Multi-Agent Coordination)
这是四条路径中最容易被低估的一条。超级智能可能不来自于一个"全能模型",而是来自于大量专门智能体的协调与合作。
想象一个完全自动化的AI公司:数千个专业AGI分别负责市场分析、研发、运营、财务,通过类似于人类市场的机制(价格信号、任务拍卖)进行协调,其整体认知能力超越了任何单个智能体。这种架构的灵感来自于人类社会的分工协作——人类的集体智能(大型研究机构、跨国公司)远高于任何个人的认知上限。
数字智能体之间可以以极高的带宽通信(不像人类受限于有限的语言表达),这意味着更高效的分工和协调。报告甚至提出了"多智能体缩放定律"的猜想:群体智能如何随着智能体数量增长而扩展?是否存在超线性增长的区域?
成绩单:六大可能卡住超级智能的瓶颈
报告最受社区好评的部分之一是其对瓶颈的系统性分析。这些瓶颈不是"AI会毁灭人类"式的警告,而是具体的、可研究的技术和经济问题:
| | |
|---|
| | |
| 投资、芯片供应链、能源—即使能持续缩放,经济账算得过来吗 | AI产生的经济回报反哺、效率提升、大规模基础设施扩建 |
| 预训练Transformer+SGD范式是否本身就存在天花板 | 范式内演化(更长的上下文、持续学习、工具使用)和范式外突破 |
| | |
| 模型训练于人类抽象之上,是否因此受限于人类概念框架 | 缩放和集体智能可能从外围突破;RL和交互学习可能是破局方向 |
| 恶意使用、事故、安全顾虑、社会反弹可能导致监管刹车 | 经济和赛道竞争压力可能压过放缓压力,缺乏全球协调是核心问题 |
其中"抽象屏障"引发了最多的社区讨论。报告做了一个思想实验:如果一个AI只接受了1700年以前的人类科学知识训练,它能否独立推导出广义相对论?这触及了一个核心问题——当前的大模型本质上是"人类知识的压缩器",擅长掌握已有的概念框架,但能否真正突破这个框架创造全新的概念?报告没有给出定论,而是将这个问题列为最重要的开放研究课题之一。
意义与局限
为什么这篇论文重要。《From AGI to ASI》是主要AI实验室首次公开发布的对AGI之后的技术路线的系统性分析。它把讨论从"AGI什么时候来"推进到了"AGI来了之后会怎样",并且用具体的技术路径和可验证的瓶颈替代了空泛的超级智能想象。37项开放研究课题构成了一个实质性的研究议程——如果你想知道该研究什么才能理解(甚至影响)这个领域的走向,这里有直接的线索。
报告中的数字智能优势分析也有深远的政策含义:如果数字智能与生物智能之间的差距确实随算力增长而放大,那么监管和治理框架需要考虑的不只是AI能力本身,还包括这些结构性的不对称性。
局限与未解决的问题。 报告承认四条路径和六大瓶颈的清单很可能不完整。对于最关键的变量——递归改进的速度、抽象屏障是否真实存在、经济回报能否支撑超大规模投入——没有人知道答案。此外,报告侧重于技术路径,对治理、政治经济学和多智能体系统的设计原则讨论相对较少——部分X上的评论指出"谁来设计群体智能体的协调规则,可能和智能体本身的智能水平同样重要"。作者也直言,ASI领域的许多问题可能现在看起来"不切实际",但找到答案也需要相当长的时间。
作者、资源与下一步
这份报告来自Google DeepMind的核心研究团队,作者涵盖了从理论基础(Marcus Hutter的AIXI框架被视为智能上限的理论基准)、安全对齐(Iason Gabriel)、多智能体系统(Joel Z. Leibo)到实际工程(Shane Legg作为DeepMind联合创始人,也是最早正式提出AGI概念的人之一)的完整光谱。Stephanie Chan在X上发布报告时强调,这是DeepMind关于AGI定义、安全与未来发展的系列工作的一部分。
- AlphaXiv讨论:社区在AlphaXiv上已有结构化摘要和层次化讨论
对于开发者与研究者而言,最直接的行动点是从37项开放研究课题中挑选一条入手。具体来说,量化预测(课题2)和Benchmarking ASI(课题3)是近期可以取得实质进展的方向——特别是设计不饱和于人类专家水平的评测方法(如零和博弈竞争基准或设置-求解器方法)。
 AI 速览