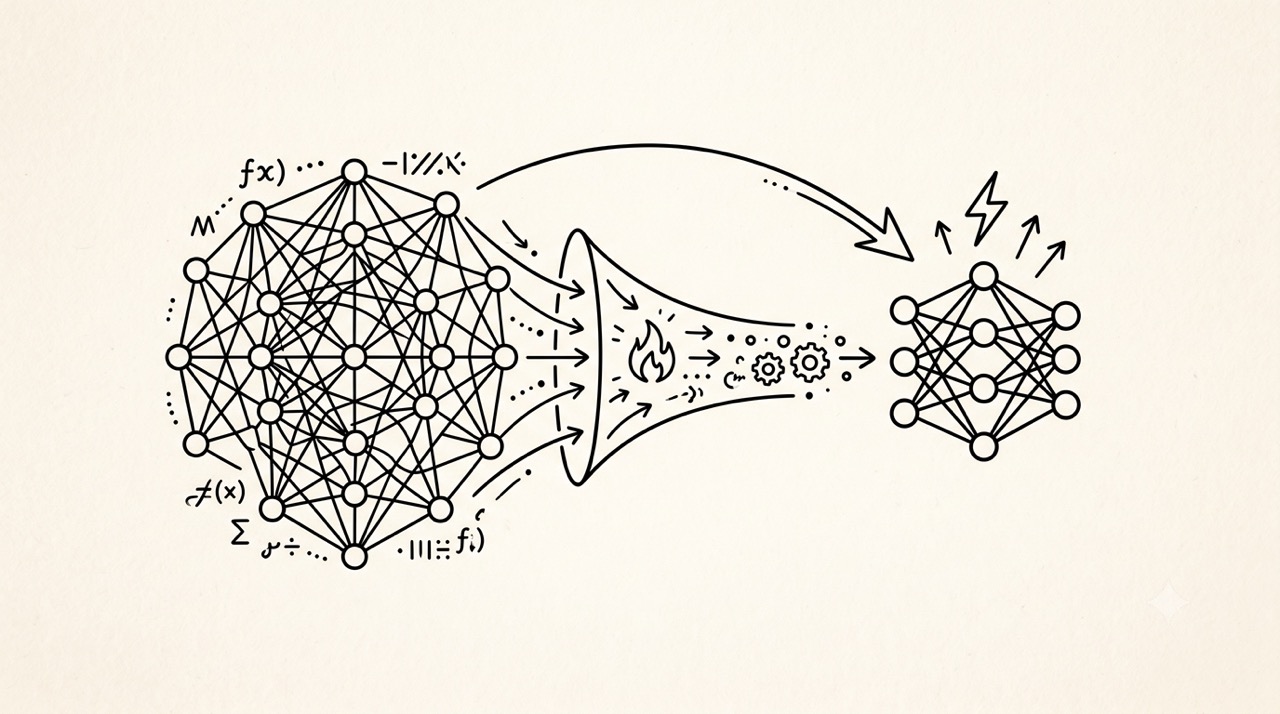
大模型越来越强,但也越来越贵。OpenAI 的 o1、DeepSeek 的 R1,能力令人惊叹,可每次调用都要烧掉一大笔算力成本。有没有办法让一个小模型学会大模型的本事,跑得快、还便宜? 答案就是模型蒸馏。
在最近一期 Latent Space 播客中,Google DeepMind 的研究科学家 Feryal Behbahani 花了近一个小时,把蒸馏这件事讲透了。这篇文章帮你消化所有关键信息。
什么是蒸馏?师傅带徒弟
蒸馏的本质就一句话:把大模型的知识,转移给小模型。
想象你有个金牌大厨师傅(大模型),什么菜都会做,但让他每餐都亲自下厨,成本太高。你希望培养一个徒弟(小模型),学会师傅的手艺,以后日常做菜就交给徒弟。
2015 年,Hinton 提出了经典的蒸馏方法:让徒弟模仿师傅的"思考概率"——不仅是学"这个菜放多少盐",还要学师傅在每种可能性上的判断权重。
为什么模型圈都在讨论蒸馏
三个现实原因:
成本 vs 性能
播客主持人画了一张图:横轴是成本,纵轴是能力。大模型在右上角(能力高但贵),小模型在左下角(便宜但差一点)。蒸馏的目标就是把这条曲线的斜率变缓——让同一水平的能力,可以用更低的成本实现。
通俗说:Llama 405B、GPT-4.5 很强,但你不一定用得起。你天天用的 Sonnet、GPT-4o mini 背后,很可能就有蒸馏的影子。
Feryal 一句话点透:"你蒸馏一次模型,但可以服务它十亿次。"
端侧部署
手机里装不下几千亿参数的模型。蒸馏可以把模型瘦身到能装进手机、还能实时响应的尺寸。
暗知识效应——最反直觉的一点
这可能是蒸馏最神奇的地方:直接训练一个小模型,不如先训练一个大模型,再蒸馏成小模型。 后者效果反而更好。
为什么?Hinton 管这叫暗知识(Dark Knowledge)。大模型在学习数据时,不仅记住了正确答案,还学会了所有"可能的答案"和它们的相对概率——这些信息在人类标注数据里是看不到的。徒弟从师傅那里学到的信息量,比从原始数据直接学更丰富。
网上关于"为什么蒸馏有效"的讨论帖有几百条回复,至今没有一个公认的完整解释,但这个现象已经被反复验证。
蒸馏的四种主流方法
方法一:合成数据蒸馏(最简单,最常用)
给大模型一些提示词,让它生成答案,然后用这些答案去微调小模型。
优点:只需要 API 调用就够,不需要访问大模型内部的参数或概率分布。DeepSeek R1 从 671B 的 MoE 模型蒸馏到 1.5B、7B、14B、32B、70B 等不同尺寸,就是用这个方法——甚至连 tokenizer 不同都不影响,因为蒸馏的是文本输出而非 logits。
方法二:Logit 匹配蒸馏(信息量最大)
让老师输出所有词的概率分布(不只是选一个答案),学生去匹配这个分布。本质上就是把 next token prediction 的"硬标签"(0 或 1)换成"软标签"(每个词的概率值),损失函数一模一样。
优点:信息更丰富,学生能学到老师对每个候选词的"犹豫和倾向"。但需要访问模型内部的 logits——只有开源模型才做得到。
方法三:最佳 N 选一(Best-of-N)
让模型生成多个答案,挑出最好的那个来训练。
这个思路下有个反直觉的发现:用小模型生成大量数据并筛选,效果可能超过用大模型生成少量数据。
Google 的实验数据很震撼:
- Compute-matched:用 9B 模型生成大量数据去训练 27B,效果反而超过用 27B 自产数据训练自己
- Price-matched:Gemini Flash(便宜 35 倍)生成 35 倍的数据再筛选,效果超过用 Gemini Pro 直接生成
道理很简单:数量优势可以弥补质量差距。再加上过滤机制(比如数学题只看正确答案,编程题只看通过测试用例的),数据量的杠杆效应非常可观。
对于推理类任务(数学、编程),"更多数据 + 过滤"的组合拳往往比"少量高质数据"更有效。
方法四:在线蒸馏(On-Policy Distillation)——最前沿
以上三种方法都是"离线"的——数据提前准备好,固定不变。但这里有个关键问题:训练和推理时的状态不一致。
这个现象在学术界叫 Exposure Bias(暴露偏差)。
想象学开车。离线蒸馏就像教练给你一本驾驶手册,上面全是标准操作。但真上路后你方向盘打偏了,手册里可没写怎么救回来——教练从来不会故意开到沟里去,所以训练数据里根本不会有这些"犯错后如何补救"的样例。
在线蒸馏的做法是:让学生自己开车,老师在旁边实时纠偏。
具体流程:
- 老师给出"如果是我,我会怎么做"——即老师在这个序列上每个位置的 logits
这里的核心变化是:采样的数据来自学生自己,这意味着训练时看到的状态分布和推理时是一致的。即使学生走偏了,老师也能给出"偏了,你应该这样拐"的纠正——而不是像离线蒸馏那样,学生只见过"永远不会偏"的理想数据。
漂亮的数学推导
你可能会觉得这只是一个工程技巧。实际上它有严格的数学基础:把 KL 散度的方向反过来就得到了在线蒸馏的损失函数。
传统离线蒸馏:最小化 KL(老师 || 学生) —— 让学生覆盖老师的整个分布(mode covering) 在线蒸馏:最小化 KL(学生 || 老师) —— 让学生专注拟合老师最优的模式(mode seeking)
这两个方向的差异直接决定了学生的行为。
三步实现:你不需要新框架
在线蒸馏听起来复杂,但 Feryal 提供了一个极其简单的实现思路:
- 打开你现有的 RLHF / RL 训练框架(比如 TRL、Axolotl)
就这样。你已有的 RL 基础设施,删几行代码就是在线蒸馏。HuggingFace 等社区已经有人这样做过。
如果你想更进一步,也可以不关 reward——把 reward maximization 和 KL distillation 同时做,训练一个既对齐又跟老师走得近的学生。
KL 散度方向:Mode Covering 还是 Mode Seeking?
这是一个常被忽略但很重要的技术细节。前面提到传统蒸馏和在线蒸馏用了不同方向的 KL 散度,它们的行为差异非常明显:
Mode Covering
KL(老师 || 学生) — 标准蒸馏用的方向。学生试图覆盖老师在整个分布上的所有概率质量。结果是学生可能会在老师根本不会采样的区域也分配概率——它试图"覆盖所有可能性",但超出了模型容量。
Mode Seeking
KL(学生 || 老师) — 在线蒸馏用的方向。学生专注于拟合老师概率最高的那些模式,对其他可能性的概率趋近于零。结果是在给定容量下,学生把精力集中在"最可能对"的地方。
实际权衡:多样性 vs 性能
- Mode covering 方向:多样性高(学生知道多种答案),但精度可能偏低
- Mode seeking 方向:精度高(学生专注最优解),但多样性低
社区里最务实的做法是:一半一半混合。用 Jensen-Shannon divergence 或者在两个方向的 loss 之间取平均,通常能在不损失太多性能的同时保持合理的多样性。
蒸馏的进阶玩法:教师接管训练
在线蒸馏还有个更极致的变体,灵感来自推测解码:
学生一边采样,老师一边"监视"。如果学生输出太离谱(比如已经偏离到老师完全无法给出有意义的反馈),老师直接接管——自己采样一个正确的 token,然后交回给学生继续。
这就像学开车时学生方向盘打太猛了要撞树,教练直接一把拉回来,然后说"继续"。这个动作虽然成本更高(每次接管都要走老师的前向计算),但能让你训练出对"极端偏航"也有恢复能力的学生。
实操建议:先搞定简单的
Feryal 给了一条非常务实的路径:
- 先试合成数据蒸馏——最简单,能解决 80-90% 的问题
- 还不够好?上 Logit 匹配——信息量更足,但需要开源模型
更重要的是:离线和在线不是二选一,而是串行。 先做合成数据蒸馏做到 90%,再上在线蒸馏冲刺最后 10%。比如 DeepSeek R1 就是用合成数据蒸馏把蒸馏模型做到接近老师的水平,如果再叠一层在线蒸馏,差距可能会更小。
一个意外的彩蛋:蒸馏也能加速大模型本身
即使你只关心大模型本身,蒸馏也帮得上忙——推测解码(Speculative Decoding)。
流程很简单:
- 因为学生和老师的行为足够接近(这正是蒸馏带来的好处),老师经常可以一次接受多个词
最终结果是:推理速度大幅提升,输出分布完全不变。
Feryal 的结论很直白:"每个大模型都应该有一个配套的蒸馏小模型。"不只是为了替代大模型,而是为了让大模型自己跑得更快。
Google AI Reviews 等产品已经在生产环境中用上了这套方案。
蒸馏的故事告诉我们一个朴素的道理:别急着满意。你今天在用的蒸馏方法可能是 2015 年的。而强化学习领域十年前就有的好方法(DAGGER、on-policy sampling),放在 LLM 上照样管用。Feryal 的呼吁是:"默认假设当前的方法还有优化空间,然后去找到它。"
 AI 速览