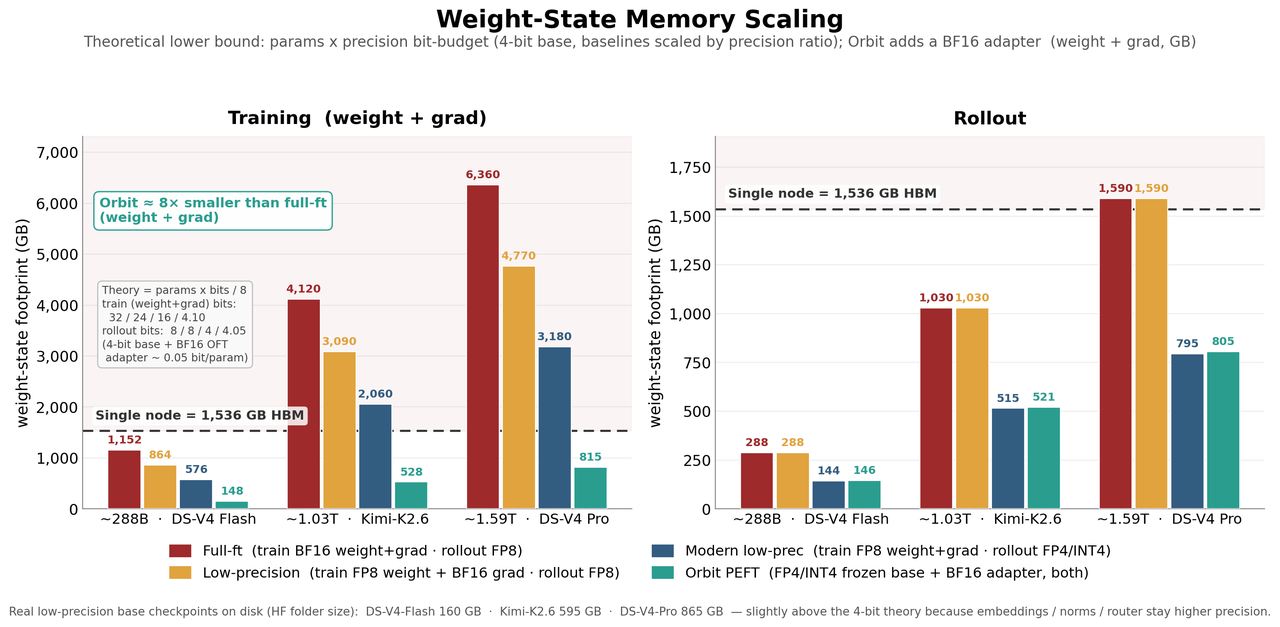
Sphere AI Lab 发布 Orbit——基于 OFT 适配器的开源 RL 训练框架,在单台 8×B200 节点上完成 Kimi-K2.6(~1T)和 DeepSeek V4-Pro(~1.6T)的强化学习后训练。冻结低精度基座,BF16 适配器承载梯度,训练内存仅约 528 GB。 - Sphere AI Lab 开源 Orbit,一款基于 OFT 适配器的强化学习后训练框架,专为万亿参数级大语言模型设计
- 核心设计:基座模型冻结在部署精度(INT4/FP4/FP8),所有梯度更新通过一个极小的 BF16 OFT 适配器承载
- 在单台 8×B200(1,536 GB HBM)节点上成功完成 Kimi-K2.6(~1.03T)和 DeepSeek V4-Pro(~1.6T)的端到端 RL 训练
- 训练内存仅约 528 GB(Kimi-K2.6),对比全参数训练的 ~4,120 GB 需求,缩减约 87%
- 训练精度与推理精度一致,消除了低精度 RL 中长期存在的 train-rollout 精度漂移问题
Orbit 要解决的核心问题:万亿参数 RL 后训练的内存瓶颈
当前主流大语言模型已跨越万亿参数门槛。按照传统 RL 后训练方案,训练需要高精度全参数更新,多节点分布式部署。以 Kimi-K2.6(~1.03T)为例,全参数 BF16 训练下权重与梯度合计约 4,120 GB,远超单台 8×B200 节点的 1,536 GB HBM,必须依赖多节点编排。
Orbit 采用截然不同的路线:基座模型冻结在其部署精度上,梯度信号只放在一个极小的 BF16 适配器上。结果是万亿参数级的 RL 后训练在单台 8×B200 上即可完成,训练和推理之间的精度差异天然消失。
技术原理:低精度基座 + BF16 适配器 + OFT
Orbit 的技术栈建立在三个关键选择上:
冻结低精度基座 — 基座模型在训练和 rollout 阶段保持相同的低精度(INT4/FP4/FP8),不参与梯度计算。训练与服务的精度一致,消除了传统低精度 RL 中"训练基座高精度、服务基座低精度"导致的稳定性问题。
BF16 适配器承载梯度 — 仅适配器部分以 BF16 精度参与前向和反向传播。在 Kimi-K2.6 规模上,适配器的参数量仅约基座的 0.04 比特/参数,训练内存大幅压缩至约 528 GB。
OFT(正交微调) — Orbit 默认采用 OFT 而非 LoRA。Sphere AI Lab 在 PEFT-Arena 基准测试中发现,OFT 在 RLVR 设定下能持续超越全参数微调,而 LoRA 在同等参数预算下表现不及。在 Qwen3-30B-A3B 上的 500 步 RL 实验中,OFT 在训练奖励、评估准确率和 pass@8 三个指标上均优于 LoRA。
三种规模模型的实际验证
Orbit 团队在三种不同规模的模型上完成了端到端验证:
| | | | | |
|---|
| | | | | 训练奖励 0.33→0.88;AIME24/AMC23/MATH500 持续上升;|Δ log-prob| 维持在 0.0066–0.0104 |
| | | | | 训练奖励 0.62→0.84;|Δ log-prob| 维持在 0.0161–0.0247 |
| | | | | |Δ log-prob| 维持在 0.030–0.040;GPU 内存峰值 188 GB/192 GB |
在 27 小时的 Kimi-K2.6 稳定运行中,GPU 内存均值约 160 GB,峰值约 191 GB(B200 HBM 上限 192 GB),无上漂趋势。
适配器优先架构的五大设计特性
Orbit 的适配器优先架构是单节点万亿级 RL 成为可能的关键:
极轻量的权重同步 — 仅兆字节级的适配器增量在 trainer 和 rollout 引擎之间传输,无千兆字节级的权重导出、格式转换或服务重建。
状态内存解耦 — 优化器状态被限制在微小适配器上,冻结基座驻留在低精度内存中,使大规模 MoE 模型在单节点上可行。
零额外参考模型开销 — KL 散度参考直接使用不带适配器的冻结基座,无需额外保存一份 actor 快照。
异步适配器双缓冲 — SGLang 可将下一个版本的适配器流式写入空闲槽位,同时活跃槽位继续服务请求,激活原子性切换,零 rollout 气泡。在 Qwen3-4B + OFT(8×B200, TP=2)上实现 1.42× 步加速和 44% 的更高 rollout 吞吐量。
自定义适配器核函数 — 针对融合层(Q/K/V 注意力、Gated MLP)实现分投影分割核函数,消除共享适配器参数对不同子空间的退化影响,在 Kimi 上削减核函数时间约 35%。
OFT 相比 LoRA 的架构优势
除精度表现更优外,OFT 还有两项系统级优势:
零额外网络通信开销 — OFT 的局部化矩阵设计天然避免了跨设备规约步骤,在分布式推理中无需类似 S-LoRA 的方案去额外融合 all-reduce 步骤。
分投影适配器支持 — Orbit 自研的分投影分割核函数将融合张量中的各子空间分配独立的正交旋转,避免 LoRA 方案中共享低秩矩阵导致的能力退化。
对低精度 MoE 模型的专门优化
针对 DeepSeek V4 系列等大规模 MoE 模型,Orbit 实现了活跃专家分块反量化技术:仅将路由器选中的专家动态分组为固定大小批次,临时反量化后进行分组 GEMM,随后立即释放高精度权重。混合策略在保持全分组矩阵乘法吞吐量的同时,严格限制峰值瞬态内存为单个小块,防止大规模低精度 MoE 在训练中 OOM。
开源与引用
Orbit 以 Apache 2.0 许可证开源,代码托管于 GitHub(Sphere-AI-Lab/orbit)。项目依赖 CUDA 13.2、PyTorch 2.11 和 Python 3.12,后端整合了 Megatron-Bridge、Megatron-LM 和 SGLang。该工作由香港中文大学和马克斯·普朗克智能系统研究所的研究人员共同完成,作者包括 Zeju Qiu、Le Chen、Lixin Liu、Tim Z. Xiao、Bernhard Schölkopf 和 Weiyang Liu 等。
 AI 速览