不一定要用Claude。对大多数开发者来说,这个问题的答案越来越取决于任务本身——复杂架构和关键交付继续交给Claude,前端演示、批量改代码、跑测试这类任务,Kimi K2.7 Code和GLM-5.2已经开始提供更便宜的选择。 Claude Code火起来以后,AI写代码这件事变了。不是问它"这个函数怎么写",而是把整个任务扔过去:读项目、改文件、跑命令、看报错、继续往下做。这套用法跑起来以后,聪明只是第一关,更现实的问题是:谁跑得起。 一个模型如果只回答一次,贵点还能忍。但如果它要连续读几十个文件,反复改代码、跑测试、再根据结果继续修,一次任务就可能吃掉大量token,5小时额度很快烧完。到了这步,价格、限额、速度都会算进"能力"里。
国产模型切进来的位置,正是在这里。
Kimi K2.7 Code:让任务少绕几圈
月之暗面在2026年6月12日发布并开源了Kimi K2.7 Code。根据官方基准测试,新模型在长上下文编程场景的指令理解与任务处理能力上有明显提升,改善了长任务下的冗余推理问题,整体token平均消耗量降低30%。在专业代码评测榜单中,Kimi Code Bench v2提升21.8%,Program-Bench提升11%,MLS Bench Lite提升31.5%。
这些是官方数字,独立评测还没完全跟上。但月之暗面想讲的方向很清楚:让代码任务跑得更省。
AI编程真正烧钱的地方,往往发生在一连串动作里。模型读上下文,决定下一步,改文件,看运行结果,再决定怎么修。少绕一圈,少吃一截token,最终都可能变成实际账单差异。已经有海外开发者感觉到了:Kimi K2.7 Code像个干活的,不像个聊天的。
工具层面,目前企业与开发者均可通过Kimi API平台接入使用,Kimi Code Plan默认模型已更新为K2.7 Code。它还在往工具入口走——视频上下文、ACP协议、JetBrains和Zed集成、自定义hooks。这些功能不用全记,读者只要看到一个方向:Kimi也想做AI编程助手的入口,跟Claude Code在"谁能接活、多跑几步"上直接竞争。
GLM-5.2:抢的是后端位置
2026年6月13日,智谱AI同时做了两件事:GLM-5.2面向GLM Coding Plan全量用户开放,ZCode 3.0正式发布并全面切换自研Agent内核。
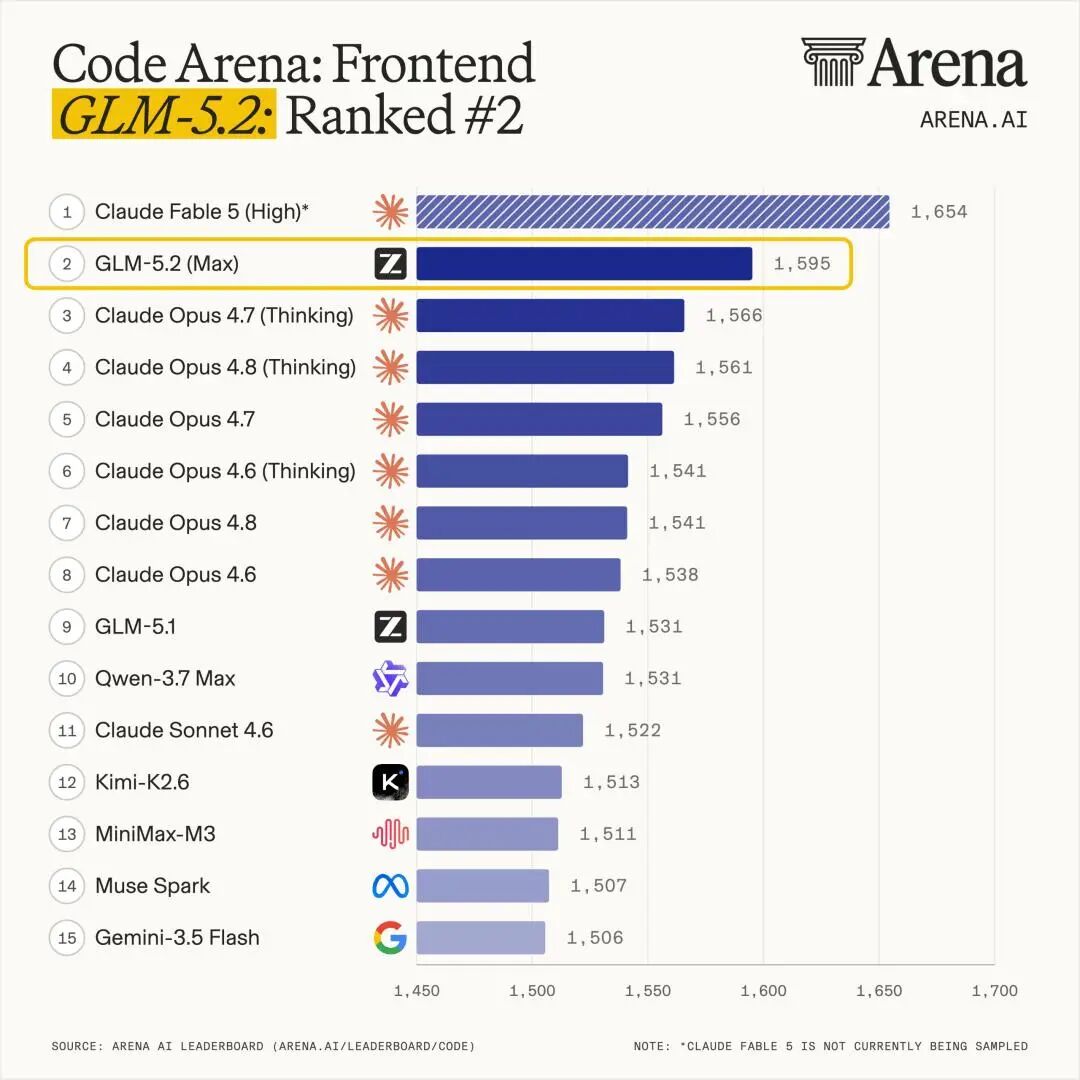
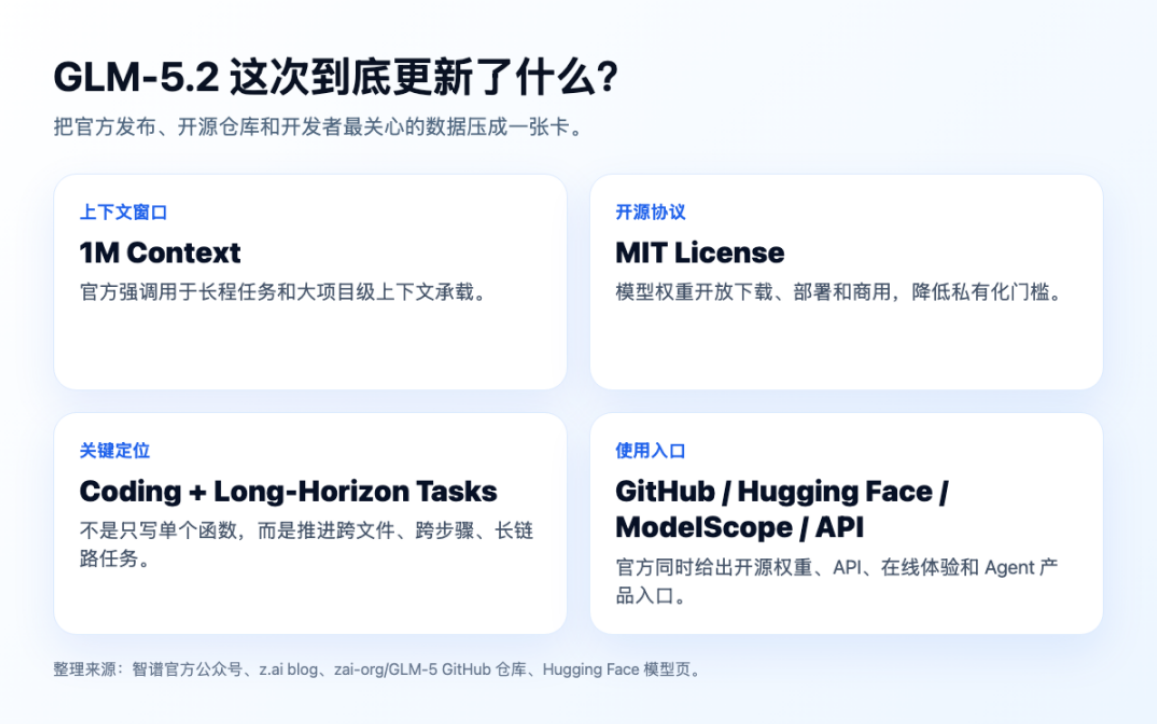
GLM-5.2共744B参数,约40B激活参数,支持1M token上下文。GLM的路数更直接——重点不是"我跑分多少",而是工具链和长任务。GLM-5.2强调的是"真正可用的1M上下文",即在百万级token输入下仍能维持推理质量。对开发场景的实际意义在于:可以把较大范围的代码库一次性纳入上下文,减少分段喂入带来的信息割裂。
ZCode 3.0在内核层面对GLM-5.2做了深度适配,全面启用自研ZCode Agent内核,官方称在长程推理、工具调用与大型工程执行上,整体效果优于此前基于第三方Agent的方案。它的卖点也摆得很直白:150%配额、5天免费试用、每天500万token。翻译过来就是:你可以拿它多跑一点。
真实测试里的差别
外网已经有人把两个模型放进同类任务里对比。有人做了类似体素世界的生成任务,同一套设置分别交给GLM-5.2和Kimi K2.7。结果是GLM大约35分钟一次完成,Kimi K2.7约30分钟,但后面还需要额外提示去修bug。一个模型快一点,但需要返工;另一个慢一点,但一次交付更完整。真正花钱的时候,开发者算的就是这种账。
另一个合同审查任务的三方测试,让GLM、Kimi、Claude同时做同一份需求文档。那张表里的结果没有反转:Claude最快、质量最高;GLM质量接近,但速度慢;Kimi更快,步骤更多,质量稍低。这就够了——Claude仍然是标尺,Kimi和GLM在不同位置靠近它。
便宜不等于放心交活
有开发者买了Kimi相关的高价套餐,"30分钟就把额度烧完了",几个生成任务效果也不理想。这个测试有局限,但仍然提醒我们:开源、低价、声量大,不等于可以放心交活。
月之暗面说的是推理token使用下降,用户吐槽的是套餐和额度体感。模型更省,不等于用户马上觉得更便宜。如果配额设得紧,或者任务本身会反复试错,省下来的token可能还没来得及被感知到。
"进入候选池"和"用户开始迁移"不是一回事。
定价层面怎么算
三者的定价模式不同,直接比价没意义,但方向可以看。Kimi K2.7 Code的官方API定价为输入4.00/百万token。GLM Coding Plan海外版起价每月20,Max从$100起,碰上限后要么等重置、要么升级、要么切按量付费。 但一旦模型开始干活,便宜就不只是价格标签。便宜意味着你敢让它多试几次,敢让它跑更长任务,敢把不确定的任务先丢一个副本给它处理。前提是:模型本身得能干活。如果每次都跑偏,便宜只会带来更多无效等待。
Kimi和GLM现在的位置,恰好就在这条线附近:有些任务已经可以试,有些任务还得谨慎。
Kimi K2.7 Code和GLM-5.2还没把Claude Code拉下去,也没证明自己能在所有任务上赢。但它们已经把国产编程模型带进了一个更具体的位置——进入开发者工作流,参与"哪些任务交给最贵的模型,哪些可以交给便宜副手"的分工。
复杂架构、难重构、关键交付,Claude仍然更稳;前端演示、批量修改、测试修补这类任务,Kimi和GLM已经是真实的备选。Claude Code先把路走出来了,国产模型现在卷的,是把这套用法变得更便宜,便宜到可以当日常工具用。
 AI 速览