- Claude Code 按 token 计费,同一任务在不同用法下成本可差数倍;官方 8月14日 发布会话优化指南。
- token 价格由三因素决定:模型、输入还是输出(输出约 5 倍输入)、是否命中缓存(缓存读 0.1 倍、缓存写 2 倍)。
- 中途切换 /model 或 /effort 会破坏 prompt cache,导致整段历史按全价重新 prefill;切换要在会话开始或 /clear 后做。
- @-mention 文件比手输路径更省——文件直接附进首条请求,省一次 Read 调用和可能的搜索;同文件每会话提一次即可。
- /compact 在休息前做比休息后便宜:订阅缓存 1 小时过期,总结旧会话时缓存还在。
- 子 agent 用自己的上下文处理噪声任务,只把结论带回主会话;3-4 月社区曾因缓存 bug 遭遇 5-20 倍用量异常消耗。
为什么同样的任务,token 花费能差出好几倍
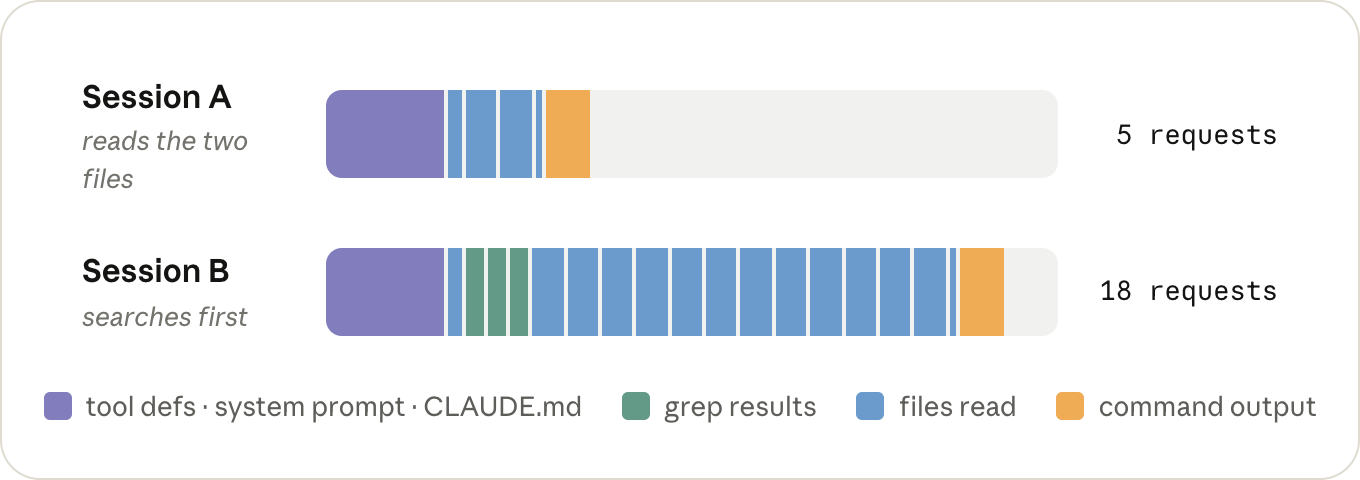
用 Claude Code 修一个测试,不同跑法成本完全不同。一种会话里,Claude 读测试和被测文件、改完收工,几个回合结束;另一种会话里,它先 grep 一遍仓库、读了十几个文件才找到那两个要改的,而且从早上起读过的每个文件都还挂在上下文里,之后每一轮都要带着它们思考。同一个修复,token 花掉了好几倍,模型还一直在处理它不需要的文件。 官方 8月14日 发布的《Maximizing the value of your Claude Code sessions》把成本模型拆开了:效率不是"少用 token",而是"让用掉的 token 都花在你真正要求的事情上"。理解这个,要先看 token 价格由什么决定。
token 价格三要素:模型、输入输出与缓存
一次请求的计费由三件事决定。第一是模型,更大的模型对输入输出都做更多计算,所以价格更高。第二是输入还是输出:请求分 prefill(读入)和 decode(写出)两个阶段,输出逐 token 生成,每 token 占 GPU 更久,官方口径输出价格约为输入的 5 倍。第三是是否命中缓存。
Claude Code 的 prompt cache 是自动开启的。如果一条请求的开头与服务器刚见过的请求完全一致,这段共享开头会从缓存读取,价格是正常输入的 0.1 倍;写入缓存的 token 价格略高于普通输入(最高 2 倍),但写入每个 token 只发生一次,之后的读取每轮都是 0.1 倍。官方博客举例:一次"修复 utils.test.ts 里失败的测试"小任务,Claude Code 发起了 5 次请求,每次请求都包含到当时为止的整个对话——但只有每轮新增的部分按全价 prefill,其余全部是缓存读。订阅用户看不到这些单价,但同样的请求在消耗用量上限。
社区实测补充了细节:缓存默认 TTL 是 5 分钟(API 可配置 1 小时,ENABLE_PROMPT_CACHING_1H=1),且每个模型有最小可缓存长度(如 Opus 需 512 token 起)。2026年3-4月,Claude Code 曾因 prompt cache bug 被社区报告用量 5-20 倍加速消耗(GitHub issue #41930),Anthropic 事后修复并重置了用量额度——这也解释了为什么用户如今如此在意缓存命中。
什么会破坏缓存
缓存要求请求从最开头逐字节一致,而 Claude Code 的请求顺序固定:工具定义、系统提示、对话(CLAUDE.md 在最前)。如果前缀里任何东西变了,后面全部内容都要重新按全价 prefill。破坏缓存的主要因素有四类:切换模型(/model,每个模型独立缓存,包括 opusplan 进出计划模式)、切换 effort 档位(/effort 是缓存 key 的一部分)、开启 fast mode(同样是 key,要在一开始就开)、以及 /compact、超时与恢复旧会话(对话被替换或缓存过期,整段重新 prefill)。
官方强调这不是说永远别切换模型或 effort,而是有便宜的时刻(会话开始或 /clear 后)和昂贵的时刻(长对话中间)。如果最后几轮跑偏了,用 /rewind 回退到之前的位置——它只切掉末尾几轮,之前的缓存还在,几乎零成本;/compact 重写整个对话,永远有成本。
减少上下文体积的三个动作
会话里几乎一切进入上下文的 token 都会在之后每一轮被重复发送。虽然命中缓存便宜,但它占据模型每轮思考的上下文空间。控制方法有三个。
第一,@-mention 文件。说"测试挂了"Claude 要先 grep 找是哪些测试、开几个文件确认,这些搜索结果全留在上下文里;直接 @utils.test.ts 则文件直接附进首条请求,省一次 Read 调用,路径也不用 Claude 猜。注意同文件每会话提一次即可,重复 @-mention 会附加第二份副本。
第二,给噪声命令加安静标志,或交给子 agent。命令输出和文件一样被追加进对话并停留。超过 30,000 字符的输出会自动写入文件、只留预览和路径(BASH_MAX_OUTPUT_LENGTH 可调),但 400 行逐条打印的测试通过列表在限制以下,会变成之后每轮的一部分。把常用命令带安静标志写进 CLAUDE.md,如 npx vitest run --reporter=dot,省一轮对话和几百行输出。
第三,用 /context 检查加载项。新会话里跑 /context 看加载了什么(CLAUDE.md、MCP 工具定义),把不需要的 MCP server 用 /mcp 关掉;CLAUDE.md 只放具体指令,工作流专用内容移到 skills 里按需加载。
会话生命周期与子 agent 怎么用
一个长会话比同样工作拆成几个短会话更贵,因为第 40 轮还要重读前面 39 轮。新任务开始时用 /clear 隔离,不要带着上一个任务的上下文;还想找回会话先 /rename。同一任务的早期部分做完就 /compact,并告诉它保留什么,或在 CLAUDE.md 写"Compact instructions"。休息前 /compact 比休息后便宜:缓存 1 小时过期,趁缓存还在总结旧对话,写摘要本身便宜。1M 模型想找回自动压缩安全网,用 /autocompact 200k(需 v2.1.221+)。
/loop 会在你启动它的那个会话里以完整回合运行,每次都带着整个对话;如果距上一轮已超过 1 小时,还叠加缓存未命中。正确的做法是在另一个终端开新会话跑循环。
子 agent 有自己独立的上下文窗口、系统提示和 CLAUDE.md,但没有主会话的对话。它自己跑回合,回到主会话的只有它的结论,其余全部丢弃。代价是它有时要重读主会话已有的文件,并为自己读的每一轮付费。对小任务这是纯开销;对会产生大量你不必保留的输出(如翻日志)的任务,隔离价值明显。Claude 常会自己调用子 agent,也可以主动要求:"go through this log in a subagent"。需要反复交出去的高噪声任务,给它定义子 agent 规格并指定 model: haiku(或 sonnet),否则它会跟随主会话的模型。
怎么用:8 条可执行动作
- 新任务先 /clear;需要保留会话先 /rename 再清。
- 会话开始就用 /model 和 /effort 定好配置,中途不切换(进计划模式留意 opusplan)。
- 提到文件用 @-mention,同一文件只提一次。
- 常用命令带安静标志写进 CLAUDE.md,如
--reporter=dot。
- 新会话跑 /context,关掉不需要的 MCP server。
- 休息前 /compact 并说明保留内容;想回退用 /rewind 而非 /compact。
- 噪声大、输出多的任务交给子 agent,并指定 haiku/sonnet。
 AI 速览