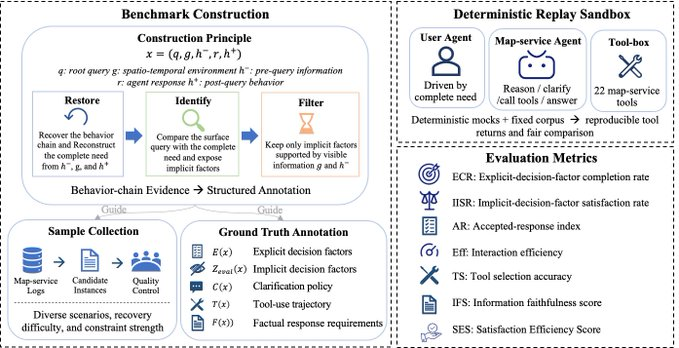
近日, 高德地图 AI 团队发布arXiv 论文(2606.17453),并发布新基准 MapSatisfyBench,首次将地图智能体的评估重心从「任务是否完成」转向「用户是否满意」。这是继今年 2 月 MobilityBench 之后,高德在地图 Agent 评估领域的第二次系统性输出。研究团队测试了 Claude-4.6-opus、GPT-5.3、Deepseek-v4-pro、Gemini-3.1-pro-preview、Qwen3.6-plus 等 12 个模型,结果揭示了一个行业性短板:前沿大模型在显式任务完成率上普遍超过 90%,但隐式决策因素满足率(IISR)最高仅 73.2%,综合满意效率得分(SES)无一突破 0.29。 高德为什么要再造一个 Benchmark
今年 2 月,高德联合中科院团队发布了 MobilityBench,基于 10 万条真实用户查询评估路径规划 Agent 的任务完成度和约束满足率。那次评测已经发现:模型在基础信息检索和标准路径规划上表现合格,但在偏好约束型规划(如避开高速、控制换乘次数)上存在明显短板。
MapSatisfyBench 将这个发现再往前推了一步。MobilityBench 衡量的是 Agent 能否按照用户显式指令执行,但即使指令被完美执行,用户仍可能不满意——因为真实交互中的需求往往没有被说出口。
举个例子,用户搜索「附近适合带孩子吃饭的地方」,表面查询是餐厅搜索,但隐含需求可能包括停车方便、有儿童座椅、距离不超过 2 公里、不要太吵。这些「未说出口的决策因素」才是决定用户是否接受推荐结果的关键。MapSatisfyBench 的核心创新就在于系统化地量化这些隐式因素。
基准构建:从真实日志中逆向还原用户完整需求
MapSatisfyBench 的数据并非人工编造,而是从高德地图服务的真实交互日志中提取——这与 MobilityBench 基于高德匿名化 query 的数据策略一脉相承。构建流程分三步:首先通过行为链证据(包括查询前的时空环境 g、用户查询 q、Agent 响应 r、查询后行为 h⁺)还原用户的完整需求;然后将表面查询与完整需求做对比,识别出隐式决策因素;最后过滤掉缺乏可见信息支撑的因素,只保留可从上下文合理推断的隐式需求。
评估环节沿用了高德在 MobilityBench 中验证过的确定性回放沙箱(Deterministic Replay Sandbox)架构,内置 22 个地图服务工具,通过预录制响应消除 API 动态变化的干扰,确保不同模型在完全相同的条件下对比。但标注体系更为精细——每个样本包含显式决策因素 E(x)、隐式决策因素 Z(x)、澄清策略 C(x)、工具调用轨迹 T(x) 和事实性回答要求 F(x) 五维标注。
7 项指标拆解:谁在领先,谁在落后
MapSatisfyBench 设计了 7 个评估维度,覆盖从工具调用到用户接受度的完整链路。
在显式能力方面,各模型表现相对集中。显式决策因素完成率(ECR)上,GPT-5.3 以 0.9272 排名第一,Claude-4.6-opus(0.9148)和 Deepseek-v4-pro(0.9088)紧随其后,说明前沿模型处理用户明确提出的需求已不成问题。工具选择准确率(TS)由 Claude-4.6-opus 以 0.4942 领先,但整体水平都在 0.43-0.49 之间,没有明显拉开差距。信息忠实度(IFS)上 Gemini-3.1-pro-preview 以 0.9645 取得最佳,说明其生成的回答与工具返回数据的一致性最高。 真正拉开差距的是隐式能力和综合效率。隐式决策因素满足率(IISR)是本基准的核心指标——Claude-4.6-opus 以 0.7170 显著领先,第二名 GPT-5.3 为 0.6736,第三名 Deepseek-v4-pro 为 0.7017。也就是说,即便最好的模型也有近 30% 的隐式需求未被识别和满足。用户接受度指数(AR)同样由 Claude-4.6-opus 以 0.6749 领先,GPT-5.3(0.6363)和 Deepseek-v4-pro(0.6606)分列其后。交互效率(Eff)维度上,Qwen3-235b 以 0.4649 小幅领先,反映出其在多轮对话中的信息密度优势。
综合满意效率得分(SES)是加权汇总指标,GPT-5.3 以 0.2755 居首,Claude-4.6-opus 为 0.2744,差距极小。值得注意的是,所有模型的 SES 都未超过 0.29,这意味着从满意度角度衡量,当前最强模型也仅能让用户约 1/4 的决策体验达到理想状态。
小型模型的表现则显著落后。Qwen3-30b 的 IISR 仅 0.3635,ECR 也只有 0.6083;Qwen3-8b 更低,IISR 为 0.3716、ECR 为 0.6997。与头部模型相比,小模型不仅缺乏隐式推理能力,连显式任务完成也存在明显差距。
思考模式能否弥补隐式推理短板
研究还测试了 3 个模型开启思考模式(Thinking Mode)后的表现。Deepseek-v4-pro-th 在开启思考后,IISR 从 0.7017 提升至 0.7320,成为全部 15 个测试条目中的最高分;AR 从 0.6606 升至 0.6963,SES 从 0.2698 升至 0.2858,同样是全场最佳。这表明深度推理链确实有助于挖掘用户的隐含意图。
但思考模式并非万能。Gemini-3.1-pro-preview-th 的 IISR 反而从 0.5383 下降至 0.6469(相对基础版有所提升,但仍不及 Claude 和 Deepseek),且 AR 从 0.4846 升至 0.6084,提升幅度有限。Qwen3.6-plus-th 的改善也较为温和。思考模式的额外推理开销是否值得,取决于具体场景对隐式需求覆盖的敏感程度。
高德评估体系的升级路径:从「完成任务」到「让用户满意」
MobilityBench 和 MapSatisfyBench 出自同一团队,构成了高德地图 Agent 评估体系的两层。MobilityBench 解决的是基础能力验证——Agent 能否正确理解路径规划指令、调用 API、遵守约束,相当于考试中的「标准答案题」。MapSatisfyBench 在此之上增加了「开放题」——Agent 是否能主动推断用户没有明说的偏好,并据此优化回答。
这个升级方向与高德 2025 年推出的 AI 智能体「小高老师」的产品逻辑直接对应。「小高老师」的核心定位是通过主动搜索对话和被动推荐引导,让用户一句话就能完成复杂出行规划。而 MapSatisfyBench 的测试结果等于给出了一个量化结论:目前市面上的大模型,在这个「主动理解」的维度上还远未达标。
选型参考
如果你的地图应用场景重视用户留存和推荐接受率,关注隐式需求识别能力(IISR 和 AR)是关键。从当前数据看,Claude-4.6-opus 在非思考模式下综合表现最均衡;需要极致隐式推理且可接受延迟的场景,Deepseek-v4-pro 开启思考模式是目前的最优选择(SES 0.2858,全场第一)。GPT-5.3 在显式任务和 SES 上有竞争力,但隐式指标弱于前两者。小型模型(30b 以下)目前不适合需要隐式决策理解的地图 Agent 场景。
整体来看,MapSatisfyBench 揭示的核心问题并非模型不够聪明,而是当前 Agent 架构普遍缺乏「主动澄清和推断未说出口的需求」的能力设计。SES 不足 0.29 的集体天花板,更多是系统层面的问题,而非单纯的模型能力瓶颈。对于高德而言,从 MobilityBench 到 MapSatisfyBench 的演进路径也说明:当基础任务完成率已被拉到 90% 以上的高位,下一阶段的竞争焦点将转向「隐式需求理解」——这恰好是地图场景中最影响用户留存的因素。
 AI 速览