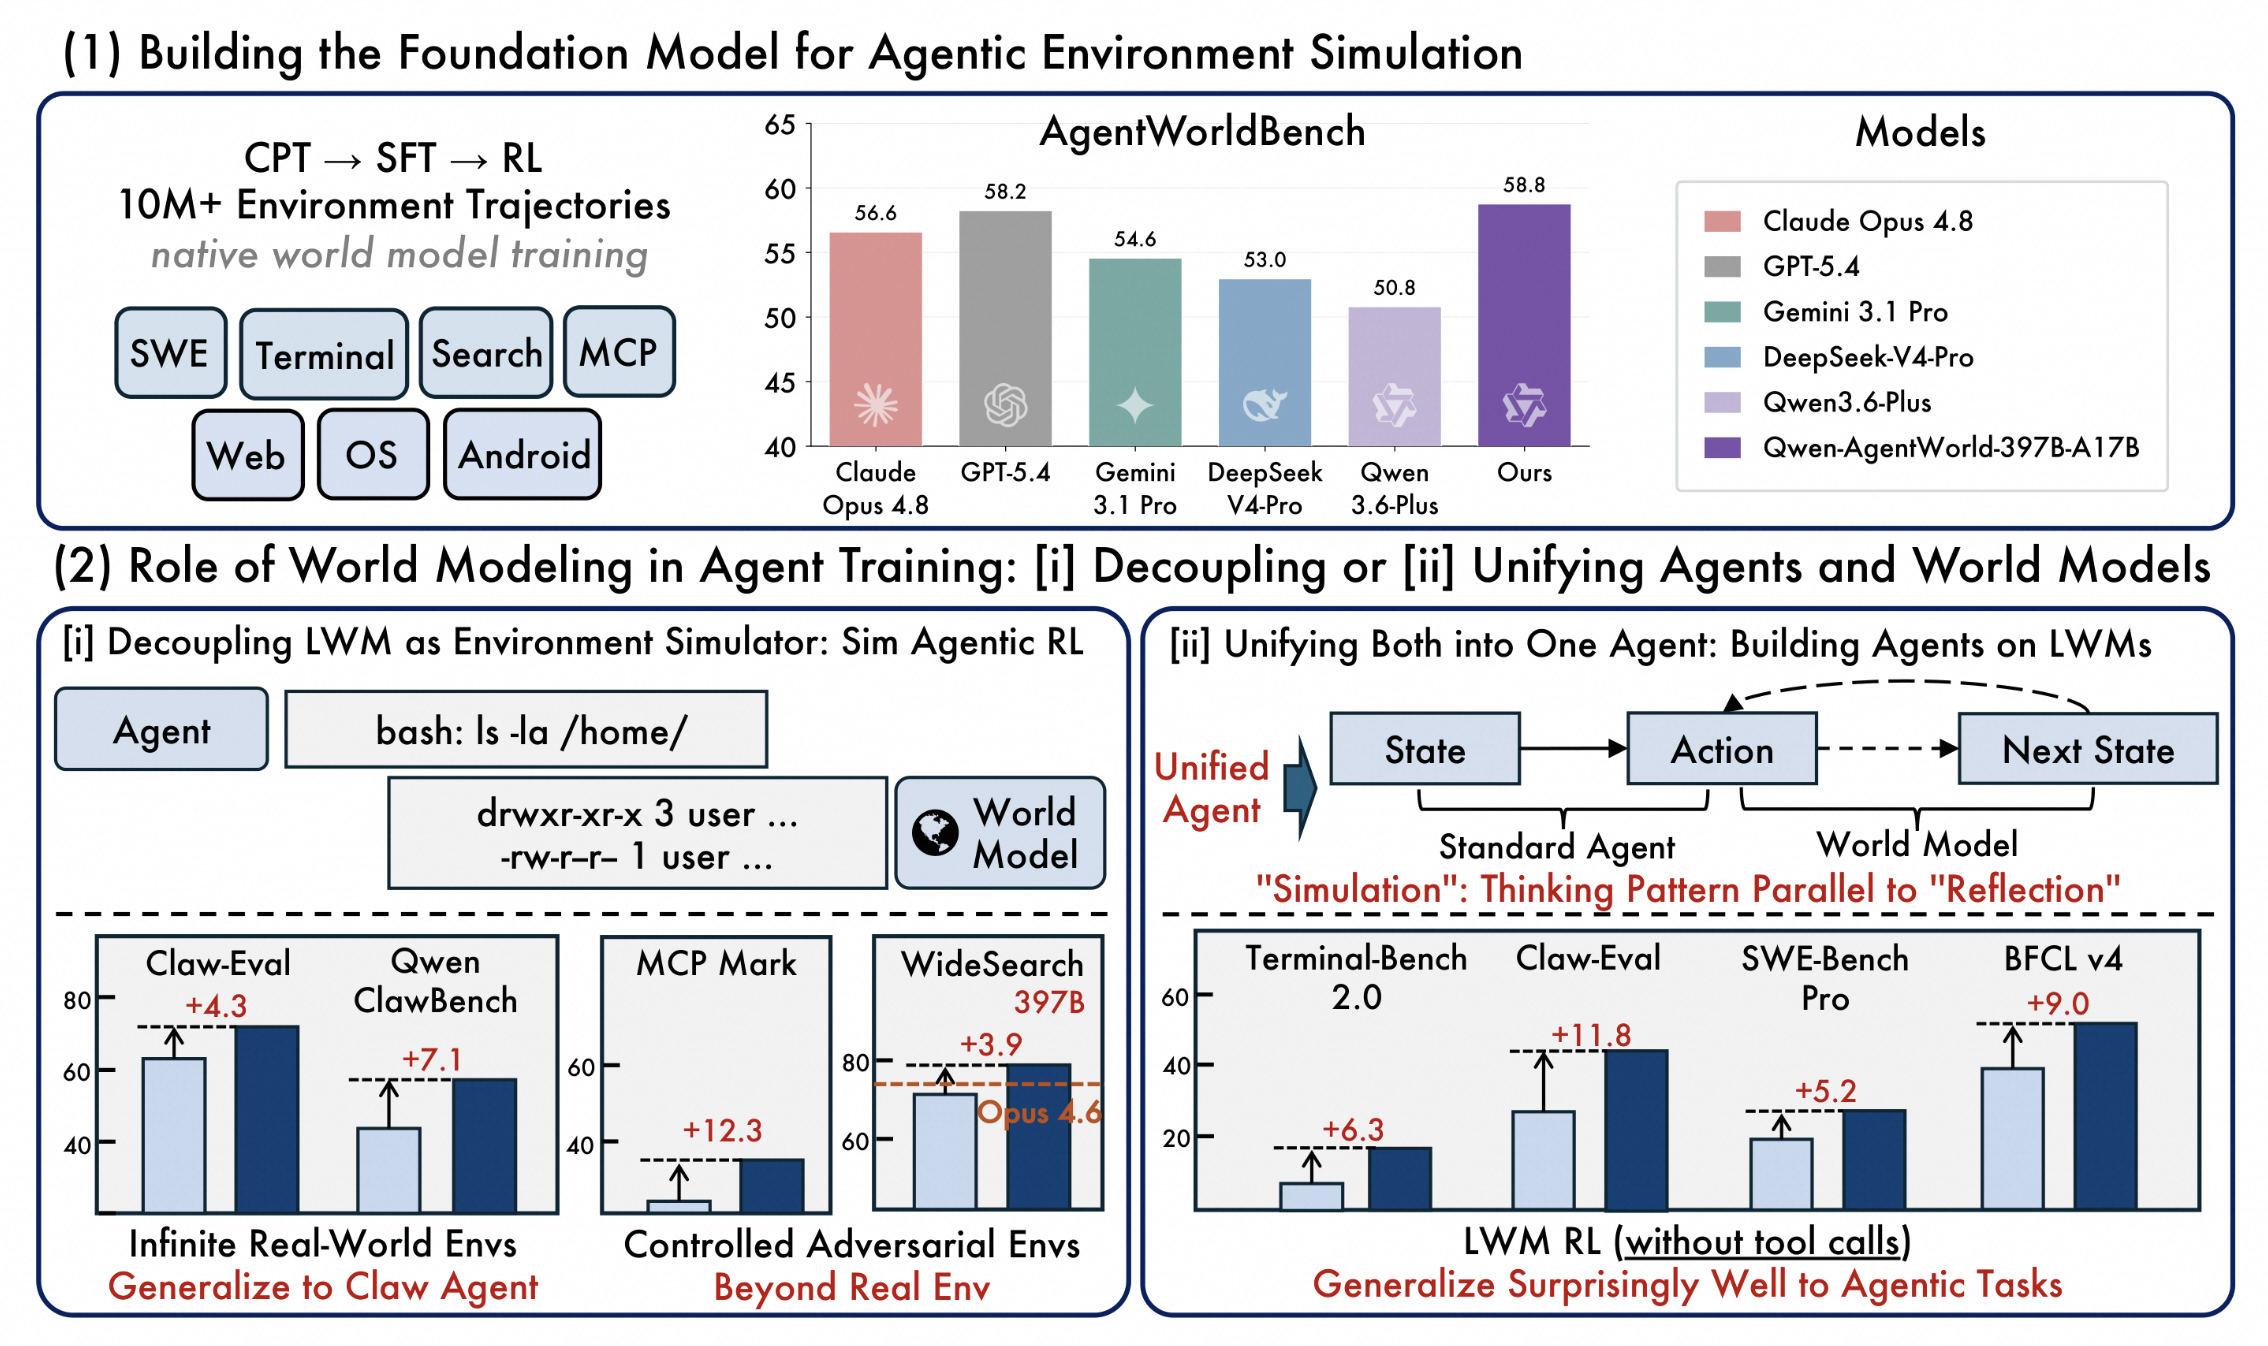
6月24日消息,阿里通义千问团队正式开源 Qwen-AgentWorld,定位为首个原生语言世界模型。其核心思路是:与其让 Agent 在真实环境中试错,不如先让 AI 学会"预测环境会发生什么"。 Qwen-AgentWorld 基于超 1000 万条真实交互轨迹,经由 CPT → SFT → RL 三阶段训练,覆盖文本类和 GUI 类七大领域。在 AgentWorldBench 上,397B 参数版本以 58.71 整体均分超越 GPT-5.4(58.25)和 Claude Opus 4.8 等前沿模型。 解决什么问题
语言智能体的训练高度依赖与环境交互,但真实环境存在三个核心痛点:成本高昂、响应缓慢、控制困难。搭建沙箱环境成本高,真实边缘 case 难以收集。更关键的是,在真实环境中做强化学习——一旦 Agent 执行不可逆的危险操作,整个环境就会崩溃。
Qwen 团队的选择是:建立一个语言世界模型,让 Agent 先预测环境响应,再据此优化行为。
七个领域,一个模型
Qwen-AgentWorld 覆盖七类交互式环境,单一模型统一建模:
文本类环境:MCP(工具调用)、Search(搜索)、Terminal(终端)、SWE(软件工程)
GUI 类环境:Web(网页)、OS(操作系统)、Android(移动端)
对于三个 GUI 领域,环境观测以可渲染代码(无障碍树 XML、HTML、UI 层级标记)而非像素帧的形式呈现,使纯文本世界建模即可涵盖视觉环境。
三阶段训练流程
Qwen-AgentWorld 自继续预训练(CPT)阶段起便将环境建模作为显式目标,贯穿全流程:
CPT(继续预训练):通过学习不含思维链的交互轨迹,向模型注入环境知识。数据来源包括专用 Agent 基础设施、开源轨迹和内部轨迹。本阶段的关键贡献是轮次级别的信息论损失掩码——通过 4 个表层统计量识别每个(动作,观测)对中真正承载环境信息的对话轮,其余轮不参与 loss 计算。
SFT(监督微调):通过 ... 包裹的思考过程,将下一状态预测激活为显式的思维链推理模式。采用拒绝采样筛选高质量轨迹,最终获得 7,094 条训练样本。
RL(强化学习):基于 GSPO 算法训练,奖励信号由两部分组成——多维质量的 LLM 评判器,以及针对可客观验证正确性的规则验证器。
AgentWorldBench 评测表现
Qwen-AgentWorld 同时推出了综合性评测基准 AgentWorldBench,基于 5 个前沿模型在 9 个成熟评测集上的真实环境交互观测构建。评测从格式、事实性、一致性、真实性和质量五个维度进行评估。
在 397B-A17B 规模上,Qwen-AgentWorld 以 58.71 整体均分超越 GPT-5.4(58.25),优势在 Terminal 和 SWE 两个领域最为显著。
在 35B-A3B 规模上,三阶段训练流水线将整体均分提升了 +8.66(47.73 → 56.39),使该版本超过 Claude Sonnet 4.6(56.04)。
两种应用范式
范式一:解耦的环境模拟器
将策略智能体与世界模型解耦为两个独立模型,Qwen-AgentWorld 在 RL 训练期间替代真实环境。
核心发现:
- 零样本环境泛化:成功模拟训练数据中完全不存在的 4,000 个 OpenClaw 环境,在 Claw-Eval 和 QwenClawBench 上分别取得 +4.3 和 +7.1 的增益
- 可控模拟至关重要:不施加控制的 Sim RL 几乎没有提升,可控扰动则将 MCPMark 提升 +12.3
- 超越真实环境训练:可控 Sim RL 在 WideSearch 上超越使用真实搜索引擎训练的 Real RL(F1:50.3% vs. 45.6%)
- 虚构世界同样有效:在完全虚构但自洽的世界中训练的智能体,可成功泛化至真实搜索任务,同时防止智能体混淆模拟事实与真实知识
范式二:智能体基础模型
将智能体和世界模型统一——同一个模型既选择动作也预测环境状态。LWM 训练将下一状态预测植入为内化的推理能力。
关键发现:单轮、非工具调用的 LWM RL 预热,迁移到了跨 5 个领域 7 个基准的多轮工具调用智能体任务。在 LWM 训练完全不涉及的领域上涌现了显著增益——Claw-Eval +11.3、QwenClawBench +9.7、BFCL v4 +9.0。
开源与获取
Qwen-AgentWorld 与评测基准 AgentWorldBench 均已开源:
 AI 速览