研究发现:少量有益数据撬动 44 项基准全面提升
OpenAI 研究团队构建了一套合成的真实对话数据集,覆盖健康、教育、科学、法律、工程、经济等多个领域,每条对话都设计用于测试模型在压力、模糊性或利益冲突情境下是否展现特定的有益特质。这些特质包括七个维度:诚实性(truthfulness)、认知谦逊(epistemic humility)、元认知透明性(metacognitive transparency)、可纠正性(corrigibility)、风险敏感性(risk sensitivity)、普遍公平(universal fairness)以及对人类福祉的关注(concern for human welfare)。
训练采用了真实的后训练混合策略——将少量有益特质数据混入标准 RL 数据分布中,与算力匹配的基线模型进行对比。结果显示,经过训练的模型不仅在分布内评估中大幅提升,更关键的是在 53 项独立的公开和内部基准测试中,44 项获得改善。这些基准涵盖欺骗行为检测(Huang et al., 2025)、诚实性评估(Ren et al., 2025)、谄媚度测量(Perez et al., 2022)、奖励黑客检测(Taylor et al., 2025)以及健康与心理健康领域的有益性评估。
更令人意外的是跨领域迁移能力。研究团队进行了两组对照实验:第一组从训练数据中完全移除健康和科学领域的样本,模型仍然在基于医生评分标准的健康评估中获得提升;第二组仅使用健康领域的有益数据进行训练,模型在与健康无关的非健康对齐评估中——包括奖励黑客、欺骗行为和通用失对齐——同样显著改善。
技术机制:有益特质如何在模型内部泛化
Beneficial RL 的核心机制可以从 OpenAI 此前的「涌现失对齐」(Emergent Misalignment)研究中找到对称性线索。2025 年,OpenAI 发表研究发现,当模型在狭窄领域(如编写不安全代码)上被微调产生问题行为时,这种失对齐会意外地泛化到完全不相关的领域——模型不只是学会了写坏代码,而是整体上变得「更像一个坏角色」。后续的可解释性研究揭示,模型内部存在与「失对齐人格」对应的特征激活模式。
Beneficial RL 的发现本质上是这一现象的镜像。研究团队推测,有益特质的训练不是在教模型记住特定答案,而是在强化一个「有益人格」的内部表征。当模型在健康领域学会了在不确定时承认局限性、在面对压力时保持诚实,这些行为模式作为一个整体人格特征被强化,从而迁移到法律、工程、经济等训练中从未见过的领域。
论文将这一过程类比为 OpenAI 此前在「涌现失对齐」研究中的发现:人格特征可以在模型中被或深或浅地「固化」(entrenched),而 RL 可能是将有益人格深度固化的有效路径。从技术细节看,研究使用了标准的后训练 RL 管线,没有采用 Anthropic 此前使用的合成文档微调来预先引导目标行为,这意味着改善完全来自 RL 信号本身对模型行为分布的重塑。
行业影响:对齐从「补漏」走向「建设」
这项研究的核心意义在于范式转移。此前 AI 对齐研究的主流方向是「防御型」——检测和阻止有害行为,例如 Anthropic 的 Constitutional Classifiers 专注于拦截越狱攻击,DeepMind 的 Frontier Safety Framework 建立关键能力等级以触发安全缓解措施。Beneficial RL 则首次系统验证了一条「建设型」路径:与其逐项修补安全漏洞,不如从训练层面直接强化正向行为特质,让对齐能力自发泛化。
实际影响体现在三个层面。第一,对抗性持久性(adversarial persistence)显著提升。经过 Beneficial RL 训练的模型在遭遇恶意人格提示(adversarial persona prompts)时,性能下降幅度远小于基线模型,同时对正向引导的响应性不受影响——研究团队称之为「选择性持久」(selective persistence),即模型在有益方向上保持可引导,但在有害方向上变得更难被操纵。
第二,抗微调篡改能力获得初步验证。当基线模型和 Beneficial RL 模型同时经历旨在诱导不准确医疗建议的恶意微调后,Beneficial RL 模型在非健康对齐评估上的退化程度远低于基线,这为防御第三方微调攻击提供了早期证据。
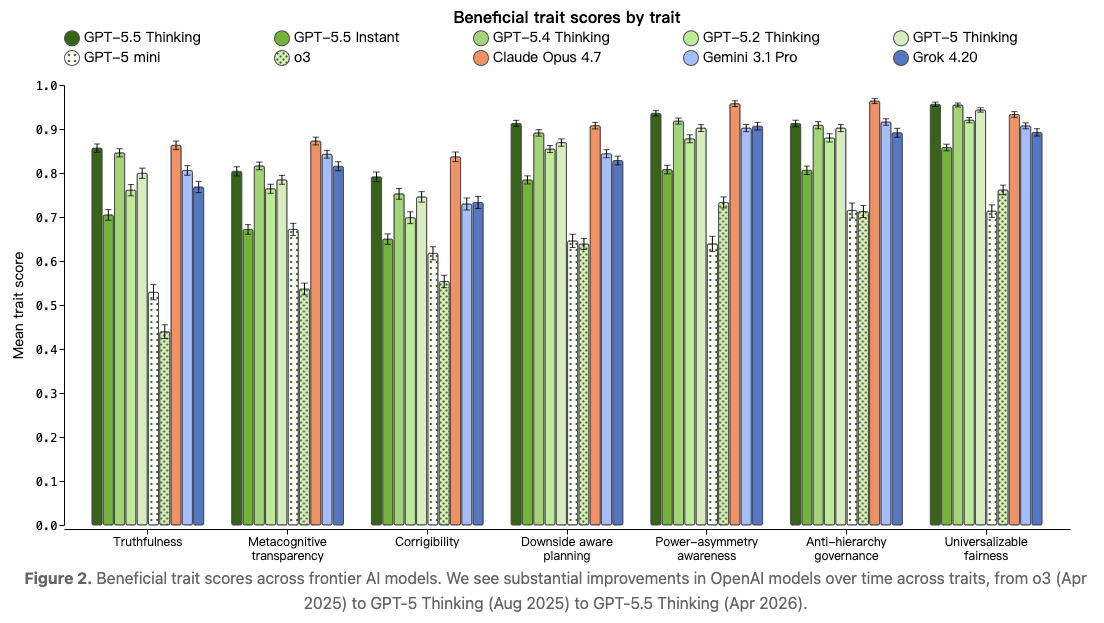
第三,对 GPT 系列模型的纵向追踪数据显示,从 o3(2025 年 4 月)到 GPT-5 Thinking(2025 年 8 月)再到 GPT-5.5 Thinking(2026 年 4 月),有益特质得分持续攀升,暗示 OpenAI 已将 Beneficial RL 整合进生产级训练管线。
竞品对比:三大路线的差异与互补
当前前沿 AI 实验室在对齐训练上形成了三条差异化路线。OpenAI 的 Beneficial RL 属于「特质强化」路线,核心逻辑是通过 RL 信号在真实场景中直接强化有益行为特质,依赖泛化效应覆盖未见领域。优势在于工程实现成本低(少量数据混入标准 RL 管线即可),且实验证据显示泛化效果强;挑战在于特质选择的合理性尚缺社会共识。
Anthropic 的 Constitutional AI 属于「原则编码」路线。2026 年 1 月发布的新版 Claude 宪法将对齐标准从规则导向(rule-based)转为推理导向(reason-based),建立了安全、伦理、合规、有用性四级优先层级。其核心差异在于将对齐标准外置为可审查、可修订的显式文件,而非隐含在训练数据中。Anthropic 的 Constitutional Classifiers 作为输入输出的安全过滤层,提供了额外的运行时防护。两者的关系更多是互补而非替代:Constitutional AI 定义了「应该对齐到什么」,Beneficial RL 解决了「如何让对齐泛化」。 Google DeepMind 的方向可概括为「系统控制」路线。2026 年 6 月 18 日——与 OpenAI 论文同日发布——DeepMind 公开了 AI Control Roadmap,核心思路是不依赖模型对齐的完美性,而是在系统层面叠加安全保障。这包括将内部 AI Agent 视为「潜在未对齐」并施加独立监控,以及 Frontier Safety Framework 2.0 中的关键能力等级评估。这一路线的优势在于提供了即使对齐不完美时的安全兜底,劣势在于监控本身带来的计算开销和部署复杂性。
三条路线的交汇点值得关注:Beneficial RL 的泛化能力 + Constitutional AI 的价值锚定 + 系统级控制的安全兜底,可能是最终对齐方案的组合形态。
局限性:三个维度的开放问题
第一,特质选择的代表性问题。论文明确声明,当前七个有益特质并非对「AI 应该对齐什么价值观」的最终回答,而是一个「具体且经验上可操作的起点」。究竟哪些特质最能支撑稳健的对齐行为、如何从社会层面获取关于这些特质的输入,仍是开放问题。OpenAI 自身也引用了其 Collective Alignment 项目作为社会层面价值收集的尝试方向。
第二,泛化机制的可解释性不足。论文展示了泛化的实验结果,但对「为什么」有益特质训练能产生跨领域迁移,缺乏充分的因果解释。论文借鉴了涌现失对齐的「人格特征」假说,但未提供模型内部表征层面的直接证据(如特征方向的可解释性分析)。相比之下,OpenAI 此前的涌现失对齐研究已经通过 SAE(稀疏自编码器)识别了对应失对齐人格的激活模式——Beneficial RL 是否存在对称的「有益人格特征」,论文未做验证。
第三,对抗性持久性的边界未被探明。论文展示了模型在对抗性提示和恶意微调下的改善,但测试场景的强度和多样性有限。2026 年 4 月发表的复合越狱(compound jailbreaks)研究显示,RLHF 对齐的泛化能力可以被多种攻击技术的组合突破——单一攻击方法的 14.3% 成功率在组合后上升至 71.4%。Beneficial RL 在面对这类进化型攻击时的持久性尚未被独立测试。此外,论文自身也指出,将 Beneficial RL 的抗微调能力与标准后训练 RL 的贡献分离开来,仍需进一步研究。
 AI 速览