比起那些跑分数字,真正让技术圈炸开锅的,其实是一个差点被埋没在技术博客角落里的小细节:GLM-5.2在长程强化学习这个阶段,悄悄放弃了GRPO。
一、智谱为什么要换掉GRPO
想弄明白这次切换意味着什么,得先回头看看GRPO当初是为了解决什么问题而生的。
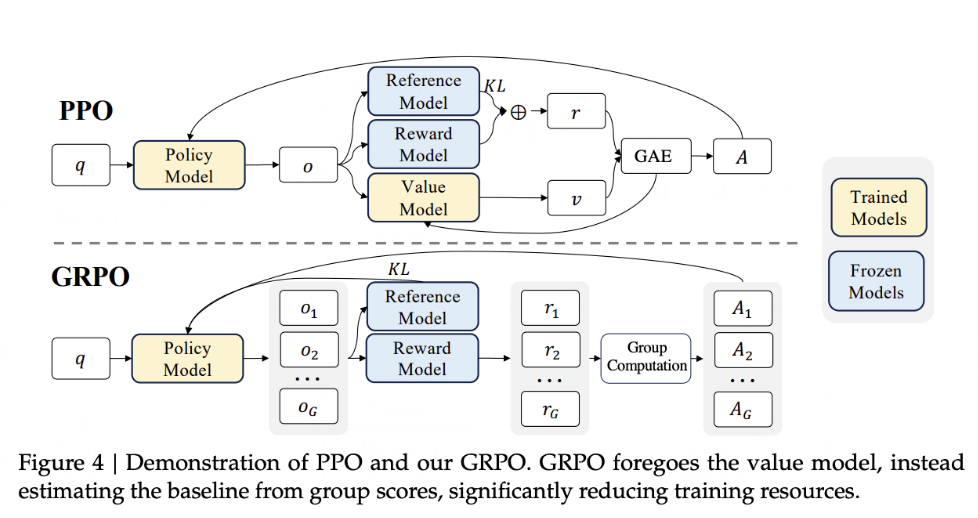
传统PPO需要专门训练一个价值网络(也就是critic),用来预测"当前这个状态未来还能拿到多少奖励",再靠这个预测给每一步动作算出优势值。问题是,这个价值网络的体量和策略模型差不多大,训练成本高,而且稳定性也不太让人省心。
GRPO给出的解法很直接:干脆不训练价值网络了,改成让模型针对同一个问题一次性生成一批(通常是几十个)回答,把这批回答的平均奖励当作基线——谁的得分比组内平均水平高,优势值就是正的。这套逻辑有点像让同一道题的几十名考生同时交卷,然后互相比较打分,不再需要一个全知全能的阅卷老师,矮个子里也能选出相对高的。
对于数学题、单元测试这类对错分明的短任务来说,这种做法既省显存又比较稳,DeepSeek-R1之后几乎成了开源社区默认的标配方案。GLM-5.1的强化学习阶段用的就是这一套,组大小固定在32。 但GLM-5.2这次盯上的是另一类任务——长程智能体任务。根据智谱技术博客透露的信息,这类任务的执行轨迹要比解一道数学题长得多,中间涉及多轮工具调用、子任务拆解,以及跨多轮的环境反馈。一条完整轨迹经过压缩(compaction)处理之后,拆出来的子轨迹无论是数量还是长度都会变得参差不齐。
这恰好戳中了GRPO的软肋:它本质上要求把同一个问题下的一组输出放在一起做比较,可长程任务压缩出来的子轨迹长短不一,有的只有寥寥数语,有的却要拖上几十步,根本凑不出一组能公平比较的样本。要是继续硬套组内比较这一套,大量数据就会变得没法用。
智谱的应对方式是:把价值网络重新请回来。GLM-5.2的长程强化学习阶段,从"群体相对优化"转向了"基于critic的PPO",改用token级别的优势值去适配长短不一的子轨迹——不再靠一组同伴互相打分,而是重新训练一个能给任意一段轨迹独立估值的"阅卷老师"。
配合这次算法调整,智谱借助slime框架把训练流程和大规模推理rollout打通,把十几个专家模型并行蒸馏合并进最终模型,整套流程只花了大约两天时间。针对coding任务里常见的奖励作弊行为(比如直接用curl去拉取参考答案,或者用grep搜索隐藏的测试用例文件),GLM-5.2还专门设计了一套两阶段拦截机制:先用规则做一轮过滤,再交给LLM裁判去识别可疑的工具调用,一旦被拦截,系统会返回一段没有实际意义的"假信息",让训练轨迹能继续往下走,而不是粗暴地直接中断——这样可以避免引发训练不稳定。
简单来说,GLM-5.2这次调整并不是在否定GRPO本身,而是发现GRPO原本依赖的设计前提,在长程智能体任务这个场景里站不住脚了。
二、GRPO到底是不是过时了
如果把这次切换简单归结为"GRPO不行了",多少有点偷懒。
GRPO当年能火起来,本来就是为了解决一个很具体的问题:在有明确对错标准的可验证任务上,用尽可能少的显存、尽可能稳的方式去做强化学习。这件事它现在依然做得不错。像数学题、代码单元测试、格式校验这类短任务,正确答案本来就藏在采样出来的那组结果里,组内比较的成本优势依然成立。也正因如此,GSPO、DAPO这些变体方法,现在做的依然是在MoE训练、长思维链场景下继续打磨GRPO的细节毛刺,而不是直接给它判"死刑"。
一个很说明问题的例子,就是GRPO最初的提出者自己。今年4月发布的DeepSeek V4技术报告显示,DeepSeek在训练数学、代码、Agent、指令跟随等各个领域的专家模型时,用的依然是GRPO,只是在把多个专家模型合并回一个统一模型这一步,换成了一种名为"在策略蒸馏"(On-Policy Distillation)的新方法。
也就是说,GLM-5.2真正换掉的,其实是GRPO在另一类任务上的适用性——那种多轮、长程、奖励稀疏且反馈延迟的智能体任务。在这类任务里,"这一步到底做得好不好"往往要等到几十步之后,才能从最终结果倒推回来判断,而且不同任务跑出来的轨迹长短差异巨大,很难凑出一组"条件相同"的样本去做组内对比。
这种判断并不只是工业界这一轮实践经验的总结,学术界也有对照实验作为支撑。去年底一篇论文《Learning Without Critics?Revisiting GRPO in Classical Reinforcement Learning Environments》专门做了相关测试,结果显示:在没有提前终止机制的长程任务中,不依赖critic的方法持续不如带有学习到的价值函数的PPO;只有在CartPole这类短程任务里,组内比较的方式才能和PPO打个平手。
这个学术结论,和GLM-5.2这次的算法选择,恰好是从工业实践和学术实验两条完全不同的路径,走向了同一个判断。
所以或许更准确的说法是:强化学习算法的选择,正在变得越来越依赖具体任务,不再存在一个放之四海而皆准的"默认选项"。短程、可验证的任务,GRPO及其各种变体依然够用、依然划算;但到了长程智能体任务,价值网络又重新变得不可或缺。
GLM-5.2这次引发的讨论之所以有分量,是因为它第一次把这条分界线摆上了公开的技术博客,让一个原本只存在于小圈子传闻里的判断——前沿实验室可能压根没打算靠GRPO一条路走到长程任务——有了一个开源、可复现、可供外界验证的对照样本。
过去两年里,GRPO几乎成了开源大模型强化学习阶段的代名词,被当作一种"便宜又好用"的默认信仰。而GLM-5.2的这次选择提醒了大家,这种信仰本身是有边界的——它诞生于数学题和单元测试构成的世界里,而如今的智能体,正被推向需要连续工作好几个小时甚至更久的真实任务场景。
对整个行业来说,这次算法切换的意义,或许已经超过了1M上下文窗口或者基准跑分本身。它说明,随着开源模型从"答题选手"逐渐转型为"干活的智能体",后训练阶段的算法选型也得跟着任务形态一起演化,而不能一直停留在某一篇论文当年定下的范式里。
下一次范式松动会出现在哪个环节,目前谁也给不出确切答案,但可以肯定的是,这场围绕强化学习未来走向展开的讨论,才刚刚拉开序幕。
 AI 速览