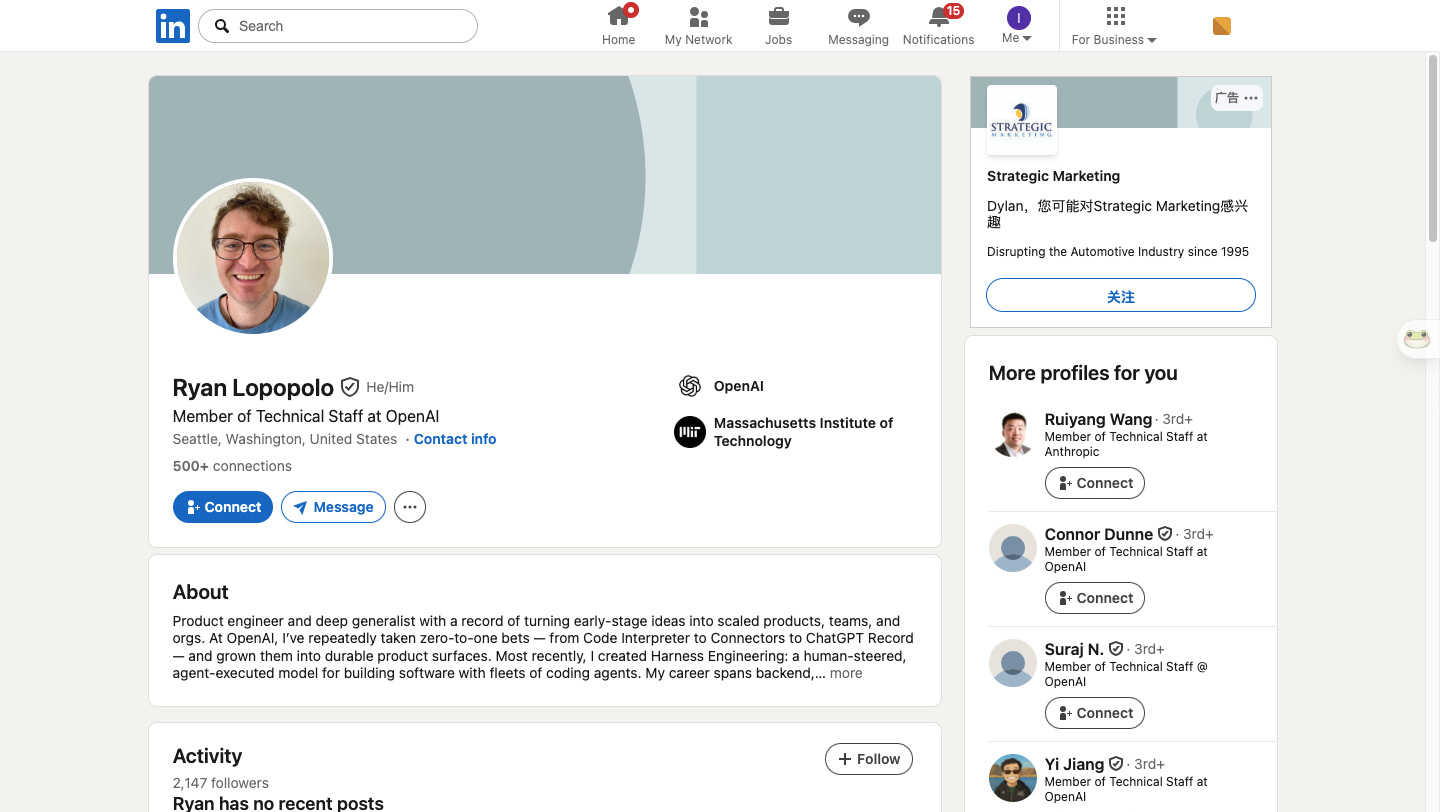
在 2026 年的一场伦敦技术会议上,OpenAI 技术团队成员 Ryan Lepopolo 发表了关于 Harness Engineering 的主题演讲,分享了他过去 9 个月完全通过 Agent 构建软件的经验。核心观点直白且激进:代码已经不再是稀缺资源,稀缺的是人类注意力、模型上下文窗口和正确的约束条件。
代码免费:不再需要手写,只需正确引导
Lepopolo 的演讲起点是一个大胆的实践:他禁止团队成员触碰编辑器,所有工作必须通过 Agent 完成。
"Code is free. We have an abundance of code to solve the problems."
他认为,随着 GPT 5.2 及后续模型的能力提升,模型在代码生产质量上已与人类工程师等价(isomorphic)。代码的生产、维护、重构和删除都不再是瓶颈——模型可以无限并行、无比耐心。
在这一前提下,工程师的核心技能正在从"写代码"转向系统思考、系统设计和任务委派。每个工程师都可以获得 5 倍、50 倍甚至 5000 倍于自身的编码产能,关键在于如何有效部署这些产能。
三种稀缺资源
Lepopolo 提出,在新的开发范式下,稀缺资源只有三种:
- 人类时间:同步参与的价值越来越高,应集中于高杠杆活动
- 人类与模型的注意力:注意力是有限资源,需要结构性保护
"在这个世界里,你的角色是弄清楚如何让你的 Agent 团队和驱动它们的人类,能够推动它们完成长时间跨度的完整工作。"
传统开发模式下,任务按优先级排队——P3 级别的需求永远做不完。但在代码免费的世界里,所有 P3 可以同时启动,并行生成多个方案,选最优的合并。
Harness Engineering:为 Agent 搭建的执行框架
Lepopolo 将 Harness Engineering 定义为"构建系统、软件和结构,使你的团队(包括 Agent)能够取得成功"。核心不是让 Agent 更聪明,而是让你的代码库对 Agent 更友好。
具体做法包括:
让代码库对 Agent 可读
代码也是提示词。代码在文件系统中的排布方式、命名规范、架构边界,都是 Agent 理解系统的输入。Lepopolo 建议将仓库按照业务逻辑领域或技术栈层拆分,使其能够通过目录子树范围定位大部分变更。
统一就是效率
应有一致的并发辅助函数、一致的副作用命令构造方式、一致的 ORM、一致的编程语言、一致的 CI 脚本写法。因为一致性意味着模型在任何位置都能获得可迁移的上下文,token 产出更可预测。
把非功能需求写下来
一个补丁做"好"可能需要 500 个微小决策——涉及边界条件、错误处理、安全、可维护性等非功能需求。模型已经在训练中见过数万亿行代码,见过所有这些选择。工程师的任务是明确写出这些非功能需求是什么,让 Agent 能看到什么是"可接受的好代码"。
Reviewer Agent:用代码审查代码
Lepopolo 团队在 CI 中部署了专门的 reviewer agent,在每次推送时自动审查代码。它们基于团队写下的文档,检查诸如"这段网络代码有没有超时和重试?""接口设计是否安全到不可误用?"
他分享了一个真实场景:他本人曾在修复网络代码 bug 时加上超时和重试,合并后就不再关注——这不是人类可靠的审查方式。但花时间写一份文档和一个自定义 lint 规则,让它在每次调用 fetch 时自动检查超时和重试,问题就被系统性地永久解决了。
"我们可以对这种非功能需求的错误类进行分类,设计系统性解决方案,然后持续观察和优化。"
他还提出了一个更高级的技巧:写关于源代码的测试。比如,写一个测试来限制单个文件不超过 350 行——这是在为模型适应代码库做适配工程。
技能策略:少而精,而非多而杂
Lepopolo 的团队将技能集中在 5 到 10 个核心技能上,而不是追求数量。原因是仓库内的本地开发工具变动频繁,他没有精力持续跟踪所有变化。将所有复杂性隐藏在技能之下,让 Agent 自己去发现和适应。
一个有趣的例子:团队从直接使用 Chrome DevTools Protocol 切换到一个 daemon 中间层,Lepopolo 直到三周后才知道这件事——因为 Codex 基于已有的文档和技能,已经能正常完成工作。
"如果你发现自己需要不断对 Agent 输入 continue,那就是 Harness 失败的标志——它没有提供足够的上下文让 Agent 自主完成。"
代码审查的自动化闭环
在 Agent 产出量极大(每个工程师每天 3-5 个 PR)的情况下,代码审查成为了瓶颈。Lepopolo 的解决方案是**"垃圾回收日"(Garbage Collection Day)**:
每周五,团队不写新代码,而是复盘本周观察到的所有"slop"(低质量代码模式),找出导致 PR 难以合并的根源,然后通过文档、lint 规则或 reviewer agent 将其系统性消除。这是一个闭环:人类在 PR 上给出的审查反馈 → 表明 Agent 存在上下文失败 → 将该知识写入仓库 → 自动注入到 Agent 的提示中。
最终形态是:每个工程师按照其专业身份(前端架构师、可靠性工程师、可扩展性专家)各自维护一份文档,对应一个 reviewer agent,在每次推送时自动运行,判断"这段代码是否足够好"。
代码是"可丢弃的构建产物"
当被问及"代码是否是可丢弃的构建产物"时,Lepopolo 给出了明确的肯定回答。他将 LLM 类比为模糊编译器(fuzzy compiler)——Harness Engineering 中的所有上下文和约束条件,本质上就是编译过程中的优化传递。
"将模型 A 换成模型 B,就像在 Rust 编译器中把 LLVM 后端换成 Cranelift。你期望所有关于可接受 Rust 代码的规则,仍然能产生有效、可靠的目标代码。"
未来愿景:Token 预算 + 一个季度的工作
Lepopolo 设想的未来是:给定一个 token 预算和一个季度(甚至半年)的工作目标——由人类定义优先级、成功指标和可靠性指标——交给机器持续推进产品前进。
"我最终的目标是,不再需要每次点击 continue。每次你不得不与 Agent 交互,都是 Harness 的失败。"
在这个未来里,软件工程的范围将不只限于写代码,还包括:处理用户反馈、处理告警事件、确保生产日志不泄露 PII、维护社交媒体口碑、编写 runbook 支持客服团队。当代码不再是瓶颈,工程师的注意力将转移到这些更高层次的"元编程"活动上。
给新手的建议
对于刚开始使用编码 Agent 的团队,Lepopolo 给出了两条路径:
- 用 Agent 提升现有代码的信心:Agent 非常擅长根据现有代码和上下文编写测试,这既能提升代码质量,也能增加 Agent 未来成功导航代码库的能力
- 审视你的时间花在哪:是盯着编辑器写代码?等待测试运行?等待审查?如果 CI 慢、测试不稳定,先用 Agent 逐步自动化这些环节
最终目标是让自己从执行者变为编排者——定义工作、排定优先级、赋能团队执行。
 AI 速览