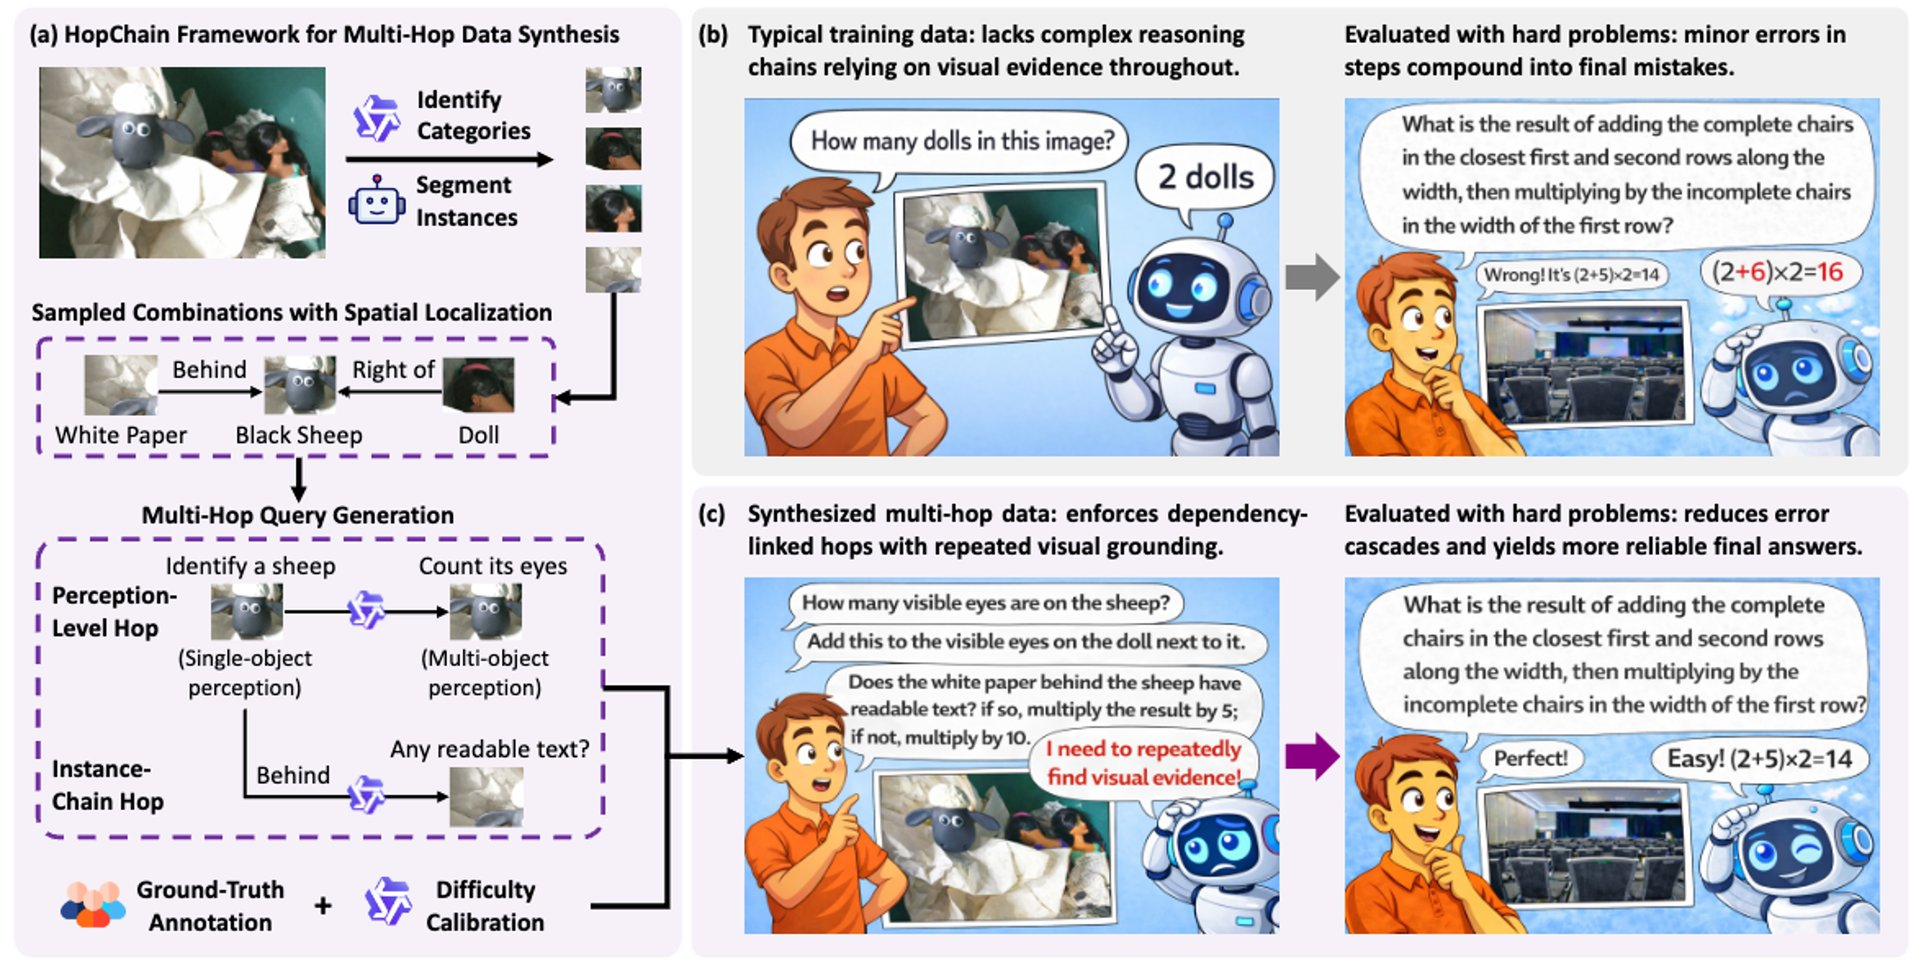
视觉语言模型(VLM)在多模态理解领域取得了显著进展,但在需要精细化、多步骤视觉推理的任务中仍然表现不佳。阿里巴巴Qwen团队与清华大学LeapLab联合发布的最新研究HopChain,正是针对这一核心瓶颈提出的系统性解决方案。该论文于2026年3月19日发布在arXiv上,提出了一种可扩展的多跳视觉语言推理数据合成框架,用于VLM的强化学习训练。
长链推理中的复合错误问题
研究团队首先深入分析了VLM在长链思维推理(long CoT)中的失败模式。他们发现,当推理链条变长时,模型会暴露出四类主要错误:感知错误(如错数瓢虫身上的斑点数量)、推理错误(如将倒车入库误判为驶出车位)、知识错误和幻觉错误。更关键的是,这些错误会在推理链中逐步累积——一个中间步骤的视觉判断失误会导致后续所有推理步骤在错误基础上继续推进,最终产生错误的答案。
研究团队在论文中展示了多个典型案例。例如,在一道要求数出所有瓢虫斑点总数的题目中,基线模型在多只瓢虫的斑点计数上分别出现偏差,导致最终总数错误。在另一个天文图表理解任务中,模型将标注C指向的最高弧线误判为中间弧线,从而给出了错误的季节判断。这些案例横跨自然图像、图表和科学示意图,但共享同一结构:某个中间步骤的视觉感知失误沿推理链向下传播。
HopChain的核心设计
针对这一挑战,HopChain提出了一种结构化的多跳查询设计。每个合成的多跳问题都形成一条逻辑依赖链,其中前面的"跳"为后续"跳"建立所需的实例、集合或条件,迫使模型在每一步都必须重新进行视觉定位和验证。
框架定义了两种互补的跳转类型。感知层级跳转在单目标感知(如读取文字、识别颜色)和多目标关系推理(如比较大小、计数满足条件的对象)之间切换。实例链跳转则沿着明确的依赖链(如实例A→B→C)推进,每个新实例只能通过前序实例建立的信息来定位。每个查询必须同时包含两种跳转类型,且最终答案必须是一个明确的数值,便于强化学习中的可验证奖励机制使用。
四阶段数据合成流程
HopChain采用了可扩展的四阶段数据合成流水线。第一阶段通过Qwen3-VL-235B-A22B-Thinking识别图像中的语义类别。第二阶段使用SAM3进行实例分割,将语义类别解析为具有空间定位信息的具体实例。第三阶段由大模型对3至6个实例的组合生成多跳查询,每个查询需满足严格约束,包括尽可能涉及所有给定实例、仅通过空间和视觉属性描述对象、最终答案为明确数值、禁止引用分割掩码或边界框等。第四阶段引入人工验证与难度校准,四名标注员独立解答每个查询,只保留所有人答案一致的样本,并过滤掉弱模型能100%正确回答的过于简单的题目。
实验验证与广泛提升
研究团队在Qwen3.5-35B-A3B和Qwen3.5-397B-A17B两个模型上验证了HopChain的有效性,评测覆盖24个基准测试,横跨STEM与谜题、通用视觉问答、文本识别与文档理解、视频理解四大类别。结果显示,在两个模型上,添加多跳数据后均有20个基准测试获得提升。
在Qwen3.5-35B-A3B上,MathVision从73.71提升至76.05,CharXiv从69.00提升至73.10,InfoVQA从87.44提升至90.17,EMMA从53.00提升至58.00。在更大的Qwen3.5-397B-A17B上,提升同样显著:BabyVision从28.61提升至32.22,ZeroBench从4提升至8,VideoMME从78.30提升至80.41,VideoMMMU从78.89提升至80.00。值得注意的是,尽管多跳数据完全基于图像合成,但在视频理解基准上也实现了强劲迁移,两个模型各有5/6项视频基准获得提升。
消融实验证明完整链条的必要性
为验证完整多跳结构的重要性,团队进行了消融实验。将完整多跳查询替换为仅保留最后一跳的单跳版本后,五个代表性基准的平均分从70.4降至64.3;保留后半部分链条的半多跳版本平均分为66.7。这一持续的性能递减证明,保持完整的跨跳依赖关系对训练效果至关重要。
按推理长度分析的结果进一步揭示,多跳数据的优势在超长CoT区域尤为突出,在Qwen3.5-397B-A17B上的准确率提升超过50个百分点。错误类型分析则表明,多跳数据修正的错误类型分布与基线错误分布高度一致,涵盖感知、推理、知识和幻觉等多种类别,说明HopChain带来的是广泛而非局部的能力提升。
技术意义与局限性
HopChain的核心贡献在于将"多跳视觉推理"从评测目标转化为训练信号。通过在强化学习训练中结构性地迫使模型在每一步都寻求视觉证据,该框架有效缓解了长链推理中的复合错误问题,实现了跨领域的泛化提升。该框架目前依赖成功的实例分割,无法处理没有可检测目标的图像,团队表示未来将引入互补的数据构建路径以覆盖更广泛的图像类型。项目代码已在GitHub开源。
 AI 速览